
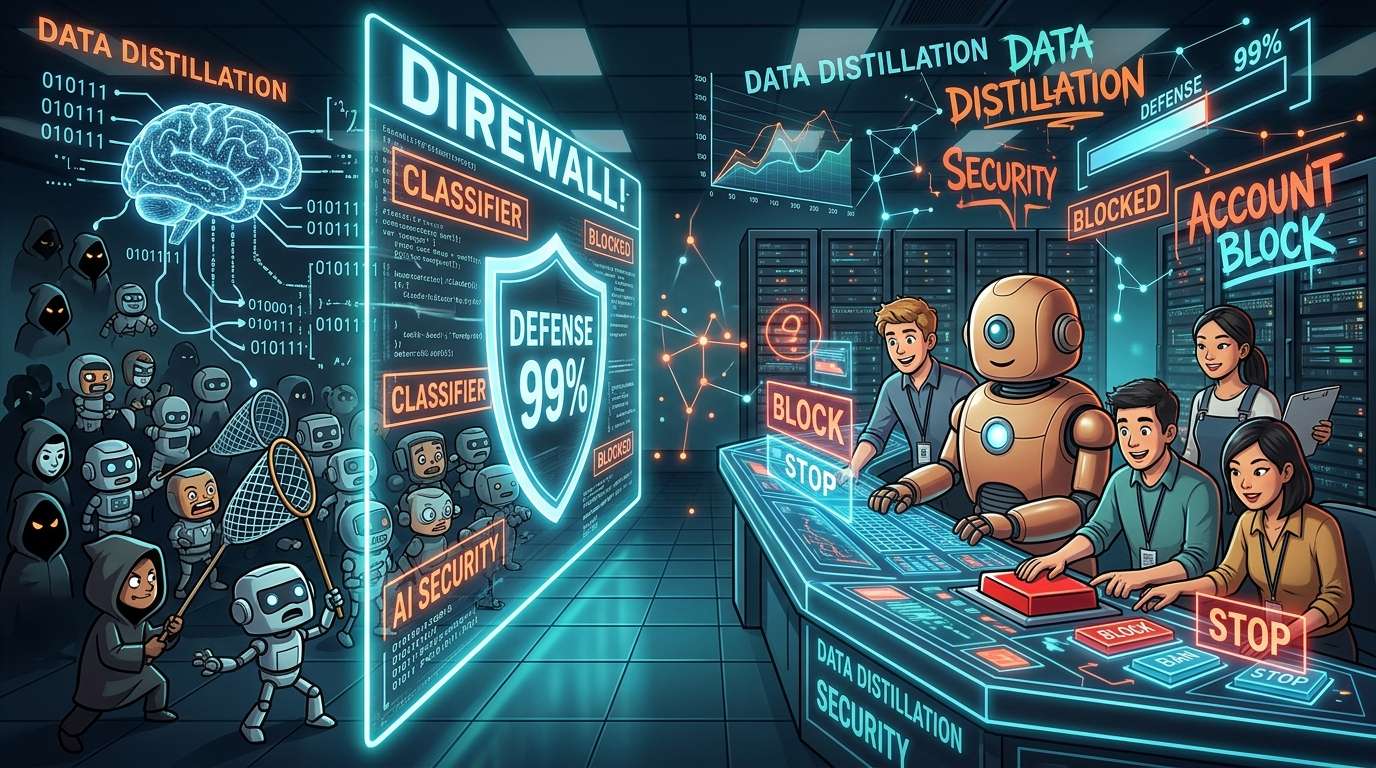
Anthropic ha spiegato di aver rafforzato le difese contro i tentativi di sottrarre in grandi quantità le informazioni che mostrano il processo di ragionamento dell’IA conversazionale Claude (i token di ragionamento), riducendo del 90-99% la quantità estratta. Oltre a limitare l’accesso alle informazioni sul ragionamento, ha attivato un classificatore capace di individuare i segnali di estrazione e introdotto un sistema che sospende automaticamente gli account coinvolti. Finora, gli account sospesi sarebbero decine di migliaia.
Come impedire gli accessi massicci a Claude
All’origine della vicenda c’è la «distillazione», una tecnica che consiste nell’addestrare un modello diverso e più piccolo usando come materiale didattico le risposte di un modello di IA potente. È una tecnica legittima, usata per rendere più leggeri i propri modelli, ma può anche essere impiegata per inviare un gran numero di domande ai modelli di altre aziende e copiarne le capacità nel loro complesso, basandosi sulle risposte. È questo tipo di estrazione organizzata, come quella descritta in quest’ultimo caso, a destare preoccupazione in Anthropic.
Secondo quanto riferito dall’azienda, gli attaccanti utilizzano una rete composta da centinaia di migliaia di account falsi. Ogni singolo account è mantenuto a un livello tale da sembrare quello di un utente normale, mentre nel complesso vengono raccolte enormi quantità di risposte. Una tattica che si potrebbe definire «guerra di account», anziché di logoramento.
L’obiettivo sono i token di ragionamento, ovvero i passaggi interni che il modello compie prima di arrivare a una risposta. Se si riesce a ottenere non soltanto la risposta finale, ma anche il filo del ragionamento, si può insegnare a un altro modello «come pensare». Per usare una metafora culinaria, è come sottrarre non solo il gusto del piatto finito, ma anche l’intera ricetta, passo dopo passo.
Le contromisure adottate da Anthropic sono principalmente tre: limitare l’accesso ai passaggi interni del ragionamento di Claude; utilizzare un classificatore per individuare i tentativi di estrazione; e sospendere automaticamente gli account giudicati sospetti.
I risultati delle contromisure e i loro limiti, in cifre
Anthropic afferma che, dopo l’attivazione delle difese, la quantità di token di ragionamento estratti è diminuita del 90-99%. L’azienda sostiene inoltre che, dall’introduzione delle contromisure, anche i casi di distillazione riuscita sono calati nettamente. La percentuale è espressa in un intervallo, ma la tesi è che il fenomeno sia stato contenuto almeno al di sotto di un decimo del livello precedente.
Un altro aspetto da non trascurare è l’effetto collaterale riconosciuto dalla stessa azienda: anche gli utenti legittimi possono finire nel mirino dei sistemi di rilevamento. Più si infittisce la rete per bloccare le attività illecite, più rischiano di rimanervi impigliati anche persone e aziende che utilizzano il servizio normalmente. Questa conseguenza inevitabile delle misure di sicurezza non fa eccezione nei servizi di IA.
Il comportamento di sviluppatori che fanno un uso intensivo del servizio o di sistemi aziendali che integrano strumenti automatizzati può talvolta assomigliare ai segnali di un tentativo di estrazione. In futuro, l’equilibrio tra la solidità delle misure antiabuso e la necessità di non ostacolare l’uso normale influirà sulla facilità d’uso del servizio.
Che cosa significano le accuse rivolte a specifiche aziende
Questa volta Anthropic ha indicato le aziende cinesi Zhipu (智譜) e Moonshot come soggetti coinvolti. Secondo quanto sostiene l’azienda, Zhipu avrebbe attinto alle capacità legate alla cybersicurezza dei principali modelli statunitensi per utilizzarle nel proprio GLM-5.3. Anthropic accusa Moonshot di aver fatto passare di nascosto le richieste attraverso Claude. Si tratta in entrambi i casi di affermazioni di Anthropic: nei materiali diffusi questa volta non è stato possibile verificare la posizione delle due aziende.
Anthropic ha inoltre menzionato la possibilità che le capacità sottratte in questo modo finiscano nei sistemi militari o di sorveglianza di paesi stranieri. Colpisce il fatto che la questione venga presentata non come una semplice imitazione commerciale, ma come un problema di sicurezza nazionale.
In un’altra iniziativa, l’azienda ha invitato anche gli altri sviluppatori di IA ad adottare misure difensive analoghe. Se una sola azienda rafforza le proprie difese, ma le informazioni vengono sottratte attraverso un altro ingresso, l’efficacia è limitata. La sfida è capire se l’intero settore riuscirà a procedere in modo coordinato.
La competizione nell’IA generativa si sta estendendo dalla sfida di creare modelli intelligenti a quella di capire chi li usa e come, e di controllarne l’impiego. Tecniche difensive poco appariscenti, come il rilevamento degli account falsi e le limitazioni degli accessi, sembrano destinate a incidere sempre più sulla competitività delle aziende di IA.
コメント