
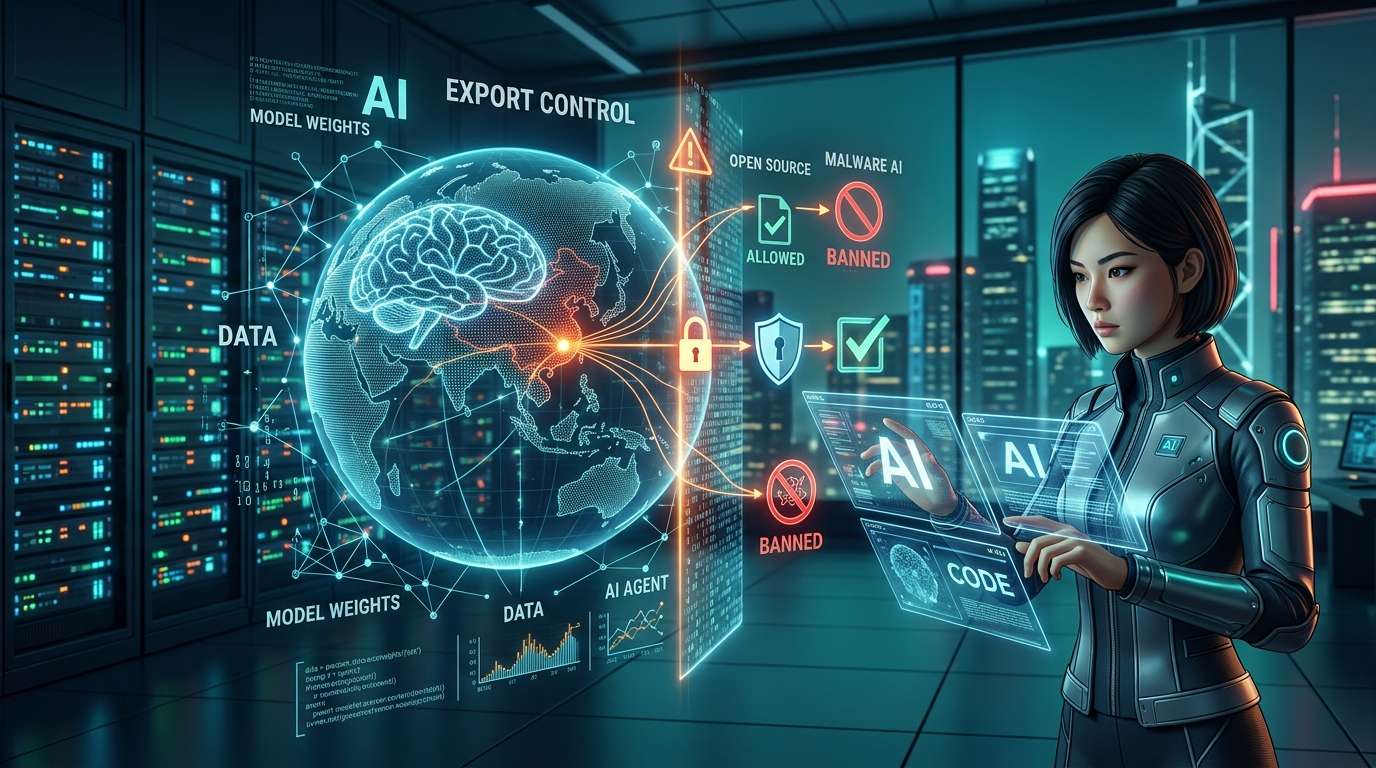
中國商務部與科技部公布《禁止、限制出口技術目錄》修訂草案,涵蓋大型模型、AI 代理、計算叢集、資料處理等 23 個重點領域。草案規定,可自主建立或修改惡意軟體的 AI 禁止出口;已公開的技術則不在管制範圍內,並納入一套開源發布只要登記即可獲准的機制。目前仍處於草案階段,最終規則尚未定案。
管制網罩住的不是「效能」,而是「內涵」
這份草案引人注目之處,在於管制範圍不只涵蓋模型本身,也延伸至打造模型所需的一整套技術,包括權重、檢查點、原始碼、架構,以及訓練和推論方法。這種思維與其說是管制成品出口,不如說是連配方和廚房都要一併管控。
所謂權重,是指 AI 經過訓練後取得、相當於「記憶」的一組數值。只要取得權重,就幾乎能在自己的環境中重現該模型。正因如此,各國開始將權重列為出口管制的焦點。
管制啟動的三道門檻
模型核心技術符合以下三項條件之一,就會受到管制:訓練所用的計算量達 10^26 FLOPs 以上、參數量達 2 兆以上,或排名全球前 10。
是否名列前 10,將由出口管制主管機關參考國內外主要評測機構及業界平台公布的排名來判定。草案列出的評估面向包括整體效能、個別任務、安全性,以及全球使用規模。除了數值門檻,也納入了排名這項會變動的指標,這一點不容忽視。新模型一旦加入榜首之爭,就可能進入管制範圍。
以重要資料訓練的模型也納入管制
另一個管制切入點是資料。若大型模型使用中國《資料安全法》等法規所定義的「重要資料」進行訓練,並提供以該資料為基礎的服務,也會納入出口管制範圍。
草案也詳細列出例外情況。依法公開的資料不在管制範圍內。此外,若資料事先經過清理、不會出現在 AI 輸出中,且不會大幅提升該領域核心技術的研發能力,則可使用不超過 0.1% 的少量資料。以數字劃定界線,也為實際執行保留了彈性。
禁止出口的 AI 與受限制的 AI
草案中最嚴厲的措施,是禁止出口攻擊型 AI。這類 AI 工具能自主撰寫或改寫惡意軟體,並以重要基礎設施、軍方及政府機關為攻擊目標。
另一方面,用來發現軟體漏洞的 AI 工具不會被全面禁止,而是列入新的出口限制。尋找漏洞的技術既可用於防禦,也可用於攻擊。草案將禁止與限制分開處理,可視為依據這種雙面性劃定界線。對資安產業而言,限制範圍究竟到哪裡,可能會成為未來實務上的焦點。
保護開源的快捷通道
草案看似要收緊出口,但也設有加速通道。若將受限制的 AI 技術或權重以開源方式公開,即可適用自動許可。企業在海外營運自有資料中心、將晶片設計資料交由海外製造、與外國夥伴共同研究,或參與制定國際標準,也適用相同待遇。提交必要文件後,符合條件的出口即可獲准。
過去幾年來,中國開發的開源模型已獲得全球開發者廣泛採用。這套程序也流露出不希望阻斷此一趨勢的意圖。此外,已透過開源或論文公開的 AI 技術,不在新規則適用範圍內。換言之,已經公開的內容不會再被追究。
區分「使用」與「帶走」
實務上真正產生影響的,可能是依使用方式作出的區分。即使是受限制的模型,只要透過 API、應用程式、網站或 SaaS 使用,就不受出口管制。在終端裝置上運行的輕量版也一樣。只要海外使用者透過聊天功能試用,或將模型整合至自家服務中,就不會觸及規則。
另一方面,若要將受限制的技術部署在海外的本地伺服器上,就必須取得一般出口許可。不過,若是在自營的海外雲端上運行,則可採用簡化程序。也就是說,界線並非依「誰能存取」劃分,而是看「技術實體放在哪裡」。
這項區分對海外企業而言意義不小。若草案最終定案,將中國製模型納入自家環境中運行,便會成為一條以取得許可為前提的途徑。
美國的鏡像,以及歐洲的難題
OpenAI 戰略未來部門主管 Dean W. Ball 將這次動向解讀為:中國並非要封閉開放權重模型,而是讓政府保留在必要時叫停未來模型的空間。他認為,這與美國已實施的模型權重出口管制形成「鏡像」關係。
若這種局面持續發展,仰賴開放權重 AI 的美國企業,預料將更加傾向採用本國模型,而非中國製模型。處境更艱難的則是歐洲。歐洲一直規劃透過在區域內的雲端運行開放權重模型,維持自主性。然而,若具影響力的開放模型來源集中在中美兩國,且可能隨時因出口管制而中斷,這項策略的前提就會動搖。
「開放」一詞容易讓人以為人人都能自由使用。然而,這種自由仍會受到供應來源國政策的左右。如今或許已進入一個不再只是「開放或管制」二選一,而是連通往開放的路徑也由制度加以設計的時代。
全球南方與程序現況
草案也提出支援全球南方發展 AI。以能力建構、技術共享及共同制定規則為目的的出口,將在中國發起的世界人工智慧合作組織架構下獲得簡化。這個組織被定位為對抗西方主導 AI 相關機構的力量。
在最終規則生效之前,企業必須透過商務部入口網站,登記受影響的出口項目。
コメント