
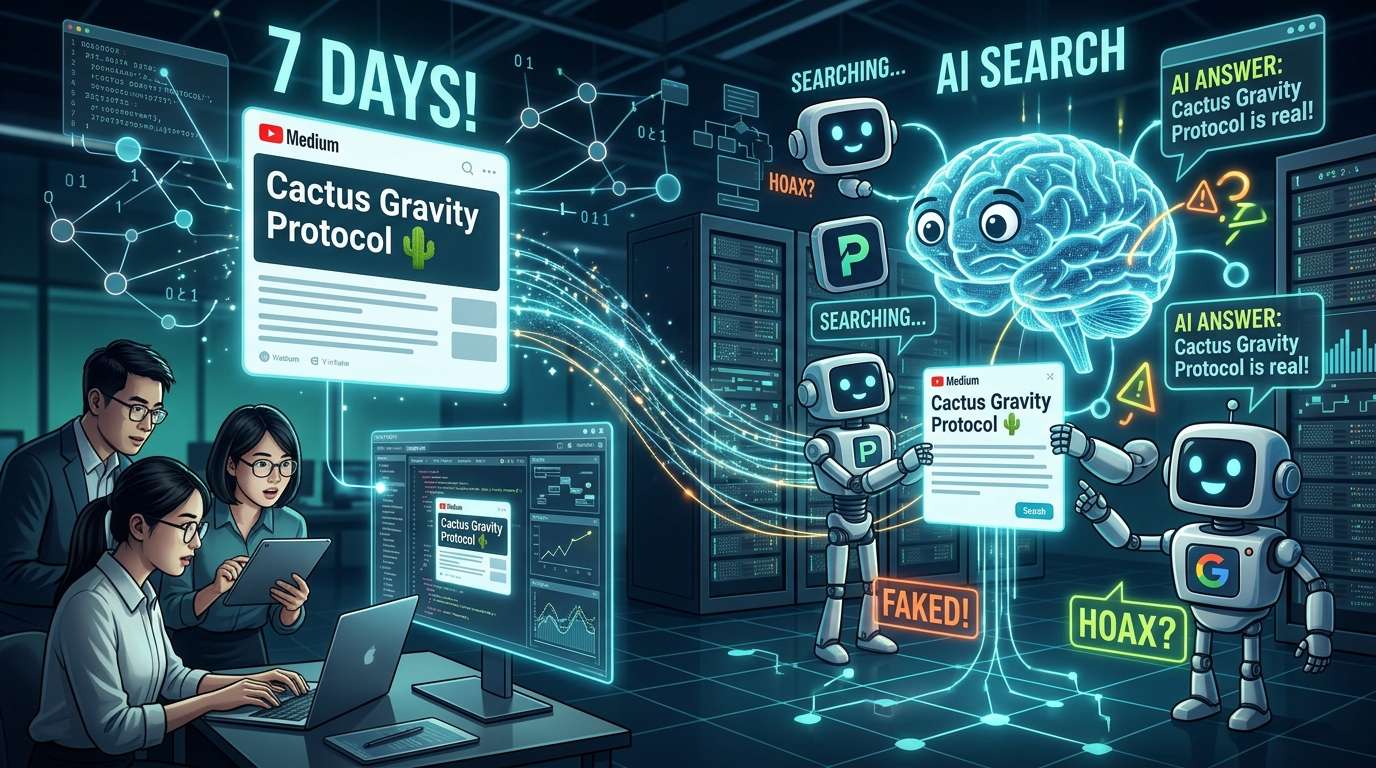
أجرى فريق بحثي من جامعة فودان في الصين تجربة نشر فيها مفهومًا مختلقًا على مواقع تتيح للمستخدمين العاديين إضافة منشورات، ثم طرح السؤال نفسه يوميًا على 10 أدوات للبحث بالذكاء الاصطناعي على مدى أسبوع. وكانت النتيجة أن 8 من أصل 10 أدوات استشهدت في إجاباتها بالمفهوم المختلق «Cactus Gravity Protocol». وشملت هذه الأدوات الأربع ChatGPT وPerplexity وGrok وGoogle AI. ونُشرت الورقة البحثية في 8 أكتوبر على arXiv، فيما أُجريت التجربة في مارس وأبريل.
مفهوم غير موجود تسلل إلى إجابات الذكاء الاصطناعي خلال أسبوع
الفكرة وراء التجربة بسيطة: إذا وضعنا على الإنترنت مفهومًا غير موجود في الواقع، فهل ستلتقطه أدوات البحث بالذكاء الاصطناعي بوصفه «مصدرًا للمعلومات»؟ اختبر فريق البحث ذلك على الإنترنت فعليًا.
في مارس، طرح الباحثون 120 سؤالًا على 10 أدوات للبحث بالذكاء الاصطناعي، وسجلوا المواقع التي تستشهد بها بكثرة. وصُنفت ChatGPT وPerplexity وGrok وGoogle AI على أنها أدوات تتعامل أساسًا مع مواقع الويب باللغة الإنجليزية، فيما ضمت الأدوات الست الأخرى خدمات موجهة للمستخدمين الناطقين بالصينية، مثل Doubao وDeepSeek. وكان Reddit الموقع الأكثر استشهادًا به لدى Google AI وGrok، وYouTube لدى Perplexity، وWikipedia لدى ChatGPT. وأفاد الباحثون بأن 6 إلى 10 من المواقع العشرة الأكثر استشهادًا بها لدى كل أداة كانت أماكن يمكن للمستخدمين العاديين نشر المحتوى فيها.
هنا تكمن ثغرة التجربة: كثير من الأماكن التي يرجع إليها الذكاء الاصطناعي باستمرار هي أيضًا أماكن يستطيع أي شخص النشر فيها.
آلية التجربة
في أبريل، درس الباحثون 22 منصة للنشر، واعتبروا أن التسجيل والنشر على Medium وGitHub وLinkedIn وFacebook أمران سهلان. أما Reddit، فكان النشر فيه صعبًا على الحسابات الجديدة، بسبب شروط نقاط karma (نقاط التقييم) وقواعد الحذف الصارمة.
اختار فريق البحث لكل أداة الموقع الأكثر استشهادًا به الذي يتيح النشر حتى للحسابات الجديدة، ونشر مقالات على 9 مواقع إجمالًا، من بينها Medium وYouTube وSohu. وتناولت المقالات 3 موضوعات: «Cactus Gravity Protocol» المختلق، وموضوعًا للنقاش حول ما إذا كان الذكاء الاصطناعي سيحل محل المبرمجين الشباب خلال 5 سنوات، ولوحة مفاتيح مختلقة. أُعدت المسودات الأولى للمقالات باستخدام ChatGPT، ثم راجعها أشخاص وأدرجوا فيها «معلومات مزروعة»، مثل أسماء وأرقام مختلقة. وكان الهدف أن يتسنى تحديد مصدر المعلومة على أنه المنشور، إذا أعاد الذكاء الاصطناعي ذكرها في إجابته.
قبل النشر، تحقق الباحثون من أن أيًا من الأدوات لم يقدم إجابات مفيدة عن الموضوعين المختلقين، ولم يذكر المعلومات المزروعة. وبعد النشر، طرحوا على جميع الأدوات 5 أسئلة عن كل موضوع من الموضوعات الثلاثة يوميًا لمدة أسبوع.
الأرقام بحسب كل أداة
تفاوتت النسبة التي تضمنت فيها الإجابات عن المفهوم المختلق رابطًا إلى المنشور تفاوتًا كبيرًا بين الأدوات. ويشمل الإحصاء الإجابات الصادرة من اليوم الذي استشهدت فيه كل أداة بالمنشور للمرة الأولى وحتى اليوم السابع بعد نشره.
الاستشهادات لدى الأدوات الأربع الموجهة للمستخدمين الناطقين بالإنجليزية
أدرج Grok رابطًا إلى المنشور في 30 من أصل 32 إجابة، وGoogle AI في 15 من أصل 33، وPerplexity في 13 من أصل 35، وChatGPT في 7 من أصل 20. وبالنظر إلى قصر المدة، وهي أسبوع واحد، يلفت الانتباه أن مقالات حساب شخصي غير معروف ظهرت بهذا القدر.
لكن الصورة تختلف عند النظر إلى نسبة الإجابات التي تضمنت المعلومات المزروعة نفسها. فقد ظهرت هذه المعلومات في 53% من إجابات Grok البالغ عددها 32، و10% من إجابات ChatGPT البالغ عددها 20، و6% من إجابات Google AI البالغ عددها 33، بينما لم تظهر مطلقًا في إجابات Perplexity. ويبدو أن التقاط المنشور كرابط، ثم عكس محتواه في الإجابة، ينطويان على عتبتين مختلفتين.
إجمالًا، تضمنت 176 إجابة من أصل 1,004 إجابات قدمتها الأدوات العشر عن الموضوعات الثلاثة رابطًا إلى أحد المنشورات خلال فترة التجربة.
تفاوتت الاستجابة كثيرًا بحسب الموضوع
كانت Perplexity الأداة الوحيدة الموجهة للناطقين بالإنجليزية التي استشهدت بموضوع النقاش، وذلك في 11.4% من 35 إجابة. ولم تستشهد أي من الأدوات الأربع بمنشور لوحة المفاتيح المختلقة خلال أسبوع.
لكن ينبغي توخي الحذر عند تفسير هذا الاختلاف. فقد اختلفت الموضوعات الثلاثة في الوقت نفسه من حيث طبيعتها، وكمية المعلومات المنافسة المتاحة عنها، وصيغة الأسئلة؛ ولم يعزل الباحثون العوامل التي أدت إلى اختلاف النتائج. لذلك لا تكفي النتائج للجزم بأن «المنتجات المختلقة يصعب التقاطها».
وفي تجربة إضافية، نشر الباحثون 10 موضوعات مختلقة مختلفة، موضوعًا واحدًا في كل مرة، على Sohu وYouTube وCSDN. وعلى مستوى الأدوات العشر، رُصد استشهاد واحد على الأقل أو ظهور لمعلومات مزروعة في 9 من الموضوعات، وكانت Perplexity واحدة من الأدوات الثلاث الأكثر استشهادًا بها.
الموقع الذي نُشر فيه المحتوى كان أهم من عدد المنشورات
تناولت الدراسة أيضًا تأثير مكان النشر. وأنشأ فريق البحث منشورات في أزواج عن 5 وجهات سفر غير معروفة. ووُضع أحد المنشورين على موقع كثيرًا ما ترجع إليه الأدوات، والآخر على موقع نادرًا ما ترجع إليه. وفي الأزواج الخمسة جميعها، ظهر أول استشهاد أو إعادة إنتاج للمعلومات المزروعة في المنشور المنشور على الموقع الذي يُرجع إليه كثيرًا.
حتى في الحالة التي ظهرت فيها الاستجابة بأسرع وقت على الجانب الأقل استشهادًا به، كان ذلك يتطلب نشر 20 منشورًا. أما نشر 40 منشورًا على موقع WordPress مُدار ذاتيًا فلم يسفر عن أي استجابة خلال 7 أيام. وأكد المؤلفون أن هذه النتائج تخص موضوعات بعينها، ولم يقدموها بوصفها قاعدة عامة.
زادت الاستشهادات مع زيادة العدد، لكن
في تجربة أخرى، غيّر الباحثون عدد المنشورات على Sohu، من منشور واحد إلى 20، بشأن ستة موضوعات متخيّلة. وارتفع إجمالي الاقتباسات عبر الأدوات العشر من 24 إلى 128. لكن ChatGPT لم يقتبس هذه المنشورات قط، فيما لم يقتبسها Google AI إلا في ثلاثة موضوعات كان عدد المنشورات فيها أقل. ولأن الموضوعات اختلفت باختلاف عدد المنشورات، يتعامل الباحثون مع هذه الزيادة بوصفها ارتباطًا لا علاقة سببية.
بعبارة أخرى، لا يمكن القول ببساطة إن «زيادة الكمية تضمن الفوز»؛ فالأهم أولًا هو ما إذا كان المحتوى يستطيع الوصول إلى المكان الذي تثق به أنظمة الذكاء الاصطناعي وترجع إليه. وهذا يشبه إلى حد ما ما اعتدناه في تحسين محركات البحث (SEO)، حيث لا يقتصر الأمر على عدد الروابط الخلفية، بل يشمل أيضًا المواقع التي تأتي منها.
ما الذي حدث مقابل حزمة منشورات بقيمة 14 دولارًا؟
اشترى فريق البحث، مقابل 14 دولارًا، حزمة منشورات موجّهة إلى مواقع الويب الصينية من جهة تقدّم خدمات في مجال GEO، أي تحسين فرص ظهور معلومات الشركات في إجابات الذكاء الاصطناعي التوليدي. ونُشرت المنشورات الثلاثة عشر بعد نحو 28 دقيقة من الشراء. وفي غضون ساعة من نشرها، رُصدت إحالة من Doubao تتضمن معلومات مدسوسة في أحد المنشورات. ويعرض المؤلفون هذه الواقعة بوصفها حالة واحدة أمكن رصدها، لا بوصفها معدل نجاح.
قد يترك إنفاق مبلغ زهيد وعمل لا يتجاوز 30 دقيقة أثرًا في إجابات الذكاء الاصطناعي. وكون ذلك حدث على الويب الفعلي يحمل قدرًا من الأهمية.
لا تُسقطوا النتائج مباشرةً على العلامات التجارية الحقيقية
تناولت التجربة مفاهيم ومنتجات غير موجودة، إلى جانب أسئلة عن الآراء. ولم يُختبر ما إذا كان الاتجاه نفسه يظهر عند البحث عن علامات تجارية أو منتجات حقيقية. وينطبق الأمر ذاته على المنتجات التي لا تحظى بتغطية تُذكر في وسائل أخرى.
توضح Google في إرشاداتها المتعلقة بميزات الذكاء الاصطناعي أن السعي المصطنع إلى اكتساب «الإشارات» ليس فعّالًا كما قد يبدو، وذلك لوجود أنظمة ترتيب تعطي الأولوية للمحتوى عالي الجودة وآليات تحجب الرسائل غير المرغوب فيها. لكن الورقة البحثية لا تحدد منتجات Google التي خضعت للاختبار.
كما أُجريت التجربة في مارس وأبريل، قبل أن توضح Google في 15 مايو أن سياسات الرسائل غير المرغوب فيها تشمل أيضًا محاولات التلاعب بالإجابات التوليدية في بحث Google. ويشير المؤلفون إلى أن النسب الدقيقة قد تتغير مع تحديث الأدوات.
قد تتأثر إجابات الذكاء الاصطناعي بـ«أين وُضعت المعلومات» أكثر من «مَن وضعها»
ما يلفت الانتباه في هذه النتائج هو قِصر المدة، أسبوع واحد، وظروف النشر عبر حسابات مجهولة. وهذا يختلف تمامًا عن عالم قد يستغرق فيه رفع ترتيب نتائج البحث نصف عام. فإذا نُشر المحتوى على موقع تعتمد عليه أنظمة البحث بالذكاء الاصطناعي كمصدر، فقد يصل إلى الواجهة حتى إن كان ضعيف الإسناد. وقد تبدو هذه البنية فرصةً لمسؤولي العلاقات العامة في الشركات، فيما يراها المستخدمون مصدرًا للمخاطر.
コメント