
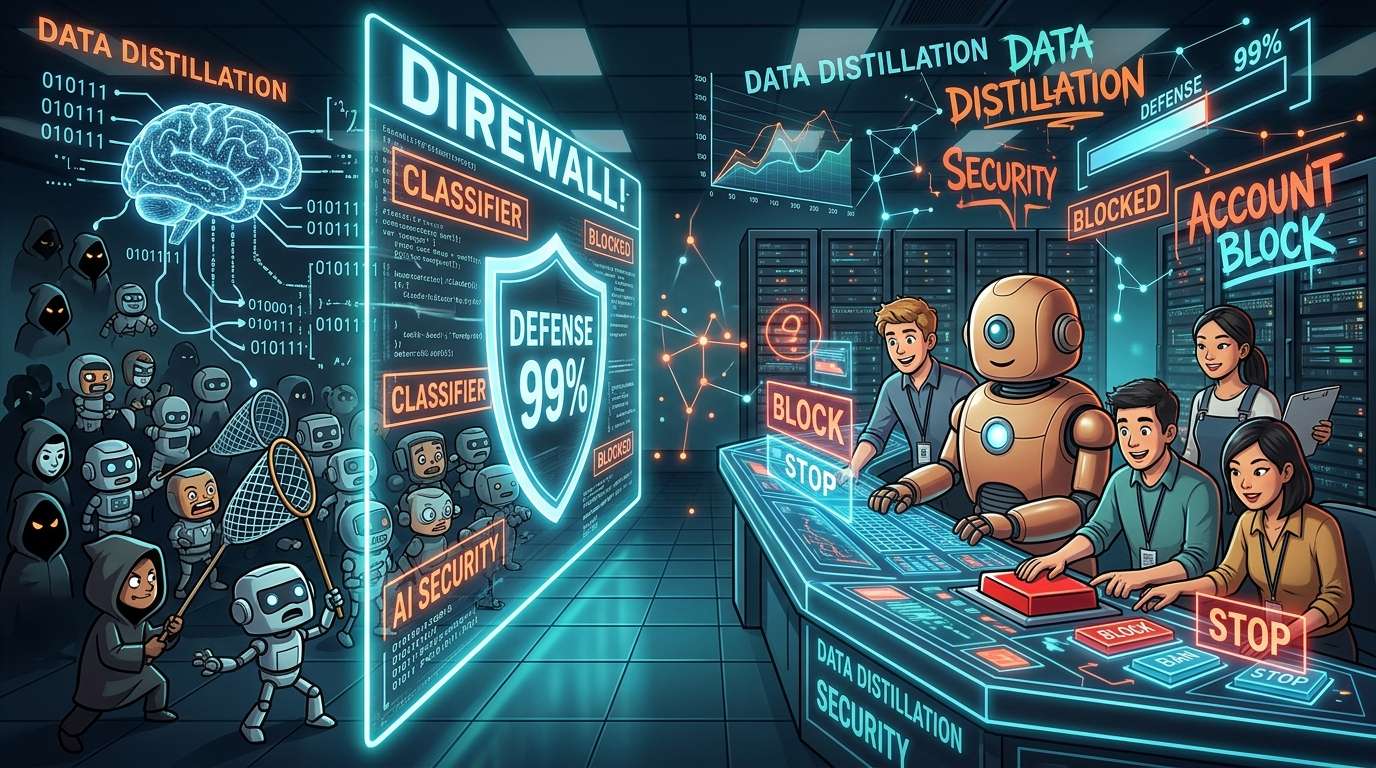
Anthropic ने बताया कि उसने संवादात्मक AI «Claude» की तर्क-प्रक्रिया दिखाने वाली जानकारी (रीज़निंग टोकन) को बड़े पैमाने पर निकालने की कोशिशों से बचाव मजबूत किया है और निकाली गई जानकारी की मात्रा 90–99% तक घटाई है। कंपनी के अनुसार, तर्क संबंधी जानकारी तक पहुंच सीमित करने के साथ-साथ उसने निष्कर्षण के संकेतों का पता लगाने वाला एक क्लासिफ़ायर सक्रिय किया और संबंधित खातों को स्वचालित रूप से निलंबित करने की व्यवस्था शुरू की। अब तक निलंबित किए गए खातों की संख्या कई दसियों हज़ार तक पहुंच चुकी है।
Claude तक बड़े पैमाने पर पहुंच को कैसे रोका जाए
इस मामले की पृष्ठभूमि में «डिस्टिलेशन» है—यह ऐसी विधि है जिसमें एक शक्तिशाली AI मॉडल के आउटपुट को प्रशिक्षण सामग्री बनाकर उससे एक अलग, छोटा मॉडल प्रशिक्षित किया जाता है। आम तौर पर यह अपनी कंपनी के मॉडल को हल्का बनाने की एक वैध तकनीक है, लेकिन इसका इस्तेमाल दूसरे की कंपनी के मॉडल से बड़ी संख्या में सवाल पूछकर और जवाबों को सुराग बनाकर उसकी पूरी क्षमता की नकल करने के लिए भी किया जाता है। Anthropic की चिंता इस तरह के संगठित निष्कर्षण को लेकर है।
कंपनी के मुताबिक, हमलावर कई लाख फ़र्ज़ी खातों के नेटवर्क का इस्तेमाल कर रहे हैं। हर खाते की गतिविधि इस हद तक सीमित रखी जाती है कि वह एक सामान्य उपयोगकर्ता जैसा दिखे, जबकि सभी खाते मिलकर बड़ी मात्रा में जवाब इकट्ठा करते हैं। इसे जनशक्ति की रणनीति के बजाय «खाता-समूह की रणनीति» कहना अधिक उपयुक्त होगा।
निशाने पर हैं रीज़निंग टोकन—यानी जवाब तक पहुंचने के लिए मॉडल के भीतर अपनाए जाने वाले सोच के चरण। अगर अंतिम जवाब के साथ-साथ तर्क की पूरी प्रक्रिया भी हाथ लग जाए, तो दूसरे मॉडल को «कैसे सोचना है» सिखाया जा सकता है। इसे खाना पकाने की मिसाल से समझें: बात सिर्फ तैयार पकवान के स्वाद की नकल करने की नहीं, बल्कि उसकी पूरी विधि चुरा लेने की है।
Anthropic ने मुख्य रूप से तीन कदम उठाए हैं: Claude के आंतरिक तर्क-चरणों तक पहुंच सीमित करना; निष्कर्षण की कोशिशों का पता लगाने वाला क्लासिफ़ायर चलाना; और संदिग्ध पाए गए खातों को स्वचालित रूप से निलंबित करना।
आंकड़ों से दिखता असर और उसकी सीमाएं
Anthropic के अनुसार, सुरक्षा उपाय लागू होने के बाद निकाले गए रीज़निंग टोकन की मात्रा 90–99% तक घट गई। कंपनी का यह भी कहना है कि उपाय शुरू होने के बाद डिस्टिलेशन की सफल घटनाओं में भारी गिरावट आई। आंकड़े एक सीमा के रूप में दिए गए हैं, लेकिन कंपनी का दावा है कि निष्कर्षण को कम-से-कम मूल मात्रा के दसवें हिस्से या उससे भी कम तक सीमित कर दिया गया।
एक और बात, जिसे नज़रअंदाज़ नहीं किया जा सकता, वह है कंपनी द्वारा स्वीकार किया गया दुष्प्रभाव। उसके मुताबिक, वैध उपयोगकर्ता भी कभी-कभी पहचान प्रणाली की चपेट में आ सकते हैं। धोखाधड़ी रोकने वाले जाल को जितना सघन किया जाएगा, सामान्य उपयोगकर्ता और कंपनियां भी उसमें फंस सकती हैं। सुरक्षा उपायों के साथ जुड़ी यह अनिवार्य समस्या AI सेवाओं के लिए भी कोई अपवाद नहीं है।
बड़ी मात्रा में सेवा का इस्तेमाल करने वाले डेवलपर या स्वचालन टूल से जुड़े कारोबारी सिस्टम ऐसे व्यवहार कर सकते हैं, जो निष्कर्षण के संकेतों जैसे दिखें। आगे चलकर, धोखाधड़ी रोकने की सख्ती और सामान्य उपयोग में बाधा न डालने के बीच संतुलन ही सेवा की सहूलियत तय करेगा।
कंपनियों के नाम लेकर लगाए गए आरोपों का क्या मतलब है
इस बार Anthropic ने चीनी कंपनियों Zhipu (智譜) और Moonshot का नाम लेते हुए कहा कि वे इसमें शामिल थीं। कंपनी के दावे के अनुसार, Zhipu ने अमेरिका के प्रमुख मॉडलों से साइबर-संबंधी क्षमताएं हासिल कीं और उनका इस्तेमाल अपने GLM-5.3 के लिए किया। Moonshot पर आरोप है कि उसने गुप्त रूप से Claude को भेजे गए सवालों को उसके माध्यम से रूट किया। ये सभी Anthropic के दावे हैं; इस सामग्री में दोनों कंपनियों का पक्ष उपलब्ध नहीं है।
Anthropic ने यह भी कहा कि इस तरह हासिल की गई क्षमताएं विदेशी सैन्य प्रणालियों या निगरानी प्रणालियों तक पहुंच सकती हैं। यह ध्यान देने योग्य है कि कंपनी इसे केवल कारोबारी नकल का मामला नहीं, बल्कि राष्ट्रीय सुरक्षा का मुद्दा मान रही है।
एक और कदम के तहत, कंपनी ने अन्य AI विकास कंपनियों से भी इसी तरह के सुरक्षा उपाय अपनाने का आह्वान किया है। वजह यह है कि अगर केवल एक कंपनी अपने दरवाज़े मजबूत करे, लेकिन जानकारी किसी दूसरे रास्ते से निकाल ली जाए, तो इसका असर सीमित रहेगा। अब सवाल है कि क्या पूरा उद्योग एकजुट होकर कदम उठा पाएगा।
जनरेटिव AI की प्रतिस्पर्धा अब केवल अधिक बुद्धिमान मॉडल बनाने की होड़ तक सीमित नहीं है। यह इस बात को पहचानने और नियंत्रित करने की लड़ाई भी बनती जा रही है कि उस मॉडल का इस्तेमाल कौन और कैसे कर रहा है। फ़र्ज़ी खातों का पता लगाने और पहुंच सीमित करने जैसी कम दिखने वाली सुरक्षा तकनीकें आने वाले समय में AI कंपनियों की प्रतिस्पर्धात्मक क्षमता को अधिक प्रभावित कर सकती हैं।
コメント