
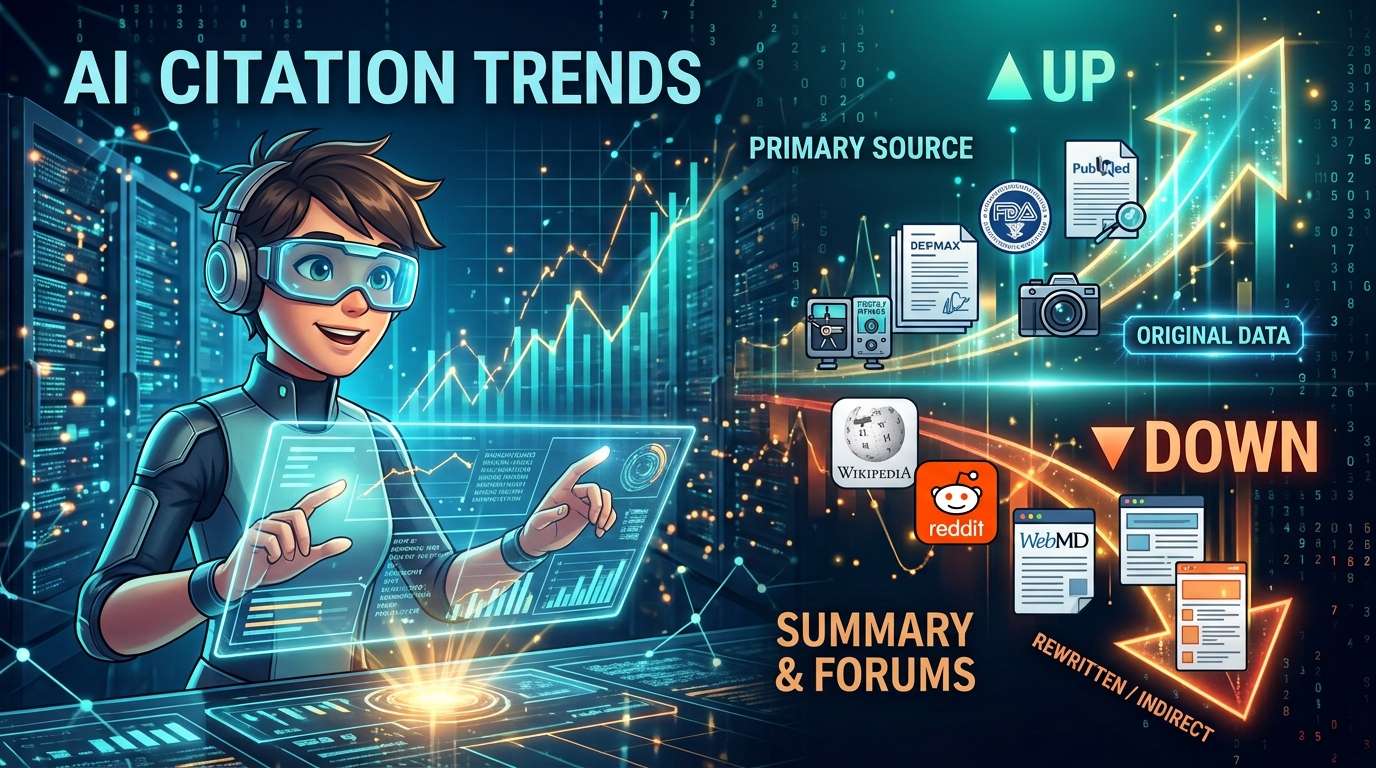
SEO टूल बनाने वाली Ahrefs ने ChatGPT के अमेरिका-केंद्रित जवाबों में उद्धृत डोमेन की रैंकिंग में हुए बदलाव जारी किए हैं। मार्च और सितंबर की तुलना में, मेडिकल शोध-पत्रों के डेटाबेस PubMed की रैंकिंग 64वें से बढ़कर चौथे स्थान पर पहुंच गई, जबकि स्वास्थ्य जानकारी देने वाली साइट WebMD 18वें से गिरकर 79वें स्थान पर आ गई। इससे ऐसा लगता है कि शोध डेटा और वास्तविक उत्पाद परीक्षण जैसी मूल जानकारी रखने वाली साइटें शीर्ष पर पहुंची हैं।
शोध-पत्रों के डेटाबेस आगे, व्याख्यात्मक साइटें पीछे
इस आकलन में ChatGPT के अमेरिका-केंद्रित जवाबों में अक्सर उद्धृत किए गए शीर्ष 200 डोमेन शामिल हैं। यह मार्च के लगभग 24 लाख और सितंबर के लगभग 38 लाख जवाबों पर आधारित है।
PubMed के अलावा, जिनकी रैंकिंग ऊपर गई उनमें सरकारी स्वास्थ्य और शोध संस्थान, नियामक एजेंसियां और उत्पादों को वास्तविक रूप से आज़माकर उनका मूल्यांकन करने वाली परीक्षण साइटें प्रमुख थीं। उदाहरण के तौर पर FDA और RTINGS का उल्लेख किया गया है।
इसके उलट, शोध को सरल भाषा में समझाने वाली WebMD और Verywell Health, साथ ही Healthline और Investopedia जैसी स्वास्थ्य और वित्त संबंधी व्याख्यात्मक साइटों की रैंकिंग गिरी। Britannica, Investopedia और New York Post शीर्ष 200 से बाहर हो गए।
Ahrefs का कहना है कि ऐसा लगता है कि ChatGPT जानकारी का सारांश देने वाली साइटों के बजाय मूल स्रोतों को प्राथमिकता दे रहा है।
क्या यह ऐसा दौर है जब ‘सार बताने वालों’ के बजाय ‘जानकारी के मालिकों’ को चुना जा रहा है?
स्वास्थ्य और वित्त से जुड़े व्याख्यात्मक लेख अब तक सर्च इंजन पर अच्छा प्रदर्शन करते रहे हैं। इनका काम शोध-पत्रों और आधिकारिक दस्तावेज़ों को समझकर आसान भाषा में पेश करना रहा है। लेकिन जब AI जवाब तैयार करता है, तो वह ‘अनुवाद’ का काम खुद कर लेता है। ऐसे में यह मानना स्वाभाविक लगता है कि AI अनुवाद करने वाले के बजाय मूल स्रोत को देखना चाहेगा।
एक और उल्लेखनीय बात है उत्पाद परीक्षण करने वाली साइटों का उभरना। स्पेसिफिकेशन की सूची को बस नए क्रम में पेश करने वाले लेखों से अलग, वास्तविक माप और उपयोग का अनुभव ऐसी चीजें हैं जिन्हें केवल वही साइट लिख सकती है। हो सकता है कि AI द्वारा उद्धृत होने की शर्त अब इस बात के करीब आ रही हो कि सामग्री में कुछ मौलिक है या नहीं।
Ahrefs भी साइट संचालकों को ऐसी सामग्री पर ध्यान देने की सलाह देती है जिसे केवल वे ही तैयार कर सकते हैं। इसके उदाहरण हैं मौलिक शोध, वास्तविक उत्पाद परीक्षण और अपने उत्पादों की जानकारी।
Reddit और Wikipedia के उद्धरणों का अनुपात काफी गिरा
अमेरिका-केंद्रित जवाबों में Reddit का उद्धरण दिए जाने का अनुपात मार्च के 19.1% से गिरकर सितंबर में 2.3% हो गया। Wikipedia का अनुपात भी 14.1% से घटकर 2.9% रह गया। फिर भी, Ahrefs के मुताबिक, दोनों अब भी उन डोमेन में शामिल हैं जिन्हें ChatGPT अक्सर उद्धृत करता है।
Reddit के मामले में, एक अन्य विश्लेषण टूल Promptwatch ने अगस्त में इसी तरह की गिरावट दिखाई थी। ChatGPT सर्च के उद्धरणों में reddit.com का हिस्सा जुलाई के आखिर से अगस्त की शुरुआत तक औसतन 3.83% था, जो अगस्त के मध्य तक 0.52% रह गया। हालांकि, Ahrefs ने ‘Reddit को उद्धृत करने वाले जवाबों का अनुपात’ मापा है, इसलिए उसका माप Promptwatch से अलग है।
दुनिया भर के एक अलग नमूने में, ChatGPT ने site: सर्च (किसी खास साइट तक सीमित खोज) में जिन डोमेन को सबसे ज्यादा निर्दिष्ट किया, उनमें reddit.com नौवें स्थान पर था। यानी उद्धरणों का अनुपात गिरने के बाद भी, खोज के दौरान उसकी मौजूदगी बनी हुई है।
उद्धरण की रैंकिंग और वेबसाइट पर आने वाले लोगों की संख्या अलग-अलग चीजें हैं
यह ध्यान रखना जरूरी है कि यह रैंकिंग उद्धरणों की आवृत्ति दर्शाती है, साइट पर आने वाले लोगों की संख्या नहीं। रैंकिंग गिरने का मतलब यह नहीं कि उस साइट पर आने वाला ट्रैफिक भी उतना ही कम हो गया। इसी तरह, शीर्ष स्थान पर होने से यह साबित नहीं होता कि लोग क्लिक करके सामग्री पढ़ रहे हैं।
इसके अलावा, Ahrefs का ट्रैकिंग सिस्टम समय के साथ जांचे जाने वाले सवालों को जोड़ता रहता है, इसलिए रैंकिंग में बदलाव सवालों के बदलने से भी हो सकता है। इसी कारण कंपनी ने लगभग 25,000 ऐसे सवालों की तुलना की जो मार्च और सितंबर, दोनों में उच्च वॉल्यूम वाले शीर्ष 150,000 सवालों में शामिल थे। कंपनी का कहना है कि चार्ट में शामिल सभी साइटें एक ही दिशा में आगे बढ़ीं।
हकीकत यह है कि ज्यादातर जवाबों में सर्च नहीं होता
एक अन्य अध्ययन में यह देखा गया कि ChatGPT कितनी बार वेब सर्च करता है। अगस्त और सितंबर में मुफ्त और लॉग-इन न किए गए उपयोगकर्ताओं के 6.66 करोड़ जवाबों में से 14.4% के साथ वेब सर्च किया गया था। इसमें GPT-5.6 Luna मॉडल और सभी क्षेत्रों का डेटा शामिल है।
जिन जवाबों में सर्च किया गया, उनमें जवाब देने से पहले पृष्ठभूमि में औसतन लगभग 1.6 सर्च हुईं। इसे फैन-आउट कहा जाता है। 1.5 करोड़ फैन-आउट में से 6.8% किसी खास साइट तक सीमित site: सर्च थे, जिनमें 1,16,000 डोमेन शामिल थे। अक्सर खोजे गए लगभग 160 डोमेन तक सीमित करने पर, 75.9% सर्च apple या ikea जैसी कंपनियों की आधिकारिक साइटों की थीं।
एक अन्य शोध कंपनी Nectiv ने API के जरिए GPT-5.6 Sol पर लगभग 4,000 सवालों को संसाधित किया और प्रति सवाल औसतन 7.61 फैन-आउट दर्ज किए। हालांकि, मॉडल, सवाल और डेटा जुटाने के तरीके अलग हैं, इसलिए इसकी 1.6 से सीधी तुलना नहीं की जा सकती। Ahrefs का कहना है कि मुफ्त और लॉग-इन न किए गए उपयोग में, भुगतान वाले मॉडल या रीजनिंग मॉडल की तुलना में सर्च की संख्या कम होने का तथ्य भी इस अंतर का एक कारण है।
साइट संचालकों को किन बातों की पुष्टि करनी चाहिए
Ahrefs के निष्कर्ष अगस्त से सितंबर के बीच जुटाए गए एक ही मॉडल के स्नैपशॉट पर आधारित हैं। कंपनी ने यह भी कहा है कि भविष्य में मॉडल अपडेट होने पर रुझान बदल सकते हैं।
इसलिए साइट संचालकों के लिए व्यावहारिक कदम यह है कि वे नियमित रूप से जाँचें कि उनके मुख्य विषयों पर ChatGPT किन पेजों का हवाला देता है और उनकी जगह कौन-से स्रोत चुने जा रहे हैं। यदि व्याख्यात्मक लेख ट्रैफ़िक का मुख्य साधन हैं, तो OpenAI के हर मॉडल अपडेट के बाद उनकी समीक्षा करना उपयोगी होगा।








コメント