
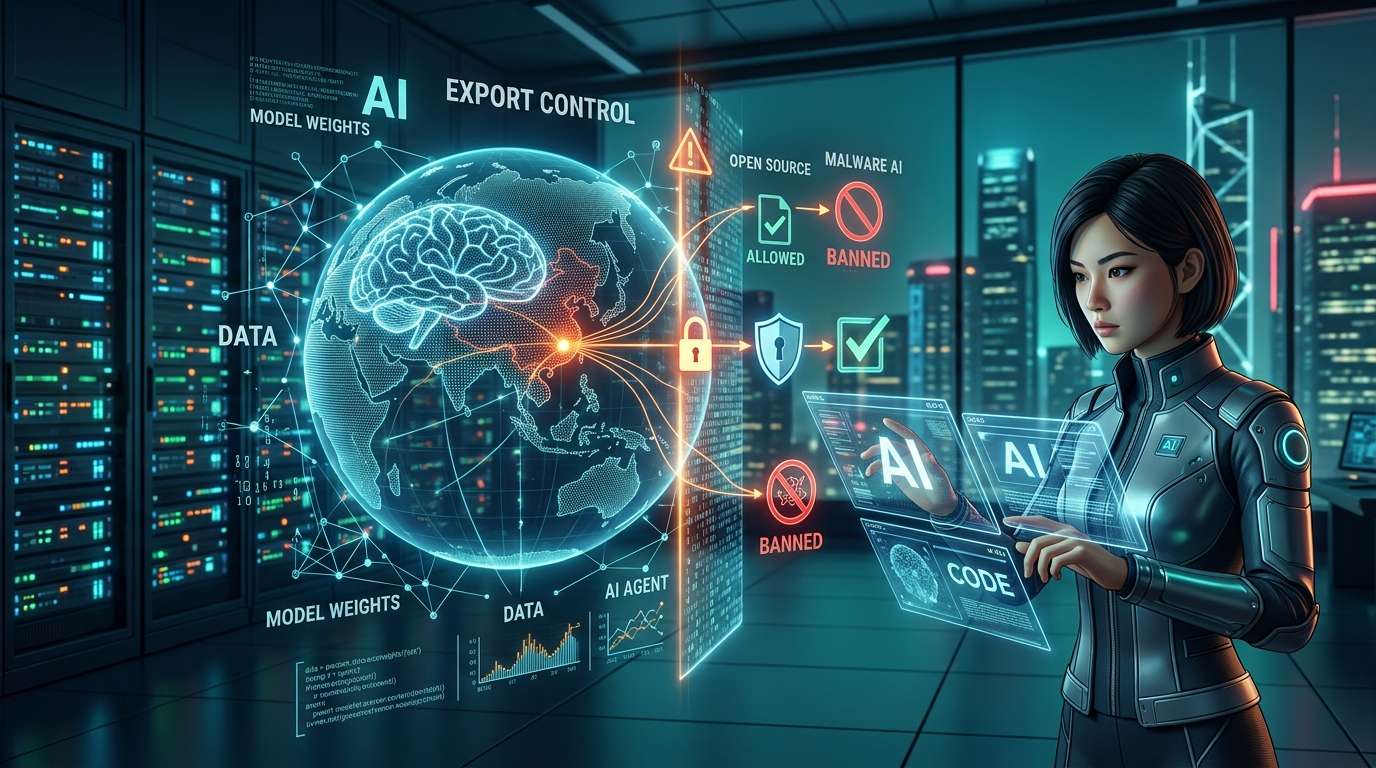
中国商务部和科技部公布了《禁止出口限制出口技术目录》修订草案,涉及大模型、AI智能体、计算集群、数据处理等23个重点领域。草案规定,能够自主创建或修改恶意软件的AI禁止出口;已公开的技术不在管制范围内,开源发布也可通过仅需备案的机制获得许可。目前仍处于草案阶段,最终规则尚未确定。
监管瞄准的不是“性能”,而是“内核”
这份草案引人注目之处在于,管制对象并非单纯是模型本身,而是涵盖了构建模型所需的一整套技术:权重、检查点、源代码、架构,以及训练和推理方法。与其说是在管制成品出口,不如说是在管制把配方和整间厨房一并带走。
这里所说的权重,是指AI经过训练后形成的“记忆”——一组数值。只要掌握这些数值,就几乎可以在自己的环境中复现该模型。因此,各国开始将权重作为出口管制的重点。
触发管制的三道门槛
模型核心技术受到管制需满足三项条件:训练所用计算量达到10的26次方FLOPs或以上;参数数量达到2万亿或以上;或排名进入全球前10。符合其中任意一项,即纳入管制范围。
是否跻身前10,将由出口管制部门参照国内外主要评测机构和行业平台公布的排名作出判断。评估角度包括综合性能、单项任务、安全性以及全球使用规模等。值得注意的是,管制标准不仅有数值门槛,还纳入了会动态变化的排名指标。新模型一旦跻身竞争前列,就可能落入管制范围。
使用重要数据训练的模型也会受到管制
另一个管制入口是数据。使用《数据安全法》等法规所规定的中国“重要数据”进行训练,并提供基于这些数据的服务的大模型,也将纳入出口管制范围。
草案还细致规定了例外情形。依法公开的数据不在管制范围内。此外,只有在数据事先经过清洗、不出现在AI输出中,且不会大幅提升相关领域核心技术研发能力的情况下,少量使用不超过0.1%的数据才会获准。通过设定具体数字,草案为实际执行留出了空间。
哪些AI禁止出口,哪些AI受到限制
草案中力度最大的措施,是禁止攻击型AI出口。针对重要基础设施、军队和政府机构,并能自主编写或改写恶意软件的AI工具属于此类。
另一方面,用于发现软件漏洞的AI工具并非一律禁止,而是被列为新的出口限制对象。寻找漏洞的技术既可用于防御,也可用于攻击。将禁止与限制区分开来,可以看出草案考虑到了这项技术的双重用途。对网络安全行业来说,限制范围究竟有多大,将成为今后实务上的焦点。
保护开源的便捷通道
草案看起来是在收紧出口,但也踩下了油门。将受限制的AI技术或权重以开源方式发布,可自动获得许可。在海外运营自有数据中心、将芯片设计数据交由海外制造、与外国合作伙伴开展联合研究,以及参与国际标准制定,也适用同样的安排。提交所需文件后,符合条件的出口即可获批。
过去几年,中国开发的开源模型已被全球开发者广泛使用。这项程序隐约体现出不希望阻断这一趋势的意图。此外,已通过开源或论文公开的AI技术不受新规约束。换言之,已经公开的内容不会被纳入管制。
区分“使用”与“带出境”
在实际应用中,管制会根据使用方式作出区分。即使是受限制的模型,只要通过API、应用、网站或SaaS使用,就不属于出口管制范围。在终端设备上运行的轻量版也一样。只要海外用户通过聊天方式试用,或将其集成到自有服务中,就不会触及这项规则。
另一方面,如果将受限制的技术部署在海外本地服务器上,就需要取得常规出口许可。不过,如果是在自营的海外云上运行,则可使用简化程序。也就是说,规则划定的界线并非“谁能访问”,而是“技术实体部署在哪里”。
这种区分对海外企业影响不小。如果草案最终定稿,将中国制造的模型引入自有环境并投入运营,就会成为一条以取得许可为前提的路径。
美国的镜像,以及欧洲的难题
OpenAI战略未来部门负责人迪恩·W·鲍尔认为,此次举措并不意味着中国要封闭公开权重模型,而是让政府保留在必要时叫停未来模型的空间。他认为,这与美国已经实施的模型权重出口管制形成了“镜像”关系。
如果这一格局持续发展,依赖公开权重AI的美国企业预计会更加倾向于采用本国模型,而非中国模型。处境更为棘手的将是欧洲。欧洲一直设想通过在本地区的云端运行公开权重模型来保持自主性。然而,如果重要公开模型的来源集中在中美两国,而且还可能随时因出口管制而被叫停,这一前提就会动摇。
“开放”一词容易让人以为人人都能自由使用。但这种自由在某种程度上受到供应方所在国政策的左右。或许可以说,我们正在进入一个不再只是“公开还是管控”二选一、而是连实现公开的路径也要通过制度加以设计的时代。
全球南方与程序现状
该方案还提出支持全球南方的AI开发。方案称,以能力建设、技术共享和共同制定规则为目的的出口,将在中国发起的世界人工智能合作组织这一框架内得到便利。该组织被定位为与西方主导的AI相关机构相抗衡的力量。
在最终规则生效之前,企业必须通过商务部的门户网站登记受影响的出口。
コメント