
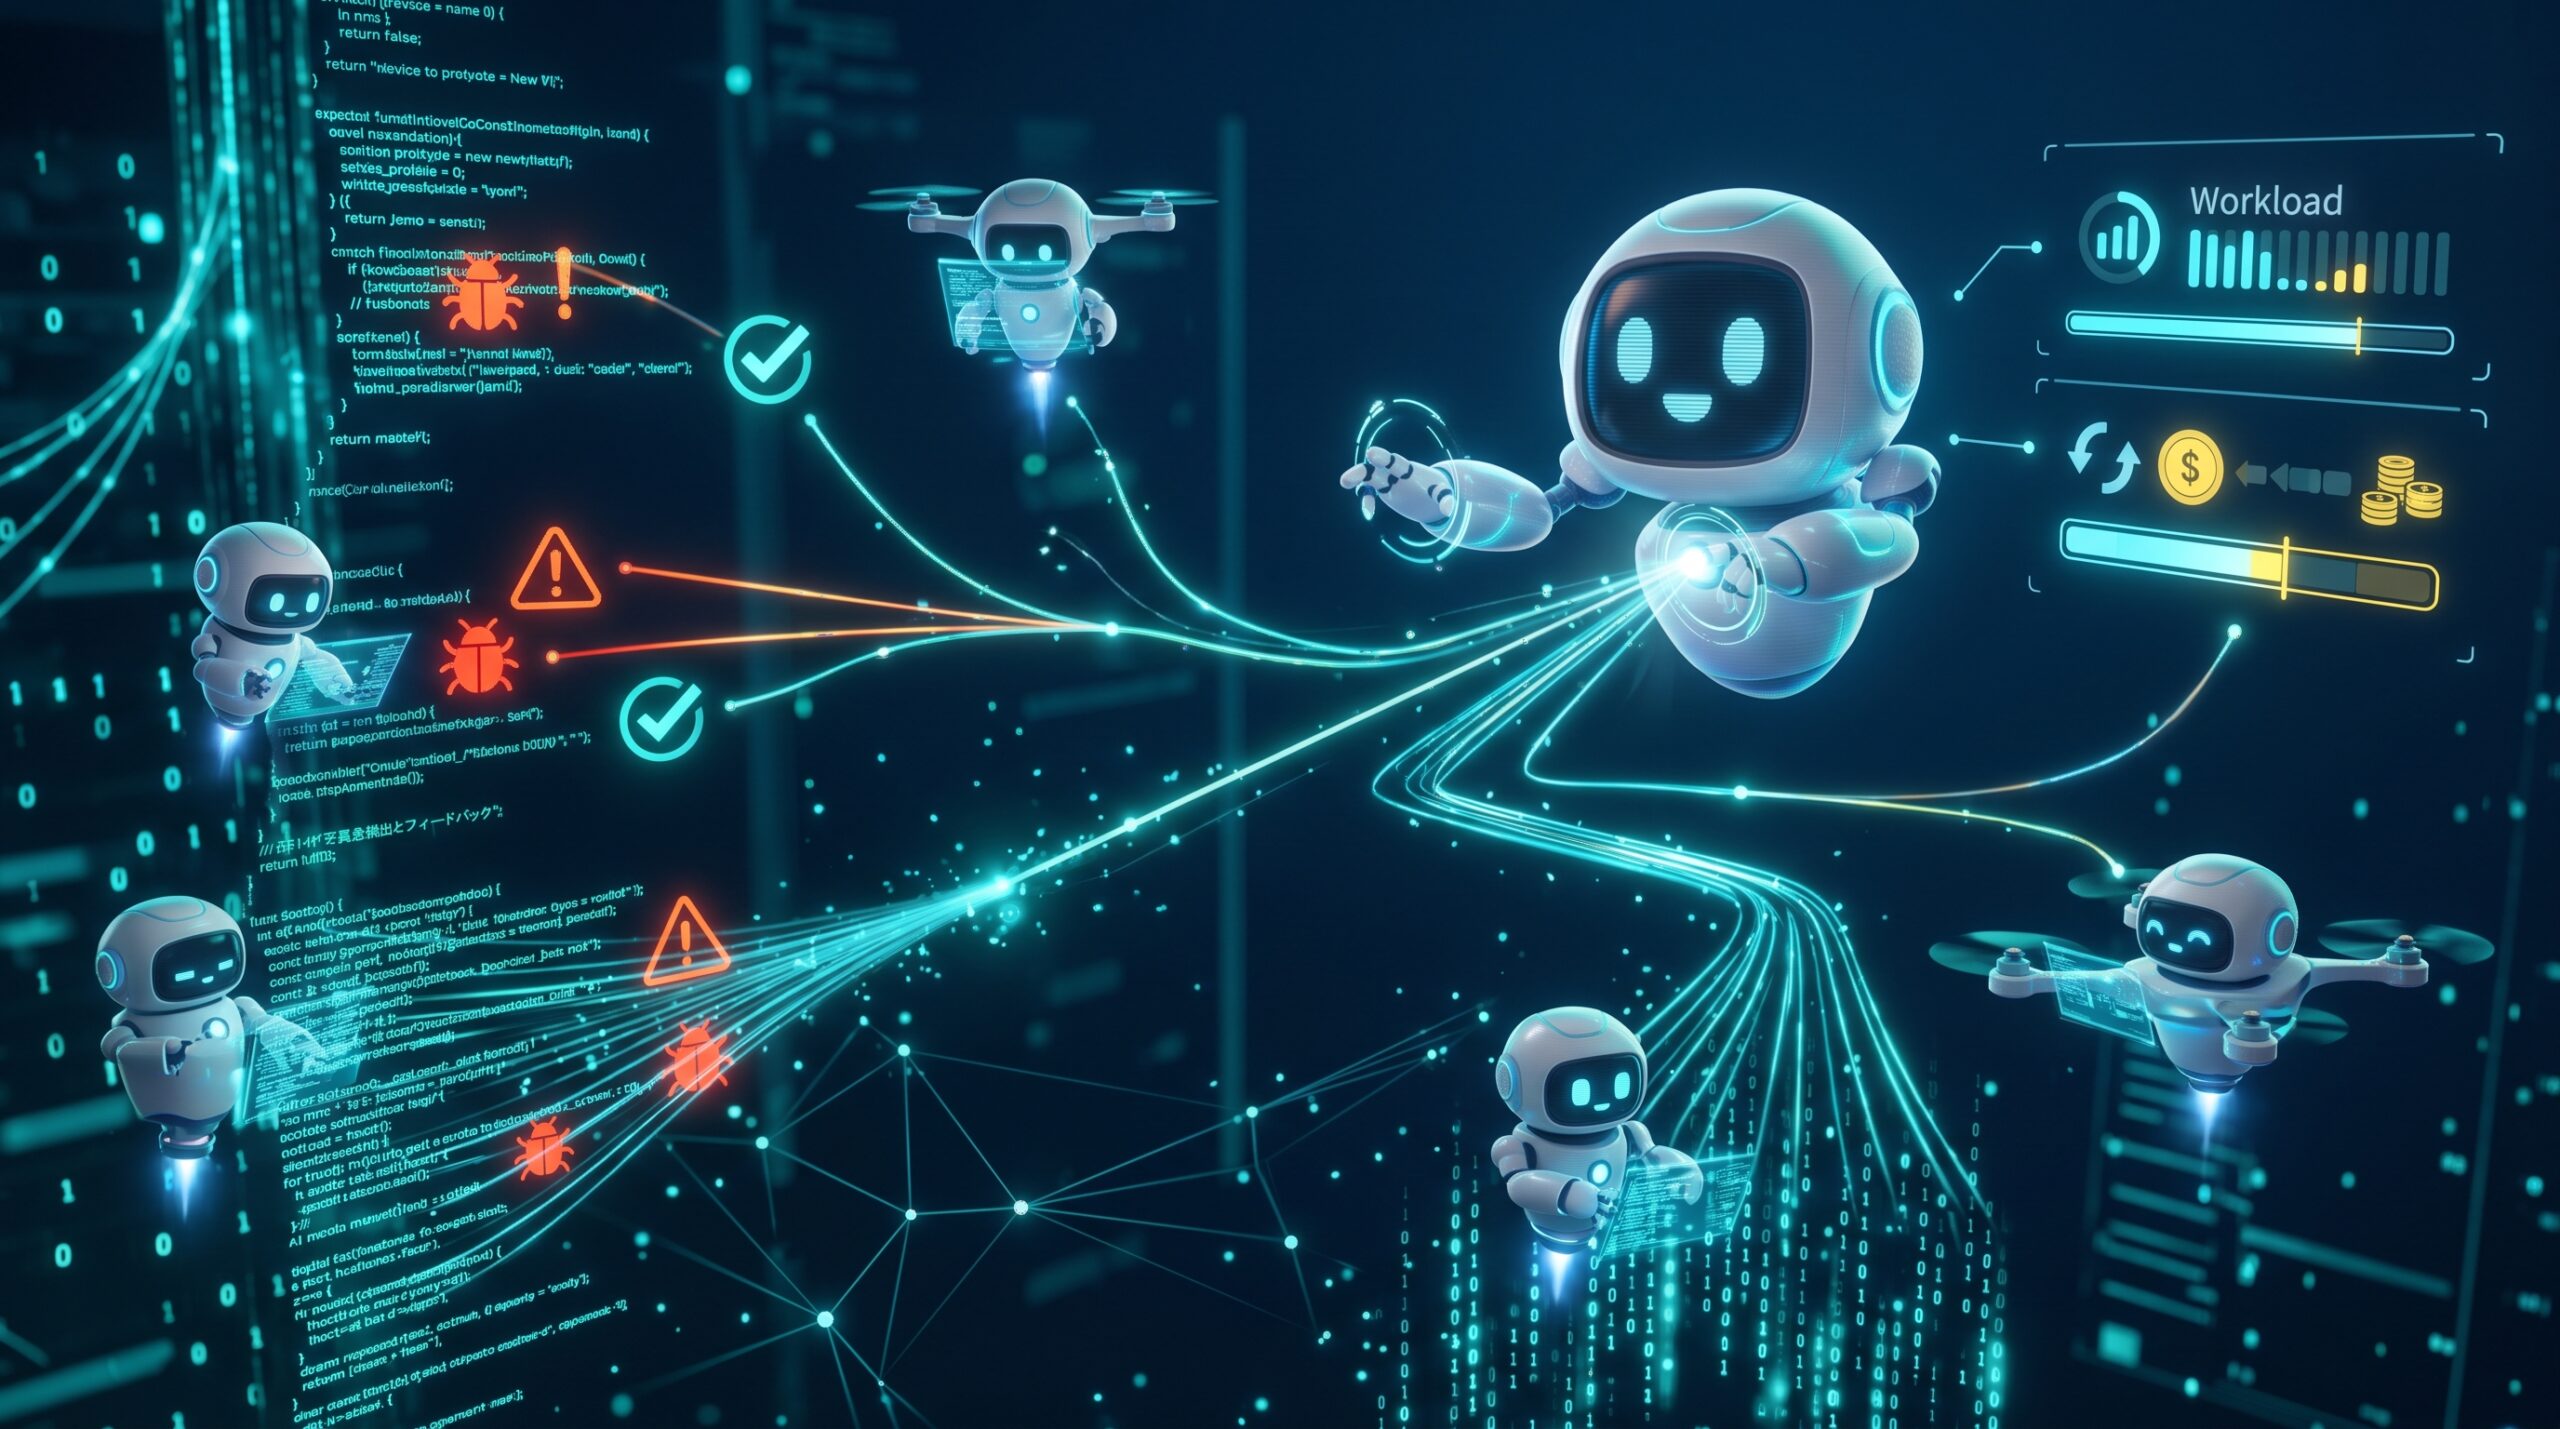
KI übernimmt alles – von der Planung bis zur Aufgabenverteilung
Anthropic hat der Ausführungsplattform für KI-Agenten „Claude Managed Agents“ dynamische Workflows hinzugefügt, bei denen mehrere Agenten die Arbeit unter sich aufteilen. Ein leitender Agent erstellt einen Plan, verteilt Aufgaben an untergeordnete Agenten und führt die Ergebnisse zusammen. Bei einem einzigen Durchlauf können bis zu 1000 Agenten parallel arbeiten.
KI-Agenten sind KIs, die auf ein vorgegebenes Ziel hinarbeiten. Bei der neuen Funktion wird nicht mehr alles einem einzigen Agenten überlassen, sondern die Arbeit zwischen einem leitenden Agenten und ausführenden Agenten aufgeteilt. Damit wurde die bestehende Ausführungsplattform um einen Mechanismus ergänzt, mit dem sich mehrere KIs gemeinsam einsetzen lassen.
Bemerkenswert ist nicht nur die Obergrenze von 1000. Die KI übernimmt auch die Aufteilung der Arbeit und das Zusammenführen der Ergebnisse. Die Zahl der parallel einsetzbaren Agenten bedeutet jedoch nicht automatisch eine entsprechend höhere Verarbeitungsgeschwindigkeit oder bessere Ergebnisse.
66 von 70 Fehlern erkannt
In einem von Anthropic vorgestellten Test wurden absichtlich 70 Fehler in 116.000 Codezeilen eingebaut und die Erkennungsergebnisse verglichen. Ein einzelner Agent fand bei einem Durchlauf 14 bis 27 Fehler. Beim dynamischen Workflow wurden dagegen laut Anthropic durchgängig 66 Fehler erkannt.
Umgerechnet entspricht das einer Erkennungsquote von etwa 20 bis 39 Prozent beim einzelnen Agenten und rund 94 Prozent beim dynamischen Workflow. In diesem Test führte die Aufteilung der Arbeit auf mehrere Agenten zu mehr erkannten Fehlern. Mit 66 Treffern wurden jedoch nicht alle eingebauten Fehler gefunden.
Außerdem wurde dieses Ergebnis bei einer speziellen Aufgabe erzielt: dem Erkennen von Fehlern in Code. Ob sich ein vergleichbarer Unterschied auch bei anderen Tätigkeiten wie Recherche oder dem Verfassen von Dokumenten zeigt, lässt sich nicht beurteilen. In den bereitgestellten Unterlagen steht auch nicht, wie viele Agenten beim Test tatsächlich zum Einsatz kamen. Es wäre daher voreilig, das Ergebnis als Leistung von 1000 Agenten zu verstehen.
Bei der Einführung zählt der Aufwand pro Ergebnis mehr als die Zahl der Agenten
Die Aufteilung der Arbeit bringt auch einen höheren Verarbeitungsaufwand für die KI mit sich. Anthropic weist darauf hin, dass dabei große Mengen an Tokens verbraucht werden können, und empfiehlt, mit einer kleinen Konfiguration zu beginnen. Tokens sind Verarbeitungseinheiten für Texte und Code, mit denen die KI arbeitet, und ein Maßstab für die Nutzungskosten.
Für Unternehmen ist weniger entscheidend, wie viele KIs sie einsetzen können, als vielmehr, wie viel ein Ergebnis in der benötigten Qualität kostet. Selbst wenn mehr Fehler gefunden werden, hängt die Entscheidung für einen Einsatz davon ab, wie stark Kosten und Prüfaufwand steigen. Ein sinnvoller Ansatz wäre, einen einzelnen Agenten und eine kleine Konfiguration mit mehreren Agenten an derselben Aufgabe zu vergleichen und dabei die Zahl der gefundenen Fehler, die benötigte Zeit und die Kosten zu messen.
Die bereitgestellten Unterlagen nennen weder die Gesamtkosten noch die Bearbeitungszeit oder den Tokenverbrauch des Vergleichstests. Belegt ist lediglich der Unterschied bei der Zahl der erkannten Fehler – nicht aber die Kosteneffizienz.

コメント