
从制定计划到分配任务,均由AI负责
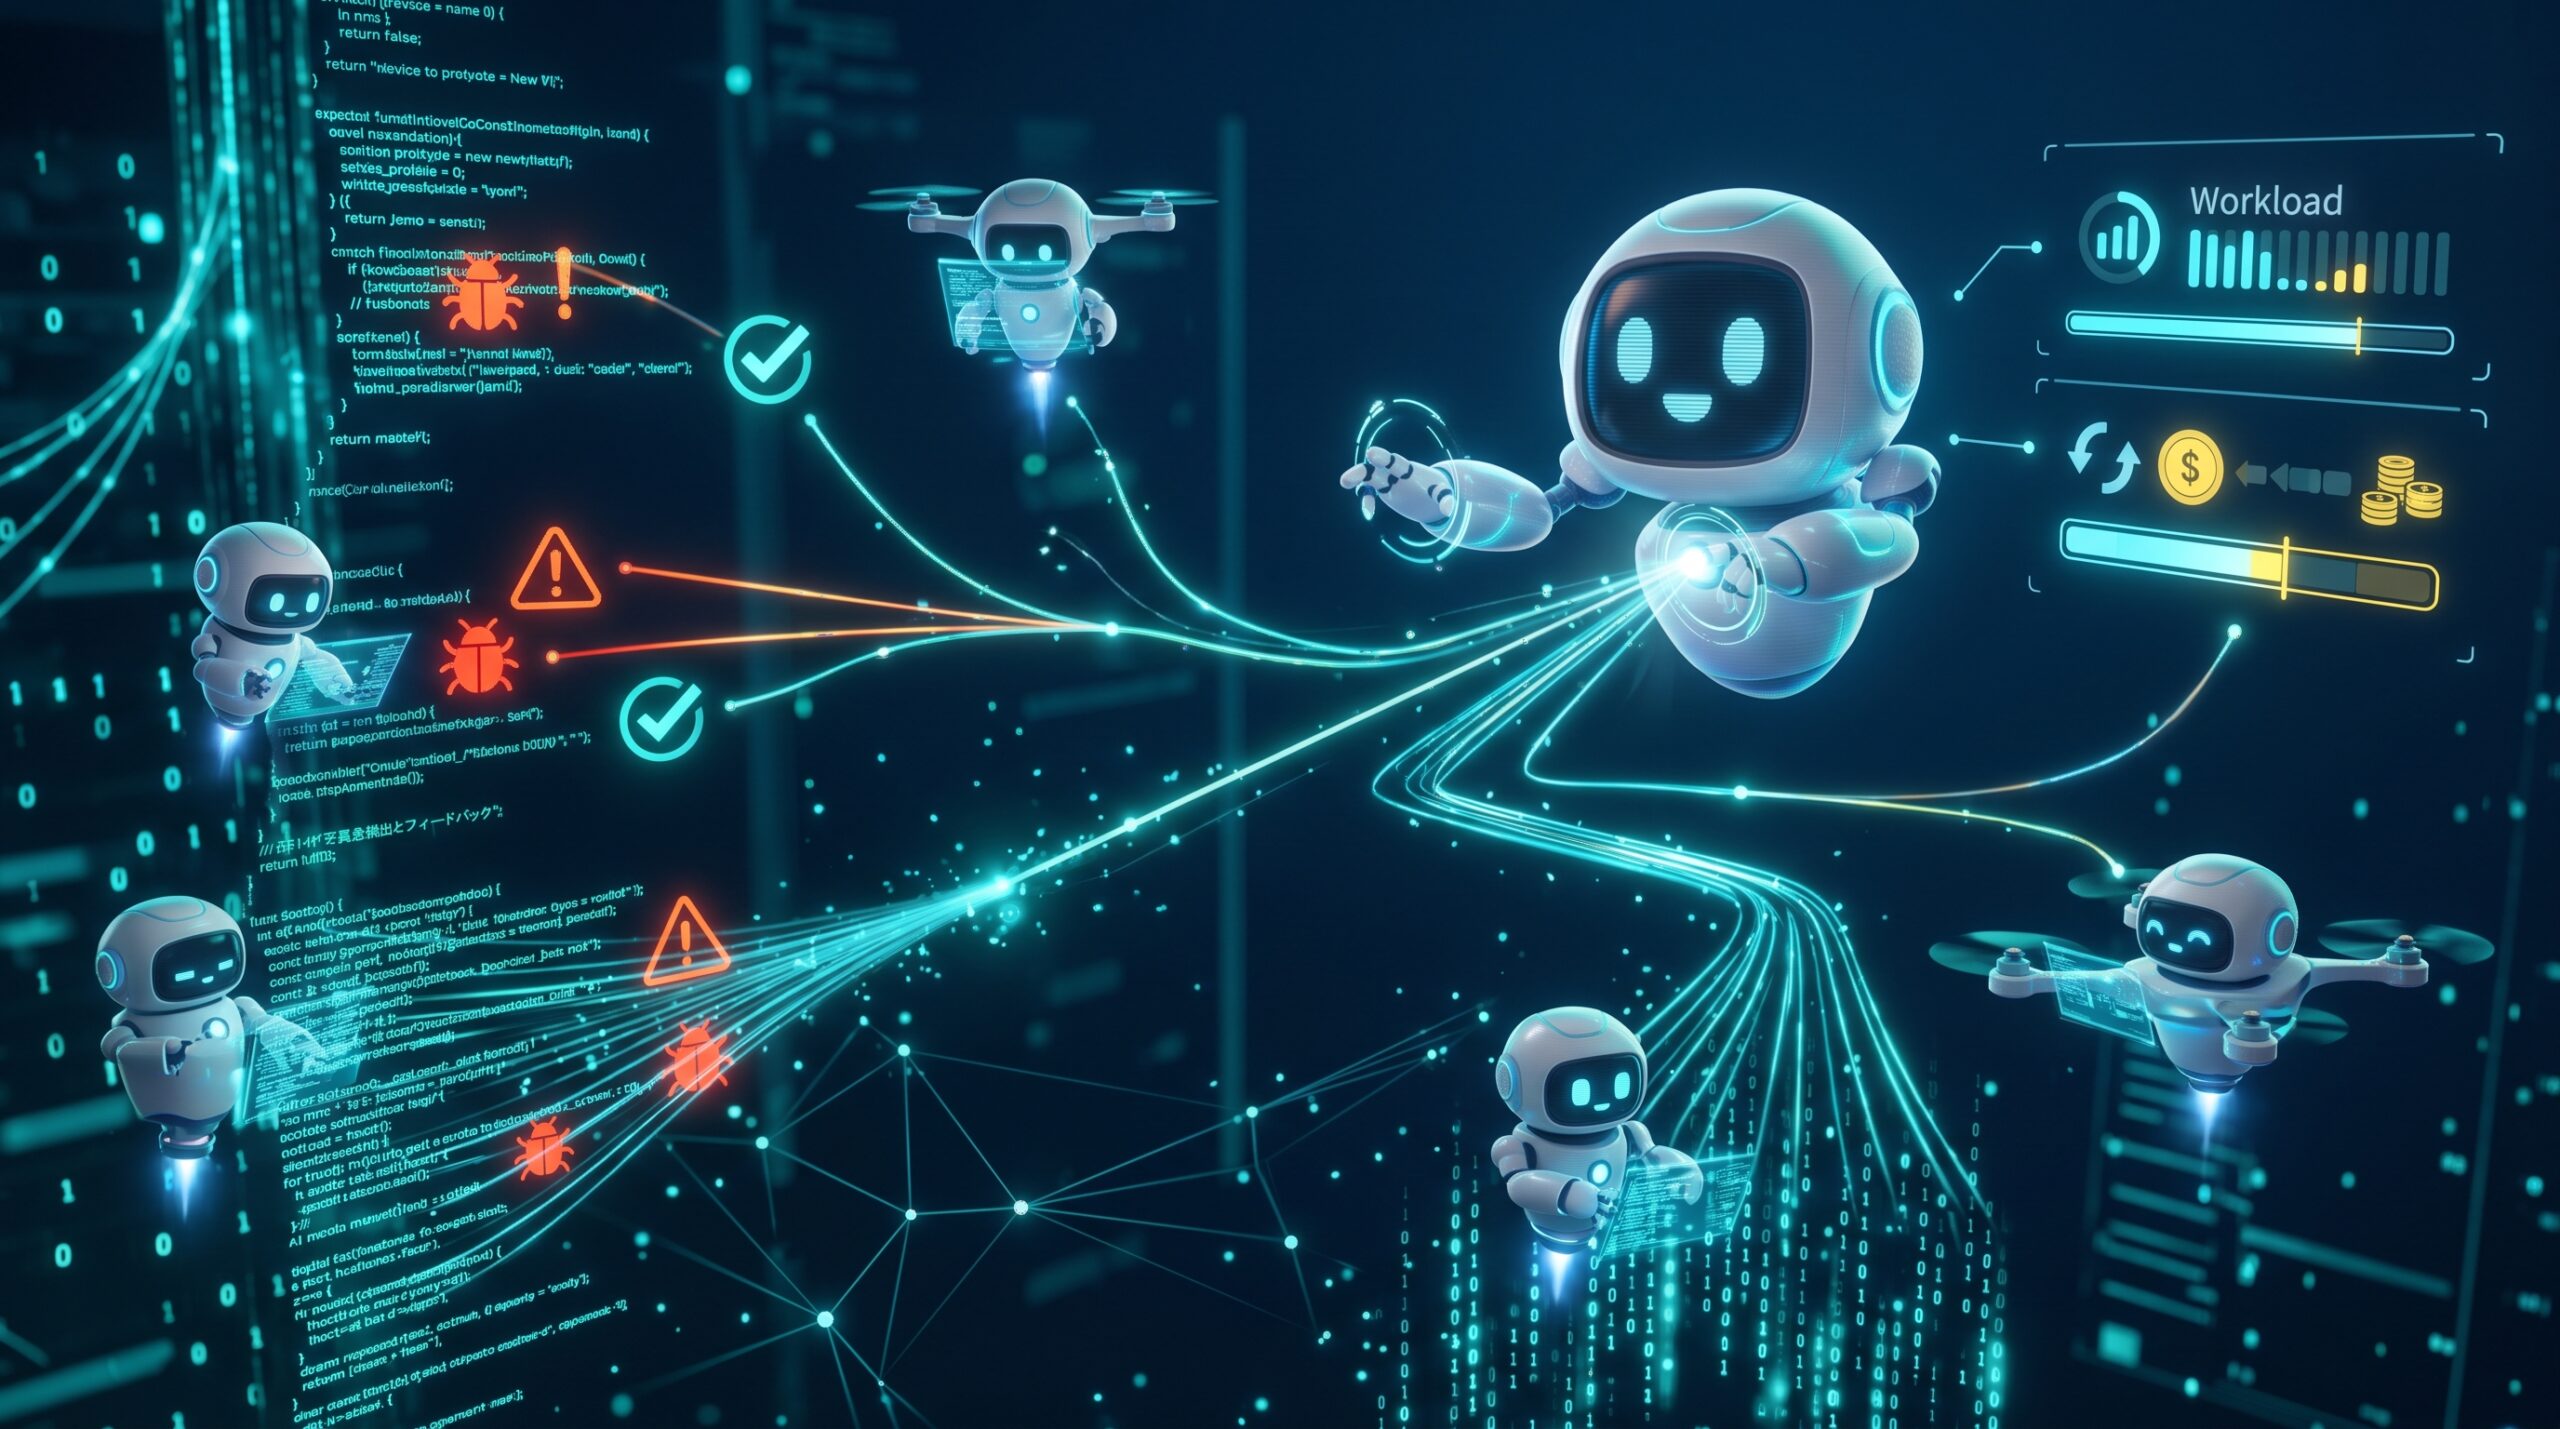
Anthropic为AI智能体运行平台“Claude Managed Agents”新增了动态工作流,可由多个智能体分担任务。负责指挥的智能体制定计划、向子智能体分派工作,并整合结果。一次运行最多可并行启用1000个智能体。
AI智能体是指朝着既定目标推进工作的AI。此次新增功能并非把所有任务都交给一个智能体,而是将其分为指挥者和执行者。这相当于在现有运行平台上,加入了集中调度多个AI的机制。
值得关注的不只是1000这个上限,还在于任务拆分和结果汇总都由AI负责。不过,可并行运行的数量并不等于处理速度或成果会按相同比例提升。
70个漏洞中检测出66个
Anthropic展示的测试在11.6万行代码中故意埋入70个漏洞,并对比检测结果。据称,单个智能体单次运行发现了14至27个漏洞,而动态工作流则始终检测出66个。
换算成检测率,单个智能体约为20%至39%,动态工作流则约为94%。在这项测试中,多个智能体分工协作带来了检测数量的增加。不过,即便检测出66个,也并未发现所有预先植入的漏洞。
此外,这一结果来自代码漏洞检测这一特定任务。目前无法确认在调查、文档撰写等其他工作中是否也能取得类似差距。所提供的资料也没有说明测试实际使用了多少个智能体,因此现在就认为这是启用1000个智能体的成果还为时过早。
部署评估的标准应是单位成果成本,而非智能体数量
分工协作也会增加AI的处理量,带来额外负担。Anthropic表示,这种方式可能消耗大量token,因此建议从小规模配置开始。Token是AI处理文本和代码的单位,也是考量使用成本时的参考指标。
企业需要判断的,与其说是能运行多少个AI,不如说是以多少成本获得所需质量的成果。即便能发现更多漏洞,成本和核查工作会增加多少,也会影响是否采用。比较单个智能体与少量智能体分工协作的配置在同一任务上的表现,并测量检测数量、耗时和成本,是更切实可行的做法。
所提供的资料没有列出此次对比测试的总成本、处理时间和token消耗量。能够确认的只有漏洞检测数量存在差异,结果并未证明其成本效益。

コメント