
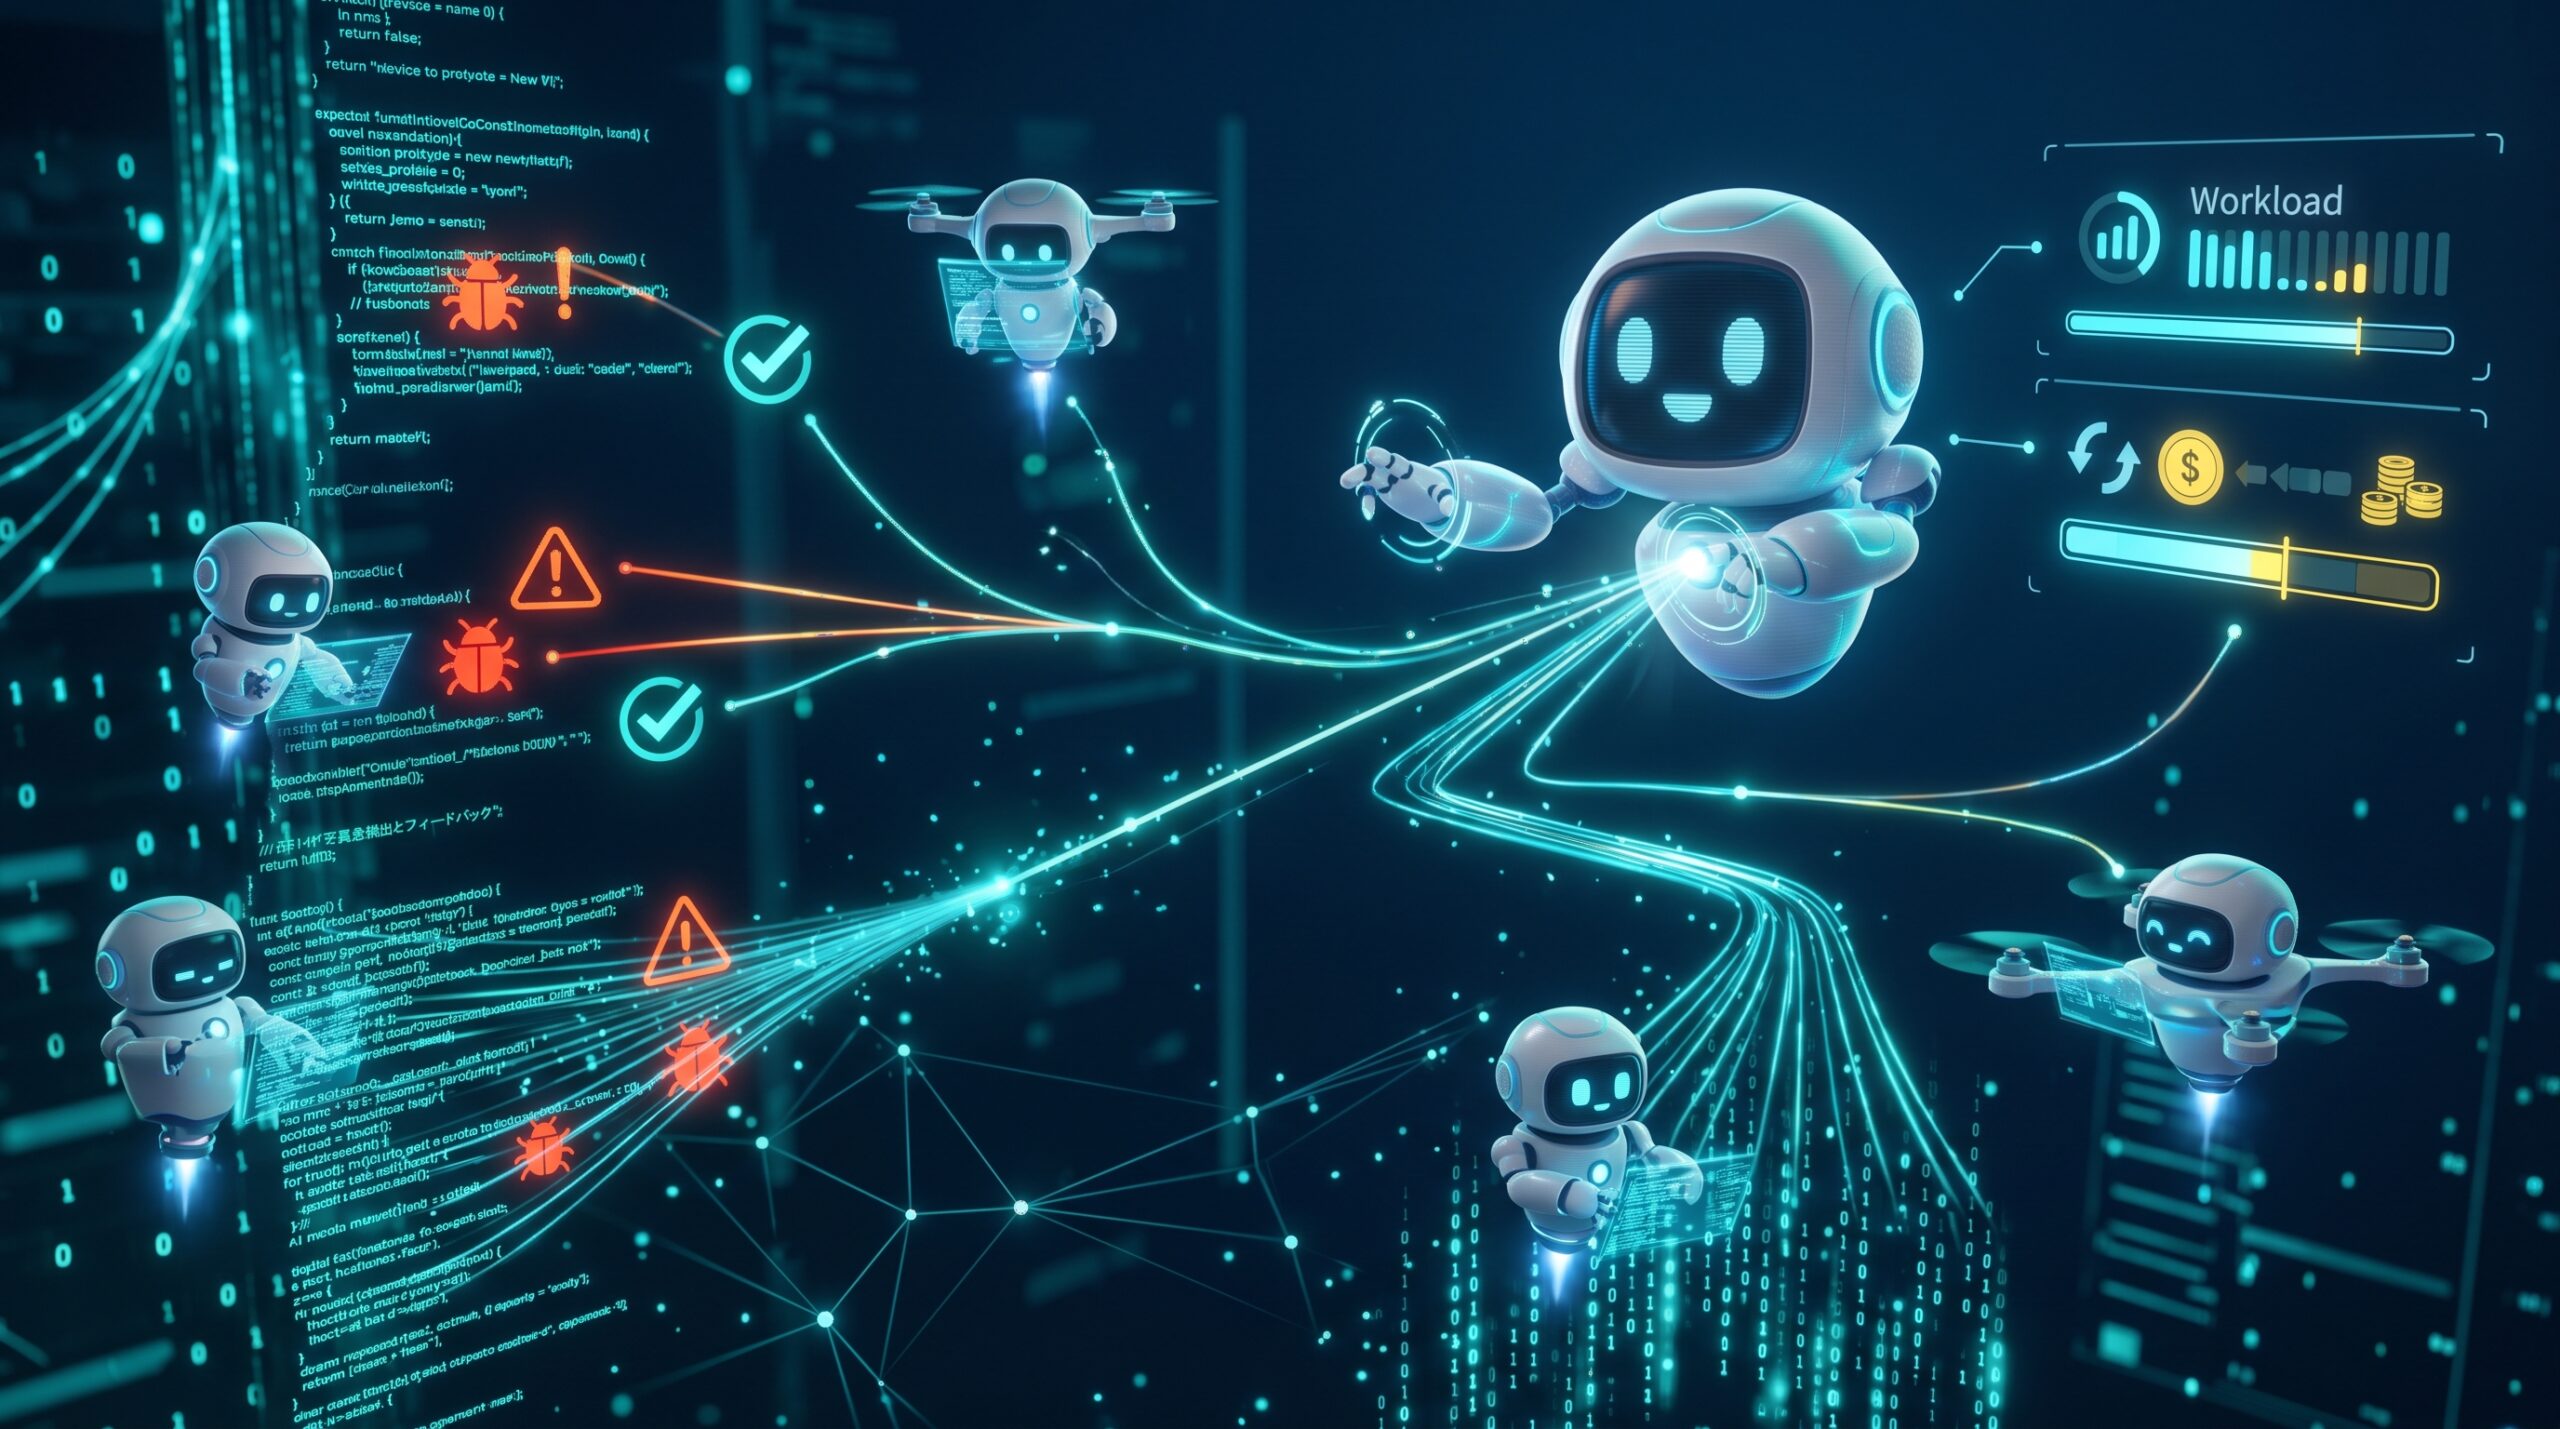
計画から仕事の割り振りまでAIが担う
Anthropicは、AIエージェントの実行基盤「Claude Managed Agents」に、複数のエージェントで作業を分担する動的ワークフローを追加しました。指揮役のエージェントが計画を立て、子エージェントに仕事を割り振り、結果を統合します。1回の実行で最大1000のエージェントを並列稼働させられます。
AIエージェントとは、与えられた目標に向けて作業を進めるAIです。今回の追加機能では、一つのエージェントにすべてを任せるのではなく、指揮役と実務担当に分けます。既存の実行基盤に、複数のAIをまとめて動かす仕組みが加わった形です。
注目したいのは、1000という上限だけではありません。仕事の分割と結果の取りまとめをAI側が担う点です。ただし、並列で動かせる数は、そのまま処理速度や成果の倍率を意味するものではありません。
70件のバグのうち66件を検出
Anthropicが示したテストでは、11万6000行のコードに70件のバグを意図的に埋め込み、検出結果を比較しています。単独のエージェントが1回の実行で見つけたのは14〜27件だったのに対し、動的ワークフローでは一貫して66件を検出したとされています。
検出率に換算すると、単独では約20〜39%、動的ワークフローでは約94%です。このテストでは、複数のエージェントによる分業が検出件数の増加につながっています。一方、66件という結果でも、用意されたバグすべてを見つけたわけではありません。
また、この結果はコードのバグ検出という特定の課題で得られたものです。調査、文書作成など別の仕事でも同様の差が出るかは確認できません。テストで実際に何体のエージェントを使ったかも、提供資料には記載がなく、1000体を動かした成果と受け取るのは早計です。
導入の物差しは人数より成果あたりの費用
分業には、AIの処理量が増えるという負担もあります。Anthropicは大量のトークンを消費する可能性があるとして、小規模な構成から始めるよう勧めています。トークンはAIが扱う文章やコードの処理単位で、利用費用を考える際の指標になります。
企業が判断したいのは、何体のAIを動かせるかより、必要な品質の成果をいくらで得られるかです。バグを多く見つけられても、費用や確認作業がどれだけ増えるかで採用の判断は変わります。単独エージェントと少数の分業構成を同じ課題で比べ、検出件数、所要時間、費用を測るのが現実的です。
提供資料には、今回の比較テストにおける総費用、処理時間、トークン消費量は示されていません。確認できるのはバグ検出件数の差であり、費用対効果まで実証された結果ではありません。

コメント