
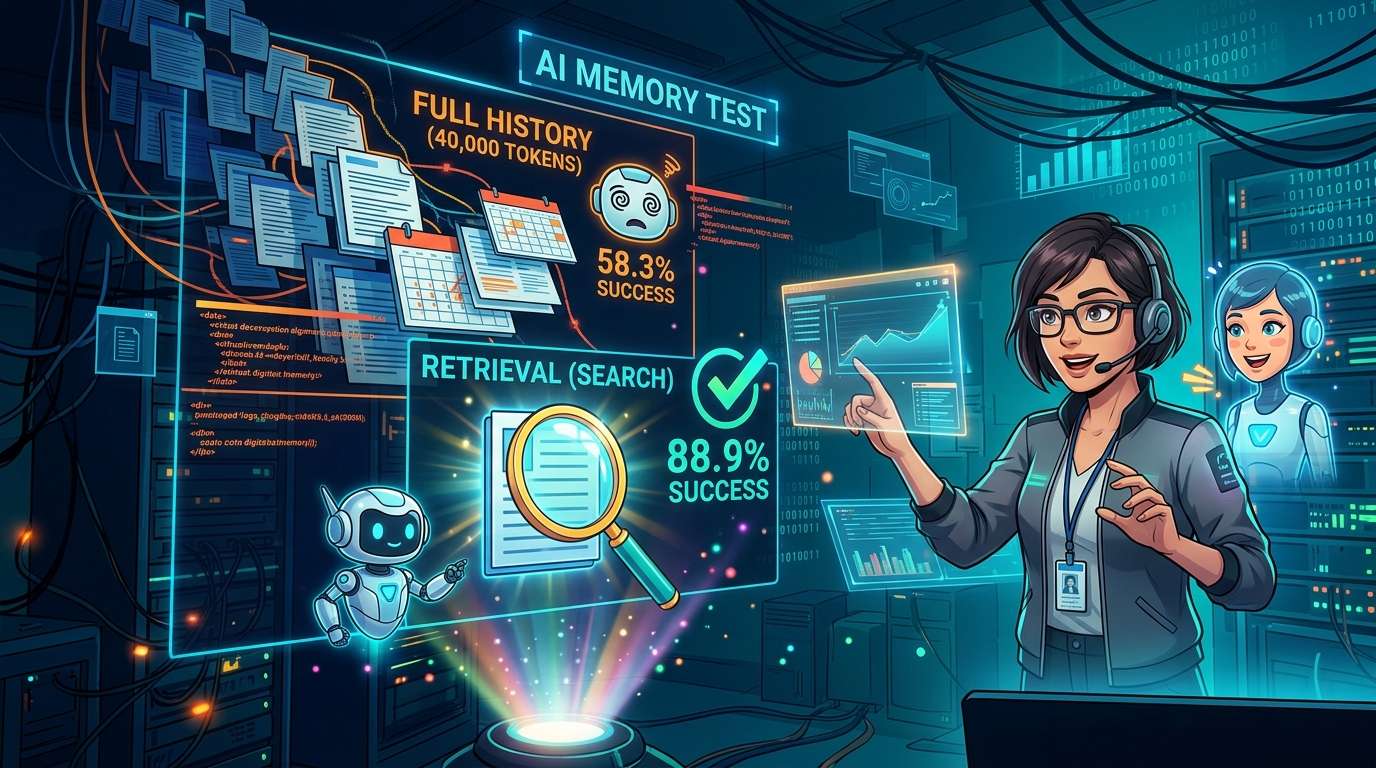
Sebuah pengujian yang membandingkan empat cara untuk membekali asisten AI dengan “memori” dimuat di media ilmu data Towards Data Science. Dalam uji coba yang menggunakan riwayat sekitar 40 ribu token dari seorang manajer proyek fiktif dan 30 permintaan, tingkat keberhasilan kerja GPT-4o mini mencapai 58,3% dengan metode memberikan seluruh riwayat, dan 88,9% dengan metode pencarian yang hanya mengambil bagian yang diperlukan.
“Mengingat” dan “mampu menggunakan” adalah dua hal berbeda
Titik awal pengujian ini adalah “DolphinBench”, sebuah tes baru untuk mengukur kemampuan AI dalam mengingat. Artikel lengkapnya dapat dibacadi artikel pengujian ini.
Sebagian besar tes memori konvensional mengajukan pertanyaan langsung tentang fakta di masa lalu, seperti “Kedai kopi mana yang disukai Sam?” Namun, pembuat DolphinBench menilai bahwa pertanyaan itu sendiri menjadi petunjuk bahwa “jawabannya tercatat di suatu tempat”. Karena itu, tes ini meminta AI melakukan pekerjaan—“pesankan kopi”—lalu memeriksa apakah AI menggunakan fakta yang benar.
Tes ini dirancang dengan memberikan riwayat percakapan sekitar 500 ribu token kepada masing-masing dari tiga tokoh fiktif, lalu memberikan 200 permintaan kepada tiap tokoh. Hasilnya harus dilaporkan bersama informasi tentang biaya dan waktu, bukan hanya akurasi.
Tes ini dibuat oleh perusahaan yang menjual sistem memori bernama Mem0. Dalam pengumumannya, konfigurasi perusahaan itu menempati posisi teratas dengan menyelesaikan 70,67% permintaan. Penulis pengujian ini tidak mereplikasi DolphinBench maupun menguji produk perusahaan tertentu. Mereka hanya meminjam gagasannya dan membuat eksperimen kecil sendiri.
Empat cara mengingat yang diuji pada Dana, manajer proyek fiktif
Tokoh utama eksperimen ini adalah Dana Whitfield, seorang manajer proyek fiktif. Peneliti menyiapkan riwayat percakapan selama satu tahun yang terdiri atas 80 percakapan, lalu menyisipkan sejumlah hal untuk diuji.
Riwayat selama satu tahun dan 30 permintaan
Riwayat tersebut berisi sekitar 40 ribu token. Sebanyak 30 percakapan masing-masing menyebutkan satu fakta, seperti tempat makan siang langganan, waktu rapat, tanggal peluncuran proyek, atau penanggung jawab. Sebelas percakapan kemudian mengubah fakta tersebut, sementara 39 sisanya berupa obrolan ringan tentang hal-hal seperti printer, kereta, dan cuaca. Percakapan sehari-hari sengaja dicampurkan agar fakta-fakta itu tidak terlalu menonjol.
Ada 30 permintaan. Masing-masing meminta pemanggilan salah satu alat untuk menjadwalkan rapat, memesan makanan, mengirim pesan, atau membagikan tugas. Sembilan di antaranya membutuhkan dua fakta, seperti penanggung jawab dan tanggal. Penilaian tidak didasarkan pada teks jawaban, melainkan hanya pada benar tidaknya nilai yang diberikan kepada alat. Untuk setiap fakta, peneliti juga menyiapkan satu pertanyaan biasa untuk melihat apakah model dapat menjawab dengan nilai terbaru.
Empat metode yang dibandingkan
Ada empat metode: “tanpa memori”, yakni tidak memberikan informasi apa pun; “seluruh riwayat”, yakni memberikan seluruh riwayat 40 ribu token setiap kali; “ringkasan”, yakni membaca riwayat secara bertahap dan menyusun ulang ringkasan sekitar 1.000 kata; serta “pencarian”, yakni mengambil dan memberikan lima potongan riwayat yang paling relevan dengan permintaan.
Ibaratnya, perbedaannya adalah apakah setiap pagi kita memberikan seluruh buku harian selama setahun, memberikan selembar contekan yang dirangkum seseorang, atau mengambil hanya halaman yang relevan setiap kali ada permintaan.
Model yang digunakan adalah GPT-4o mini dari OpenAI dan Claude Haiku 4.5 dari Anthropic, dengan total 1.260 kali eksekusi. Catatan seluruh eksperimen disimpan di Weights & Biases, alat pengelolaan eksperimen.
コメント