
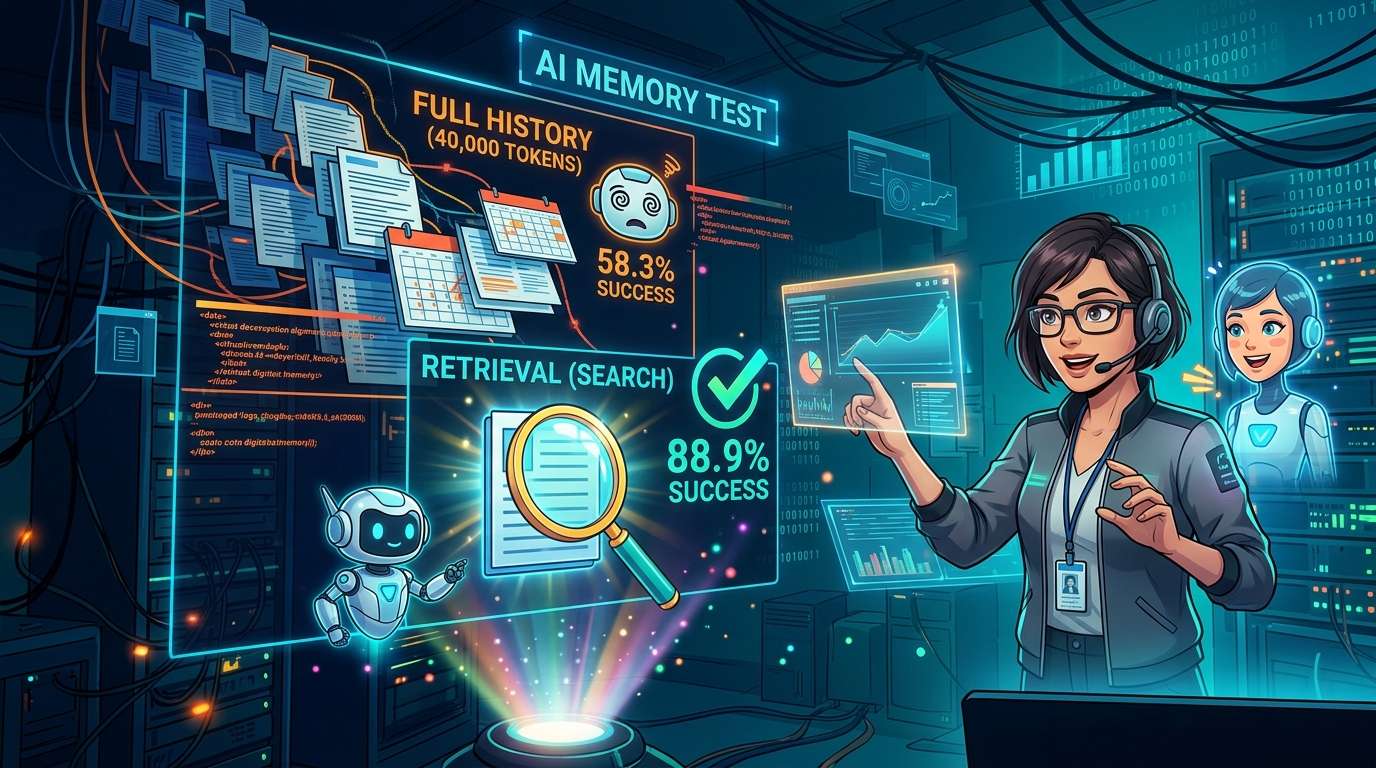
AI असिस्टेंट को “याददाश्त” देने के 4 तरीकों की तुलना करने वाला एक परीक्षण डेटा साइंस मीडिया आउटलेट Towards Data Science में प्रकाशित हुआ है। एक काल्पनिक प्रोजेक्ट मैनेजर के लगभग 40,000 टोकन वाले इतिहास और 30 अनुरोधों पर आधारित परीक्षण में, GPT-4o mini की कार्य सफलता दर पूरा इतिहास देने के तरीके में 58.3% रही, जबकि केवल ज़रूरी हिस्से खोजकर देने वाले तरीके में यह 88.9% थी।
“याद रखना” और “उसका इस्तेमाल कर पाना”—दो अलग बातें
इस परीक्षण की शुरुआत AI की स्मृति क्षमता मापने वाले नए टेस्ट “DolphinBench” से होती है। पूरा लेखइस परीक्षण लेख मेंपढ़ा जा सकता है।
स्मृति के कई पारंपरिक परीक्षण सीधे अतीत के तथ्यों के बारे में पूछते हैं, जैसे “सैम की पसंदीदा कॉफी शॉप कौन-सी है?” लेकिन DolphinBench के लेखकों का कहना है कि सवाल में ही यह संकेत मिल जाता है कि “जवाब कहीं दर्ज है।” इसीलिए इस टेस्ट में “कॉफी ऑर्डर करो” जैसा काम दिया जाता है और यह जांचा जाता है कि क्या सही तथ्य का इस्तेमाल किया गया।
इसकी रूपरेखा में 3 काल्पनिक लोगों में से हर एक के लिए लगभग 500,000 टोकन का बातचीत-इतिहास और प्रति व्यक्ति 200 अनुरोध रखे गए हैं। परिणामों में सटीकता के साथ लागत और समय की जानकारी भी देना अनिवार्य है।
यह टेस्ट Mem0 नाम की स्मृति प्रणाली बेचने वाली कंपनी ने बनाया है। कंपनी की घोषणा के मुताबिक, उसकी प्रणाली ने 70.67% अनुरोध सफलतापूर्वक पूरे करके पहला स्थान हासिल किया। परीक्षण करने वाले लेखक ने न तो DolphinBench को दोहराया और न ही किसी खास कंपनी के उत्पाद का परीक्षण किया। उन्होंने केवल इसकी अवधारणा लेकर अपना एक छोटा प्रयोग तैयार किया।
काल्पनिक प्रोजेक्ट मैनेजर डाना के साथ आज़माए गए स्मृति के 4 तरीके
इस प्रयोग का मुख्य पात्र काल्पनिक प्रोजेक्ट मैनेजर डाना व्हिटफील्ड है। एक साल के 80 बातचीत-सत्रों का इतिहास तैयार किया गया और उसमें जानबूझकर कुछ खास बातें शामिल की गईं।
एक साल का इतिहास और 30 अनुरोध
इतिहास लगभग 40,000 टोकन का है। इनमें से 30 बातचीत-सत्रों में एक-एक तथ्य बताया गया है—जैसे अक्सर जाने वाला दोपहर के भोजन का रेस्तरां, बैठक का समय, प्रोजेक्ट की लॉन्च तिथि या जिम्मेदार व्यक्ति। 11 सत्रों में बाद में उन तथ्यों को बदल दिया गया, जबकि बाकी 39 में प्रिंटर, ट्रेन और मौसम जैसी सामान्य बातचीत थी। तथ्यों को उभरकर न दिखने देने के लिए जानबूझकर रोज़मर्रा की बातें भी मिलाई गईं।
कुल 30 अनुरोध थे। इनमें बैठक तय करने, खाना ऑर्डर करने, संदेश भेजने या काम सौंपने के लिए किसी टूल को इस्तेमाल करना था। इनमें से 9 अनुरोधों में जिम्मेदार व्यक्ति और तारीख जैसे 2 तथ्यों की ज़रूरत थी। मूल्यांकन में जवाब के शब्दों को नहीं पढ़ा गया; केवल यह देखा गया कि टूल को दिए गए मान सही थे या नहीं। हर तथ्य के बारे में एक सीधा सवाल भी रखा गया, ताकि यह जांचा जा सके कि क्या मॉडल नवीनतम जानकारी के साथ जवाब दे सकता है।
तुलना किए गए 4 तरीके
4 तरीके थे। “कोई स्मृति नहीं” में कुछ भी नहीं दिया जाता; “पूरा इतिहास” में हर बार 40,000 टोकन का पूरा इतिहास दिया जाता; “सारांश” में इतिहास को चरणबद्ध तरीके से पढ़कर लगभग 1,000 शब्दों का सारांश बार-बार लिखा जाता; और “खोज” में अनुरोध से जुड़े इतिहास के 5 अंश निकालकर दिए जाते।
इसे ऐसे समझें: हर सुबह एक साल की पूरी डायरी थमा देना, किसी के बनाए एक पन्ने के चीट शीट को देना, या हर अनुरोध पर सिर्फ़ संबंधित पन्ने निकालकर देना।
मॉडल OpenAI का GPT-4o mini और Anthropic का Claude Haiku 4.5 थे। कुल 1,260 बार इन्हें चलाया गया। सभी प्रयोगों का रिकॉर्ड प्रयोग प्रबंधन टूल Weights & Biases में रखा गया है।
コメント