
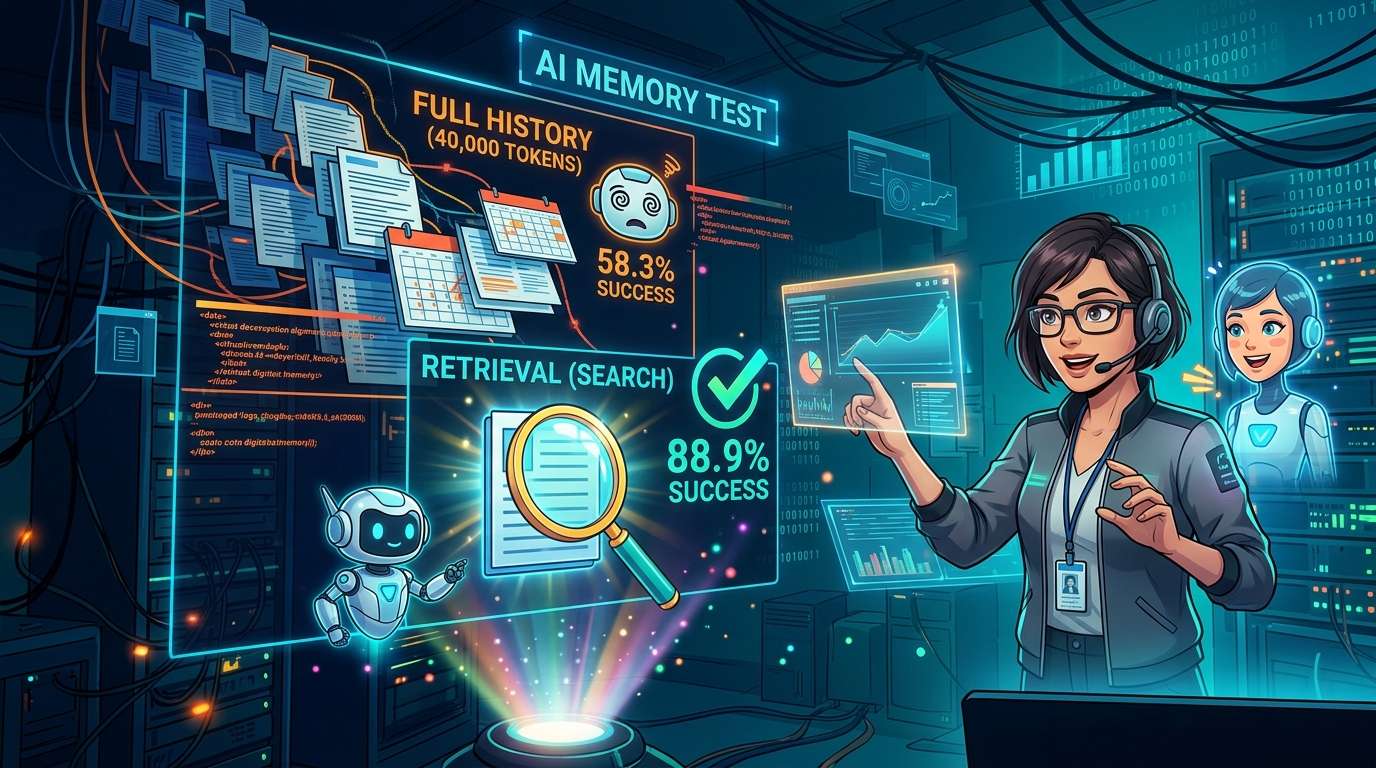
Eine Untersuchung, die vier Methoden vergleicht, KI-Assistenten ein „Gedächtnis“ zu geben, ist im Data-Science-Medium Towards Data Science erschienen. In einem Test mit dem rund 40.000 Token langen Gesprächsverlauf eines fiktiven Projektmanagers und 30 Aufträgen lag die Erfolgsquote von GPT-4o mini bei 58,3 %, wenn der gesamte Verlauf übergeben wurde, und bei 88,9 %, wenn per Suche nur die benötigten Teile herausgesucht und weitergegeben wurden.
„Sich erinnern“ und „das Erinnerte nutzen“ sind zwei verschiedene Dinge
Ausgangspunkt der Untersuchung ist DolphinBench, ein neuer Test zur Messung der Gedächtnisleistung von KI. Der vollständige Text istin diesem Untersuchungsartikelzu lesen.
Bei vielen herkömmlichen Gedächtnistests wird direkt nach Fakten aus der Vergangenheit gefragt, etwa: „In welches Café geht Sam gern?“ Die Entwickler von DolphinBench kritisieren jedoch, dass die Frage selbst bereits den Hinweis gibt, dass die Antwort irgendwo festgehalten wurde. Deshalb lautet der Auftrag bei diesem Test etwa: „Bestell einen Kaffee.“ So wird geprüft, ob das Modell die richtige Information tatsächlich verwenden kann.
Das Testdesign sieht drei fiktive Personen mit jeweils rund 500.000 Token Gesprächsverlauf und 200 Aufträgen pro Person vor. Die Ergebnisse müssen neben der Genauigkeit auch Kosten und Zeit ausweisen.
Der Test wurde von einem Unternehmen entwickelt, das das Gedächtnissystem Mem0 vertreibt. In der Veröffentlichung liegt die Konfiguration des Unternehmens mit 70,67 % erfolgreich erledigten Aufträgen auf Platz eins. Der Autor der Untersuchung hat DolphinBench weder reproduziert noch ein Produkt eines bestimmten Unternehmens getestet. Er übernahm lediglich die Grundidee und entwickelte ein eigenes kleines Experiment.
Vier Gedächtnistechniken im Test mit Dana, einer fiktiven Projektmanagerin
Im Mittelpunkt des Experiments steht Dana Whitfield, eine fiktive Projektmanagerin. Der Autor stellte einen Gesprächsverlauf aus einem Jahr mit 80 Einträgen zusammen und baute darin gezielt Details ein.
Ein Jahr Gesprächsverlauf und 30 Aufträge
Der Verlauf umfasst rund 40.000 Token. 30 Einträge nennen jeweils eine Tatsache, etwa Danas Stammrestaurant zum Mittagessen, eine Besprechungszeit, den Veröffentlichungstermin eines Projekts oder die zuständige Person. In 11 weiteren Einträgen werden diese Fakten später geändert; die übrigen 39 enthalten Smalltalk über Dinge wie Drucker, Züge oder das Wetter. Damit die Fakten nicht auffallen, wurden absichtlich alltägliche Gespräche eingestreut.
Es gab 30 Aufträge. Sie erforderten den Aufruf eines Tools zum Ansetzen von Besprechungen, Bestellen von Essen, Versenden von Nachrichten oder Zuweisen von Aufgaben. Bei 9 davon waren zwei Fakten nötig, etwa eine zuständige Person und ein Datum. Bewertet wurde ausschließlich, ob die an das Tool übergebenen Werte korrekt waren – der Wortlaut der Antwort blieb unberücksichtigt. Zu jeder der Fakten gab es außerdem eine normale Frage, mit der geprüft wurde, ob das Modell mit den jeweils neuesten Angaben antworten konnte.
Die vier verglichenen Methoden
Es wurden vier Methoden verglichen: „Kein Gedächtnis“, bei dem nichts übergeben wird; „Gesamter Verlauf“, bei dem jedes Mal der komplette Verlauf mit 40.000 Token übergeben wird; „Zusammenfassung“, bei der der Verlauf nach und nach gelesen und eine Zusammenfassung mit rund 1.000 Wörtern überarbeitet wird; und „Suche“, bei der fünf zum Auftrag passende Ausschnitte aus dem Verlauf herausgesucht und übergeben werden.
Anschaulich gesagt geht es darum, ob man jeden Morgen ein ganzes Jahr Tagebuch aushändigt, einen von jemandem zusammengestellten Spickzettel auf einer Seite bekommt oder für jeden Auftrag nur die passenden Seiten heraussucht.
Als Modelle kamen GPT-4o mini von OpenAI und Claude Haiku 4.5 von Anthropic zum Einsatz; insgesamt gab es 1.260 Durchläufe. Die Aufzeichnungen zu allen Experimenten sind im Experimentverwaltungstool Weights & Biases hinterlegt.
コメント