
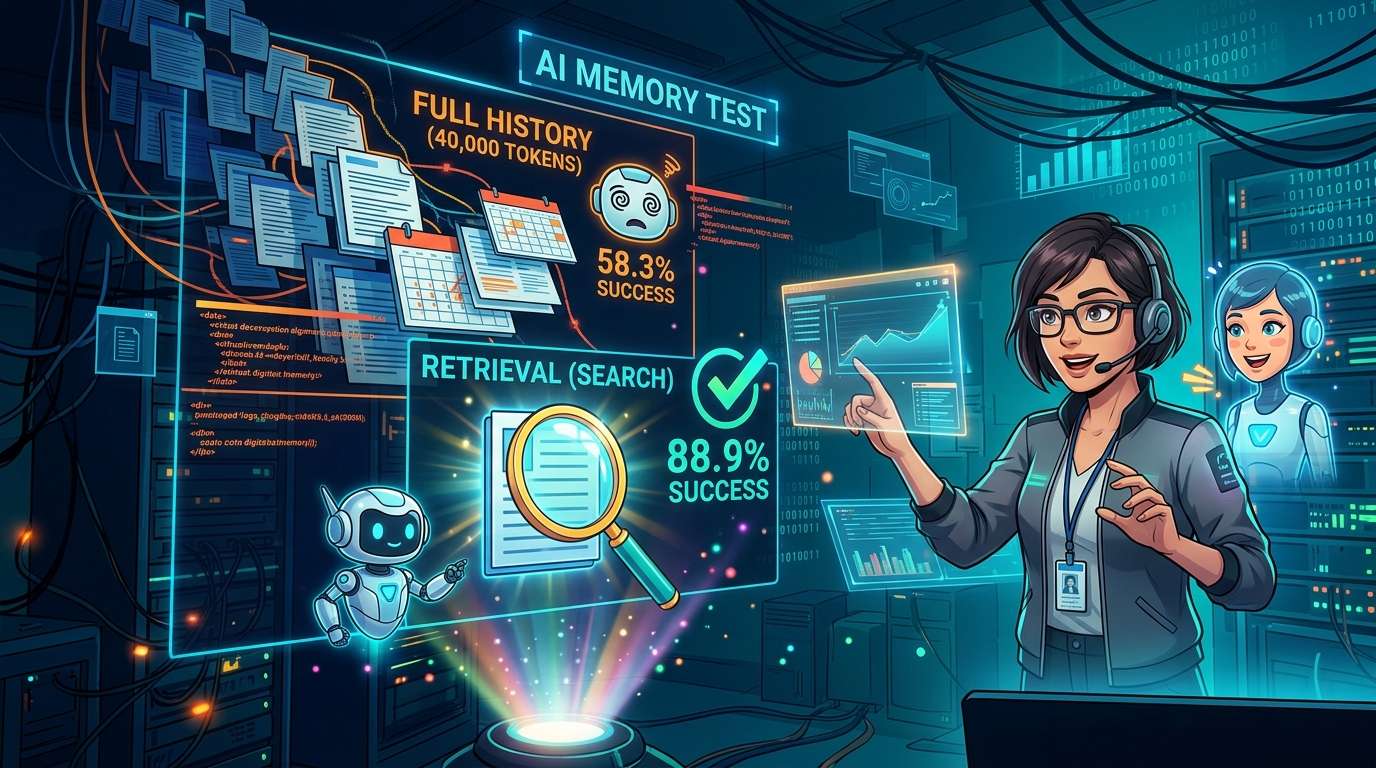
A publicação de ciência de dados Towards Data Science publicou um teste que compara quatro formas de dotar assistentes de IA de «memória». Num ensaio com o histórico de cerca de 40 mil tokens de um gestor de projetos fictício e 30 pedidos, o GPT-4o mini teve uma taxa de sucesso na execução das tarefas de 58,3% quando recebeu o histórico completo e de 88,9% quando recebeu apenas os excertos relevantes, encontrados através de pesquisa.
«Lembrar-se» e «saber usar» são coisas diferentes
O ponto de partida do teste é o «DolphinBench», um novo teste para medir a capacidade de memória da IA. O texto completo está disponívelneste artigo sobre o teste.
Muitos dos testes de memória tradicionais fazem perguntas diretas sobre factos passados, como «Qual é o café preferido do Sam?». Os criadores do DolphinBench consideram problemático que a própria pergunta dê a entender que a resposta está registada algures. Por isso, neste teste, pede-se à IA que realize uma tarefa — «Encomenda café» — e verifica-se se conseguiu utilizar o facto correto.
O teste prevê que três pessoas fictícias tenham, cada uma, um histórico de conversas com cerca de 500 mil tokens, e que lhes sejam feitos 200 pedidos. Os resultados devem incluir não só a precisão, mas também os custos e o tempo.
O teste foi criado por uma empresa que comercializa o sistema de memória Mem0. Na apresentação, a configuração da empresa ficou em primeiro lugar, com 70,67% dos pedidos concluídos com sucesso. O autor do teste aqui descrito não tentou reproduzir o DolphinBench nem testou o produto de uma empresa específica. Inspirou-se apenas na abordagem e criou uma pequena experiência própria.
Quatro métodos de memória testados com Dana, uma gestora de projetos fictícia
A protagonista da experiência é Dana Whitfield, uma gestora de projetos fictícia. Foi criado um histórico de conversas de um ano, com 80 entradas, no qual foram introduzidos alguns elementos deliberados.
Um ano de histórico e 30 pedidos
O histórico tem cerca de 40 mil tokens. Em 30 das entradas é referido, em cada uma, um facto — como o restaurante onde costuma almoçar, a hora de uma reunião, a data de lançamento de um projeto ou a pessoa responsável. Outras 11 entradas alteram posteriormente esses factos, e as 39 restantes são conversas triviais sobre temas como impressoras, comboios e o tempo. Para que os factos não se destacassem, foram misturados de propósito com conversas do dia a dia.
São 30 pedidos. Cada um implica usar uma ferramenta para marcar uma reunião, encomendar uma refeição, enviar uma mensagem ou atribuir uma tarefa; nove deles exigem dois factos, como a pessoa responsável e a data. A avaliação não teve em conta o texto da resposta: baseou-se apenas na exatidão dos valores enviados à ferramenta. Foi também preparada uma pergunta direta para cada facto, a fim de verificar se o sistema conseguia responder com o valor mais recente.
Os quatro métodos comparados
Foram comparados quatro métodos: «Sem memória», sem fornecer informação; «Histórico completo», com os 40 mil tokens do histórico fornecidos na íntegra a cada pedido; «Resumo», que lê o histórico por etapas e vai reescrevendo um resumo de cerca de mil palavras; e «Pesquisa», que seleciona cinco excertos do histórico relacionados com o pedido.
É como entregar todas as manhãs o diário de um ano inteiro, uma folha de consulta preparada por alguém ou apenas as páginas relevantes para cada pedido.
Os modelos utilizados foram o GPT-4o mini, da OpenAI, e o Claude Haiku 4.5, da Anthropic, num total de 1.260 execuções. Os registos de todas as experiências estão disponíveis na ferramenta de gestão de experiências Weights & Biases.
コメント