
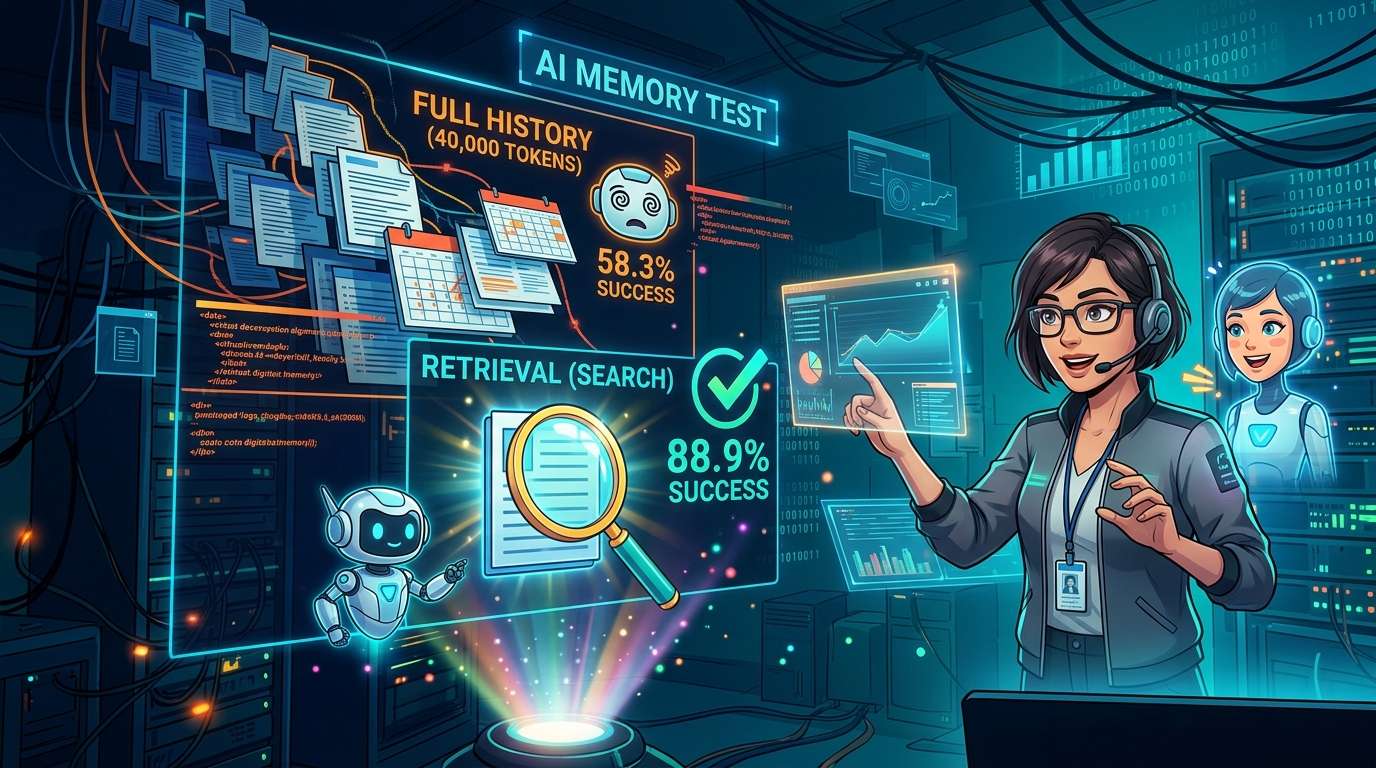
AIアシスタントに「記憶」を持たせる4つの方法を比べた検証が、データサイエンス系メディアのTowards Data Scienceに掲載されました。架空のプロジェクトマネジャーの約4万トークンの履歴と30件の依頼を使った試験で、GPT-4o miniの作業成功率は、履歴を丸ごと渡す方式で58.3%、必要な部分だけ探して渡す検索方式で88.9%でした。
「覚えている」と「使える」は別の話
検証の出発点は、AIの記憶性能を測る新しいテスト「DolphinBench」です。全文はこちらの検証記事で読めます。
従来の記憶テストの多くは「サムが好きなコーヒー店はどこか」のように、過去の事実を直接尋ねます。ただ、DolphinBenchの作者は、質問そのものが「どこかに答えが記録されている」というヒントになってしまう点を問題にしています。そこでこのテストでは「コーヒーを注文して」と仕事を頼み、正しい事実を使えたかどうかを確かめます。
3人の架空の人物にそれぞれ約50万トークンの会話履歴を持たせ、1人あたり200件の依頼を課す設計です。結果は精度だけでなく、費用と時間も併せて報告する決まりになっています。
このテストはMem0という記憶システムを販売する企業が作ったもので、発表では同社の構成が70.67%の依頼を成功させて首位に立っています。検証した筆者はDolphinBenchの再現も、特定企業の製品のテストも行っていません。考え方だけを借りて、小さな実験を自作しました。
架空のプロジェクトマネジャー、ダナで試した4通りの記憶術
実験の主役は、架空のプロジェクトマネジャーのダナ・ウィットフィールドです。1年分・80件の会話履歴を用意し、そこに仕掛けを仕込みました。
1年分の履歴と30件の依頼
履歴は約4万トークンです。うち30件がそれぞれ1つの事実(行きつけの昼食店、会議の時間、プロジェクトの公開日、担当者など)を述べています。11件はその事実を後から変更する内容で、残る39件はプリンターや電車、天気の話といった雑談です。事実が目立たないよう、わざと日常会話を混ぜています。
依頼は30件。会議の設定、食事の注文、メッセージ送信、タスクの割り当てのいずれかのツールを呼び出す形で、うち9件は担当者と日付のように2つの事実を必要とします。採点は返信の文面を読まず、ツールに渡された値が正しいかどうかだけで決めました。同じ事実についての通常の質問も1問ずつ用意し、最新の値で答えられるかも見ています。
比べた4つの方式
方式は4つです。何も渡さない「記憶なし」、4万トークンの履歴を毎回丸ごと渡す「全履歴」、履歴を段階的に読んで約1,000語の要約を書き直していく「要約」、依頼に近い履歴の断片を5つ取り出して渡す「検索」。
たとえるなら、1年分の日記を毎朝まるごと手渡すか、誰かがまとめた1枚のカンニングペーパーを渡すか、依頼のたびに該当ページだけ抜き出すか、という違いです。
モデルはOpenAIのGPT-4o miniとAnthropicのClaude Haiku 4.5で、実行は合計1,260回。全実験の記録は、実験管理ツールのWeights & Biasesに残されています。
コメント