
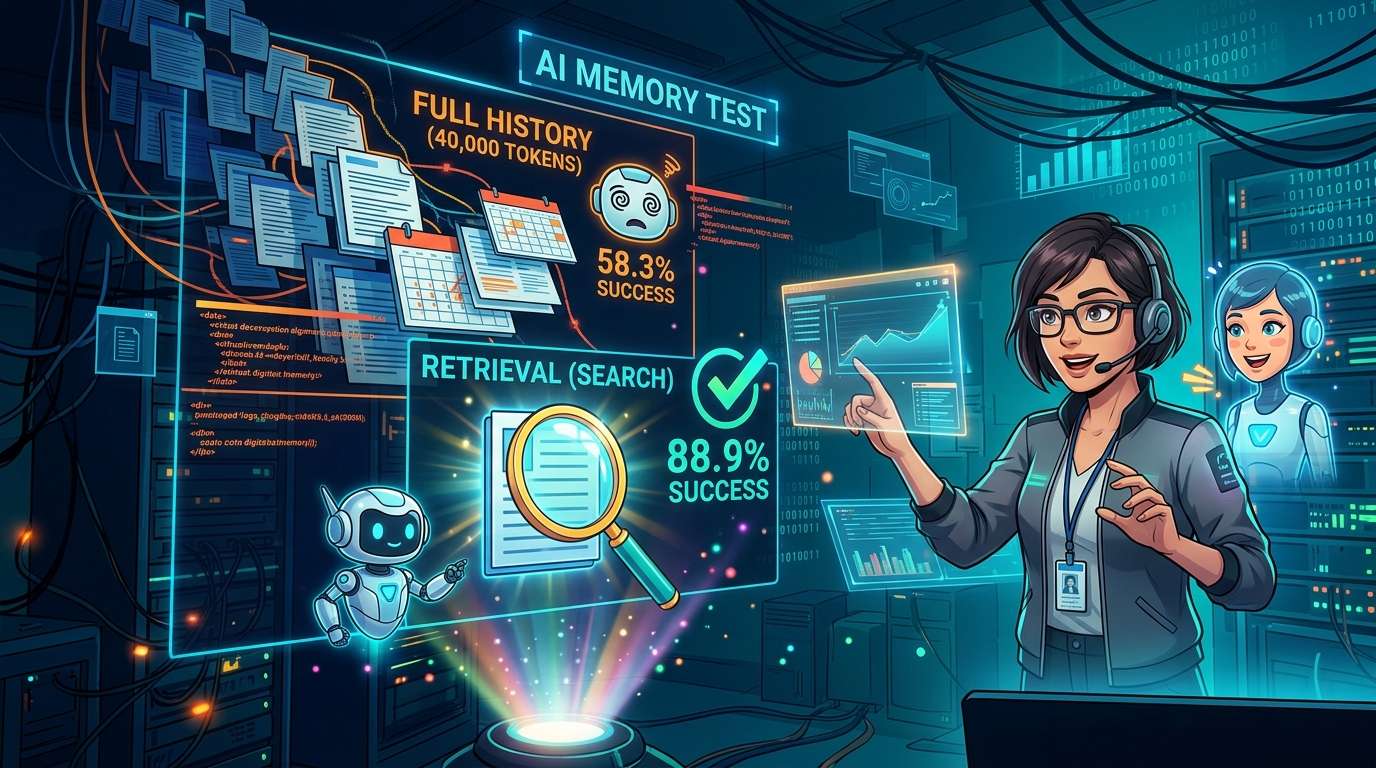
نشرت منصة Towards Data Science المتخصصة في علوم البيانات اختباراً يقارن أربع طرق لمنح المساعدين بالذكاء الاصطناعي «ذاكرة». وفي تجربة استخدمت سجلاً من نحو 40 ألف رمز لمدير مشاريع افتراضي و30 طلباً، بلغ معدل نجاح GPT-4o mini في إنجاز المهام 58.3٪ عند تمرير سجل المحادثات كاملاً، مقابل 88.9٪ عند استخدام أسلوب البحث الذي يستخرج الأجزاء المطلوبة فقط.
«التذكّر» و«القدرة على الاستفادة» أمران مختلفان
ينطلق الاختبار من معيار جديد لقياس أداء ذاكرة الذكاء الاصطناعي يُسمى «DolphinBench». النص الكاملمتاح في مقال الاختبار هذاللقراءة.
تكتفي اختبارات الذاكرة التقليدية في معظمها بطرح أسئلة مباشرة عن حقائق سابقة، مثل: «ما مقهى القهوة الذي يفضله سام؟». لكن مبتكري DolphinBench يرون مشكلة في أن السؤال نفسه يلمّح إلى أن الإجابة مسجلة في مكان ما. لذلك يطلب الاختبار تنفيذ مهمة، مثل «اطلب القهوة»، ثم يتحقق مما إذا كان النموذج قد استخدم الحقيقة الصحيحة.
صُمم الاختبار بحيث تكون لدى ثلاثة أشخاص افتراضيين سجلات محادثات يبلغ حجم كل منها نحو 500 ألف رمز، مع تكليف كل شخص بـ200 طلب. ويُشترط الإبلاغ عن النتائج إلى جانب الدقة، بما في ذلك التكلفة والوقت.
ابتكرت هذا الاختبار شركة تبيع نظام ذاكرة يُسمى Mem0، وأعلنت أن إعدادها حقق المركز الأول، إذ نجح في تنفيذ 70.67٪ من الطلبات. لكن كاتب المقال الذي أجرى الاختبار لم يحاول إعادة إنتاج DolphinBench، ولم يختبر منتج شركة بعينها؛ بل استعان بفكرته فحسب، وصمم تجربة صغيرة بنفسه.
أربع طرق للذاكرة اختُبرت على دانا، مديرة مشاريع افتراضية
محور التجربة هو دانا ويتفيلد، مديرة مشاريع افتراضية. أُعد سجل محادثات يغطي عاماً كاملاً ويضم 80 محادثة، مع دسّ بعض التفاصيل فيه.
سجل يمتد عاماً و30 طلباً
يبلغ حجم السجل نحو 40 ألف رمز. وتتضمن 30 محادثة منه، في كل منها حقيقة واحدة، مثل مطعم الغداء الذي ترتاده دانا، أو موعد اجتماع، أو تاريخ إطلاق مشروع، أو الشخص المسؤول عنه. وتحتوي 11 محادثة على تغييرات لاحقة في تلك الحقائق، فيما تتناول المحادثات الـ39 المتبقية أحاديث عابرة عن أمور مثل الطابعة والقطار والطقس. وأُدرجت الأحاديث اليومية عمداً حتى لا تبرز الحقائق.
أما الطلبات فعددها 30، وتستدعي استخدام إحدى الأدوات التالية: جدولة اجتماع، أو طلب وجبة، أو إرسال رسالة، أو إسناد مهمة. ويتطلب 9 منها حقيقتين، مثل اسم الشخص المسؤول والتاريخ. ولم يعتمد التقييم على قراءة نص الرد، بل اقتصر على التحقق من صحة القيم التي أُرسلت إلى الأدوات. كما أُعدّ سؤال عادي واحد عن كل حقيقة لاختبار قدرة النموذج على الإجابة بأحدث قيمة.
الطرق الأربع محل المقارنة
كانت هناك أربع طرق: «بلا ذاكرة»، من دون تمرير أي معلومات؛ و«السجل الكامل»، بتمرير سجل المحادثات البالغ 40 ألف رمز كاملاً في كل مرة؛ و«التلخيص»، عبر قراءة السجل تدريجياً وإعادة صياغة ملخص من نحو 1,000 كلمة؛ و«البحث»، عبر استخراج خمسة مقاطع من السجل مرتبطة بالطلب وتمريرها.
يمكن تشبيه الفرق بين هذه الطرق بتسليم شخص يومياً مذكرات عام كامل، أو ورقة غش من صفحة واحدة أعدّها شخص آخر، أو انتقاء الصفحات ذات الصلة فقط عند كل طلب.
كان النموذجان المستخدمان GPT-4o mini من OpenAI وClaude Haiku 4.5 من Anthropic، ونُفذت التجربة 1,260 مرة إجمالاً. وسُجلت تفاصيل جميع التجارب على منصة إدارة التجارب Weights & Biases.
コメント