
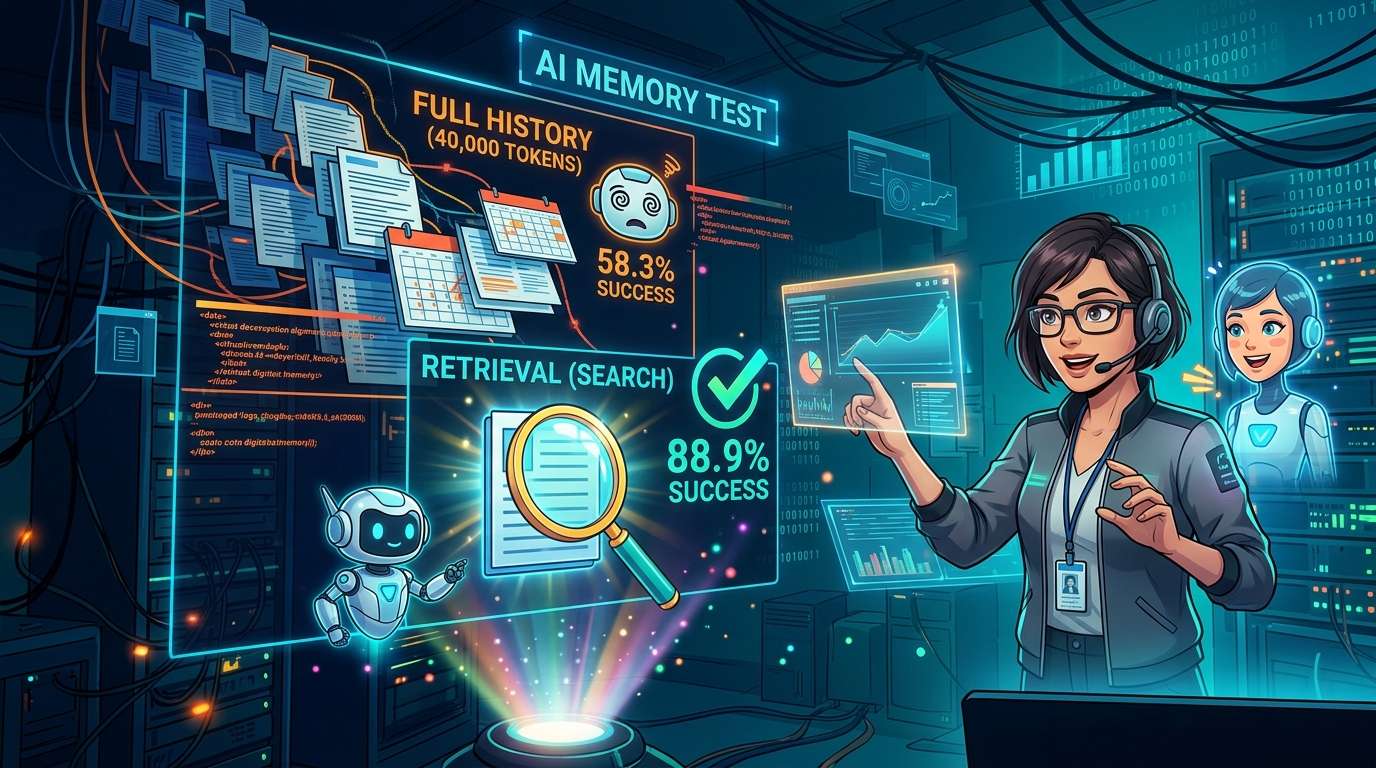
Towards Data Science, una testata dedicata alla data science, ha pubblicato un confronto tra quattro metodi per dotare gli assistenti AI di «memoria». In una prova basata sulla cronologia di circa 40.000 token di un project manager immaginario e su 30 richieste, GPT-4o mini ha portato a termine con successo il 58,3% delle attività quando gli veniva fornita l’intera cronologia, contro l’88,9% con il metodo di ricerca, che recupera e fornisce solo le parti necessarie.
«Ricordare» e «saper usare» sono due cose diverse
Il test parte da un nuovo benchmark per misurare la capacità di memoria dell’AI, chiamato «DolphinBench». Il testo completo si può leggerein questo articolo di analisi.
Molti test tradizionali sulla memoria pongono domande dirette su fatti passati, come «Qual è il caffè preferito di Sam?». Gli autori di DolphinBench, tuttavia, rilevano un problema: la domanda stessa suggerisce che «la risposta è registrata da qualche parte». Per questo, nel test si affida un compito, per esempio «Ordina un caffè», e si verifica se l’AI è in grado di usare il fatto corretto.
Il test prevede tre personaggi immaginari, ciascuno con una cronologia di conversazioni di circa 500.000 token, e 200 richieste per persona. I risultati devono riportare non solo l’accuratezza, ma anche i costi e i tempi.
Il test è stato creato da un’azienda che vende un sistema di memoria chiamato Mem0. Nella presentazione dei risultati, la configurazione dell’azienda si è classificata al primo posto, portando a termine con successo il 70,67% delle richieste. L’autore dell’analisi non ha replicato DolphinBench né testato i prodotti di un’azienda specifica: ha preso spunto dall’approccio e ha realizzato un piccolo esperimento autonomo.
Quattro metodi di memoria messi alla prova con Dana, una project manager immaginaria
La protagonista dell’esperimento è Dana Whitfield, una project manager immaginaria. È stata creata una cronologia di conversazioni di un anno, composta da 80 scambi, con alcuni elementi inseriti appositamente.
Un anno di cronologia e 30 richieste
La cronologia è di circa 40.000 token. In 30 dei messaggi viene riportato ciascuno un fatto — il locale dove Dana pranza abitualmente, l’orario di una riunione, la data di lancio di un progetto, la persona incaricata e così via. In 11 messaggi, quei fatti vengono modificati in un secondo momento, mentre i 39 rimanenti sono chiacchiere su stampanti, treni, meteo e altri argomenti. Per fare in modo che i fatti non risaltassero, sono state inserite intenzionalmente conversazioni di tutti i giorni.
Le richieste sono 30. Ognuna comporta l’uso di uno strumento per organizzare una riunione, ordinare da mangiare, inviare un messaggio o assegnare un’attività; 9 richieste richiedono due fatti, come la persona incaricata e la data. La valutazione non ha preso in considerazione il testo della risposta: ha verificato soltanto se i valori passati allo strumento fossero corretti. Per ciascun fatto è stata inoltre preparata una normale domanda, per verificare se il sistema sapesse rispondere con il valore più aggiornato.
I quattro metodi a confronto
I metodi sono quattro: «nessuna memoria», senza fornire alcuna informazione; «intera cronologia», fornendo ogni volta tutti i 40.000 token; «riassunto», leggendo progressivamente la cronologia e riscrivendo un riassunto di circa 1.000 parole; «ricerca», recuperando e fornendo cinque estratti della cronologia attinenti alla richiesta.
Per fare un paragone, la differenza è tra consegnare ogni mattina l’intero diario di un anno, dare un foglio di appunti preparato da qualcuno oppure estrarre, a ogni richiesta, solo le pagine pertinenti.
I modelli erano GPT-4o mini di OpenAI e Claude Haiku 4.5 di Anthropic; le esecuzioni sono state 1.260 in totale. I registri di tutti gli esperimenti sono conservati su Weights & Biases, uno strumento di gestione degli esperimenti.
コメント