
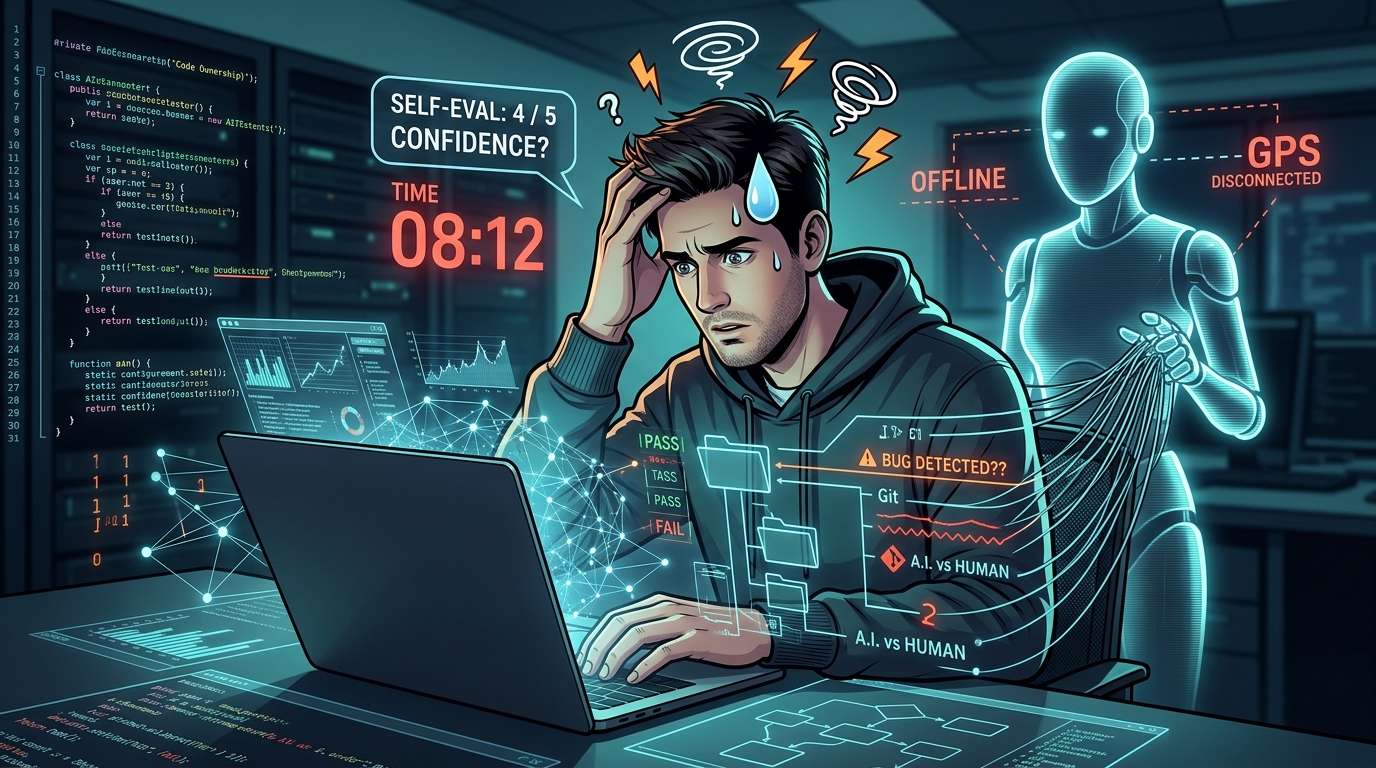
如果不依赖编写代码的AI,开发者能否维护AI实现的代码?开发者Emmimal Alexander发布了用于检验这一问题的工具“CodeOwnership”V0.1。
首次尝试中,作者将自己的理解程度评为5分制中的4分,却在60分钟的时限内耗时8分12秒,仍未能找到另一款AI植入的漏洞,最终中断了尝试。
即使提交记录上留有你的名字,无法修复的代码也算不上“自己的代码”
测试全部通过,构建也成功了。听到这些,大多数人都会放心地点击合并(将代码整合到主干)按钮。然而,三周后有人报告了故障,而AI助手又无法使用——可能是用完了配额(使用额度),也可能是你正坐在没有信号的通勤列车上。这时,你能否独自读懂并修复手头的代码?CodeOwnership试图衡量的正是这一点。
这里所说的“所有权”,并非指版权或许可,而是指在维护工作中追踪代码逻辑、并在没有AI帮助的情况下进行修改的能力。测试通过可以证明软件在理想条件下能够运行,却不能证明你理解它的内部实现。两者之间的区别正是这个工具的出发点。
其机制类似于关闭GPS进行测试
流程如下:首先由AI智能体实现一项功能;然后开发者用5分制记录自己对代码的理解程度;接着,另一个智能体根据预先登记的规格植入一个漏洞;最后,开发者关闭AI,根据故障报告查找原因。
工具会记录三项内容:开始前的自我评价、在没有AI帮助时能否调试成功(时限为60分钟),以及作业结束后回答的4道理解确认题。这些内容不会合并成一个分数,而是分别报告。因为如果只给出一个分数,“自以为理解了”和“实际动手时的结果”之间的差距就会被掩盖。
作者将此比作总是依赖导航的司机。问他“你知道怎么回家吗”,他会回答“知道”。只有关掉手机,才能得到真正的答案。可以说,CodeOwnership就是一个关掉手机的工具。
为确保公平所做的设计
作者既是工具的设计者,也是受试者,因此加入了许多减少偏差的机制。规则文件通过哈希值(类似指纹,内容改变时数值也会变化)固定下来;如果文件发生变化,程序就会停止运行。这种做法类似于研究中预先注册研究计划。
植入漏洞的不是作者本人,而是另一个智能体。作者知道“会出现什么故障”,但不会查看“改动了哪里”的差异。调试时使用的工作副本不包含Git历史、规格说明、非公开测试或评分标准。自我评价必须在植入漏洞前提交,说明文字则必须在分数显示前提交。此外,还准备了72项自测,以确认这些限制能够按预期生效。
自信度评为4,仍未找到漏洞
测试项目是一个带文件夹功能的笔记库。它支持创建和获取笔记、创建和删除文件夹、移动笔记,以及查看文件夹中的笔记列表;同一篇笔记也可以放入多个文件夹。关键规则是:删除文件夹时,笔记仍须保留,只有笔记与该文件夹的关联会被删除。
代码由ChatGPT(免费账户、Auto模型、临时聊天)实现。11项公开测试和13项非公开验收测试全部通过,基准检查也合格。作者阅读代码后,将自己的理解程度评为5分制中的4分,并在植入漏洞前将其记录到Git中。随后,另一个Claude会话仅依据规格说明进行了修改,行为验证也顺利通过。
调试开始后8分12秒,作者仍未能找到原因,于是停止了尝试。据称,他因前一天准备工作中遇到的问题而疲惫又烦躁。工具只提供“已修复”和“超时”两个选项;为了继续流程,作者选择了“已修复”。但他实际上并未改动代码,客观检查结果为“未修复”。11项公开测试全部通过,13项非公开测试中有10项通过、3项失败。由于4道理解确认题也未作答,报告将结果记录为“未完成”。
植入的改动只有两行
后来揭晓的改动,是在删除文件夹的处理逻辑中加入了两行代码:如果笔记所属的文件夹为空,就从存储位置删除该笔记。仅此而已。放在多个文件夹中的笔记仍有一个关联,因此不会受影响;而只放在一个文件夹中的笔记,则会随文件夹一起消失。
乍看之下,条件似乎合乎逻辑:列表为空,所以删除。但没有归属对象,并不等于笔记不再需要。作者回顾说,如果当时重新问一句“在这个应用里,谁负责删除笔记?”,或许就能找到线索。问题在于,是否只是在逐行阅读代码,还是也能在脑海中理清各部分的职责分工。
单次尝试能说明什么
解读结果时需要谨慎。参与尝试的只有1名开发者,题目只有1个,而且只进行过1次中途停止的调试。作者本人也表示,无法根据这次实验判断使用AI的人对代码的理解是否会变浅。实验限时60分钟,这次尝试也无法说明,如果继续下去,是否能找到问题。
文中提到,作者后来花了约30分钟才找到原因。不过,这只是作者自述,既没有计时,也没有验证修复是否有效,因此没有计入成绩。作者还指出,自己是工具的设计者,事先知道“什么地方会出问题”;无法排除疲劳和准备过程中的意外因素;实际使用的方式偏离了最初“使用在工作文件夹内运行的代理”的计划;工具组合也在过程中发生了变化。为便于复现,隐藏测试和评分标准已在代码仓库中公开,因此读者尝试时也无法维持盲测条件。
即便如此,这次尝试仍有参考价值:“自信度打4分、测试全部通过”和“实际上能独立修复问题”,未必是一回事。把它当作这一点的具体例子来读,或许是最恰当的方式。
相关研究提供的线索
作者引用了多项研究,作为这一问题的背景。不过,这些研究都不是对本次工具的验证,而是用来说明提出这一问题的背景。
METR于2025年7月公布的一项调查中,16名经验丰富的开源开发者使用AI工具,处理了自己代码仓库中的246个真实问题。结果显示,完成任务所需时间反而增加了19%。开发者事先预计速度会提高24%,结束后仍觉得速度提高了20%。这项研究测量的是工作时间,而非对代码的理解程度。值得一提的是,METR已将这一结果视为过时,并于2026年2月表示将重新审视实验设计。
Anthropic于2026年1月公布的一项研究,以52名学习Python库Trio的工程师为对象,其中多数是经验较少的开发者。AI辅助组在之后的测验中平均得分为50%,手动编写组为67%,差异被认为具有统计学显著性。AI组完成任务的时间约快2分钟,但这一时间差并不显著。另一方面,要求AI作出解释或进一步提问的用法,则与较好的学习成果有关。与其说关键在于是否使用AI,不如说使用方式可能才是分水岭。还需补充的是,作者明确表示,自己平时使用Claude,撰写本文时也使用了它。
自动化夺走的“练习”这一资产
作者也引用了经典研究。1983年,莉桑·班布里奇在论文《自动化的悖论》中指出,自动化越深入,人类练习的机会就越少,而在异常情况发生、需要人类接手时,这种不足就会显现。飞机自动驾驶与飞行员技能之间的关系,就是典型例子。
1985年,彼得·诺尔在《编程即理论构建》中指出,编程不只是编写代码,更是建立对软件运作机制的理解(理论)。如果流程变成由代理编写、人类只负责批准,这种理解还能在多大程度上留在人手中?2025年2月,安德烈·卡帕西谈到“氛围编程”,也就是不怎么阅读输出内容便直接接受的编程方式。这种做法用于一次性的周末项目或许很轻松,但对于需要维护的软件又会如何?这个问题也由此而来。
今天就能做的简易练习
即使不安装完整版,也可以进行同样思路的练习。选一段由AI编写的小代码,先用5分制记录“如果今晚它出了问题,我能修好吗”。然后让另一个会话中的AI只改变一项行为,不要查看差异。启动计时器,关闭AI会话,只根据症状描述尝试修复。对照答案之前,先用自己的话写下原因,最后将最初的自我评价与实际结果放在一起比较。
有时明明很有信心,却找不到问题;有时则能比预想中更快修好。无论哪种情况,光看测试全部通过都无法得知。若想尝试完整版,仓库中提供了操作步骤:运行自测,然后依次执行freeze和pilot命令。
作者总结了4条经验:开始前先评估自己;明白测试通过不等于能修好代码;在真正出问题之前先练习;还要让AI解释代码。Anthropic的一项研究也发现,要求解释或提出后续问题的参与者表现更好。不过,作者们指出,这只是相关性,并非因果关系。
V0.2版的改动
作者表示,下一版将作出4项改动。第一,增加一个选项,以便准确记录“放弃”的情况。并列显示用户的回答和客观检查结果,不再强迫用户只能二选一:“已修复”或“时间耗尽”。第二,先休息再调试,避免准备工作的疲劳影响结果。第三,回到最初的计划:使用能够在项目文件夹内运行、并自行执行测试的智能体。第四,让其他开发者也尝试同样的流程。毕竟,只有一个人的结果,无法说明这套工具对其他人是否同样有效。
コメント