
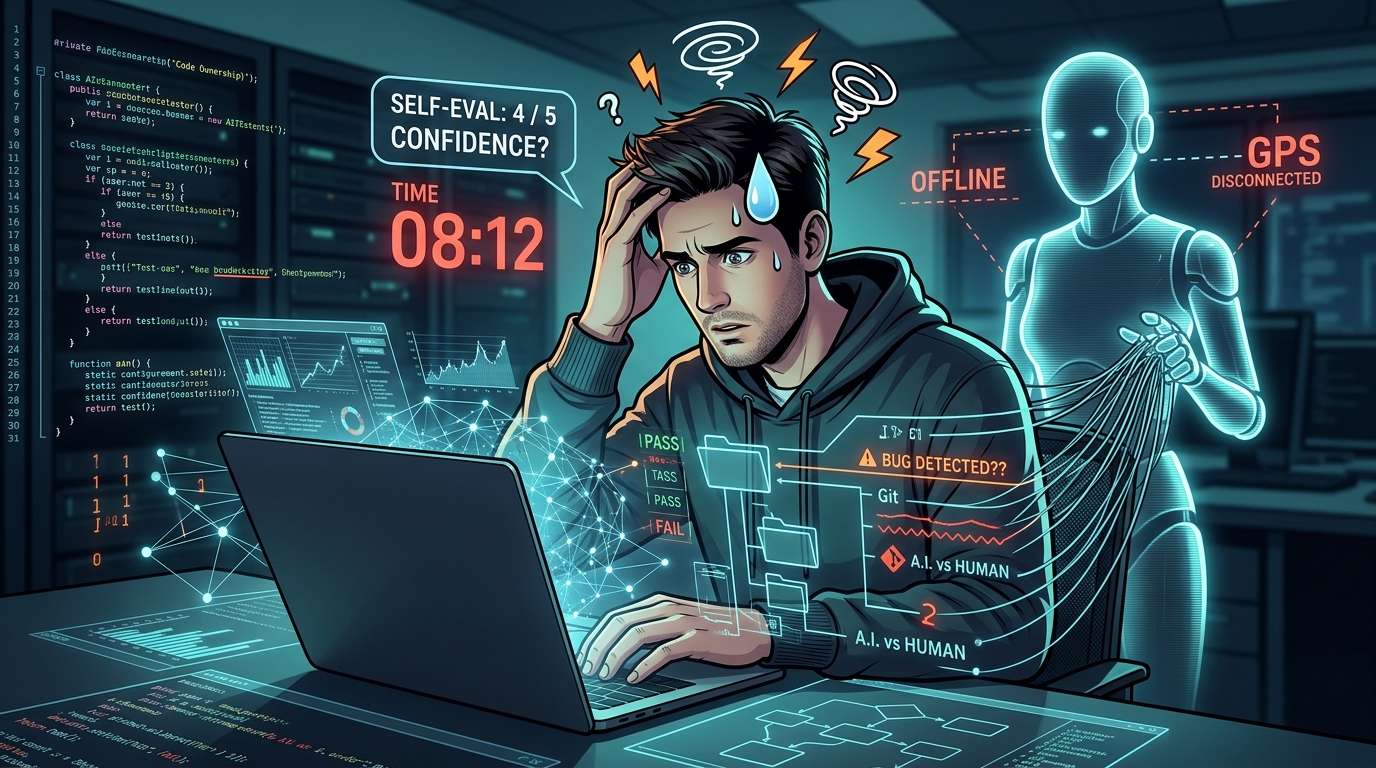
هل يمكن صيانة الشيفرة التي نفذها الذكاء الاصطناعي من دون الاستعانة بالذكاء الاصطناعي الذي كتبها؟ نشر المطور Emmimal Alexander الإصدار V0.1 من أداة الاختبار «CodeOwnership» لقياس ذلك.
في المحاولة الأولى، قيّم المطور فهمه للشيفرة بـ4 من 5، لكنه أنهى الاختبار بعد 8 دقائق و12 ثانية من دون أن يعثر على العطل الذي أدخله ذكاء اصطناعي آخر، رغم أن المهلة كانت 60 دقيقة.
حتى لو ظهر اسمك في سجل الالتزام، فالشيفرة ليست «شفرتك» إن لم تستطع إصلاحها
كانت جميع الاختبارات ناجحة، واجتاز البناء الاختبار أيضًا. عند سماع ذلك، يطمئن كثيرون ويضغطون زر الدمج (الإدماج في الفرع الرئيسي). لكن بعد 3 أسابيع يصل بلاغ عن خلل، ويكون مساعد الذكاء الاصطناعي غير متاح: ربما نفدت حصة الاستخدام، أو كنت في قطار أثناء التنقل لا تصل إليه إشارة. فهل تستطيع حينها فهم الشيفرة الموجودة أمامك وإصلاحها بنفسك؟ هذه النقطة تحديدًا هي ما تحاول «CodeOwnership» قياسه.
لا تتعلق «الملكية» هنا بحقوق النشر أو التراخيص، بل بالقدرة العملية على تتبع منطق الشيفرة وإصلاحها من دون مساعدة الذكاء الاصطناعي. اجتياز الاختبارات قد يثبت أن البرنامج يعمل في ظروف مواتية، لكنه لا يثبت فهمك لما يجري في داخله. وهذا التمييز هو نقطة الانطلاق.
آلية تشبه اختبارًا يُجرى بعد إيقاف GPS
تسير العملية على النحو التالي: ينفذ وكيل ذكاء اصطناعي ميزةً ما، ثم يسجل المطور مدى فهمه لها على مقياس من 5 درجات. بعد ذلك، يُدخل وكيل آخر عطلًا واحدًا فقط وفق مواصفات مسجلة مسبقًا. وأخيرًا، يحاول المطور تحديد السبب مستعينًا ببلاغ العطل، بينما يكون الذكاء الاصطناعي معطّلًا.
تُسجل 3 أمور: التقييم الذاتي قبل بدء العمل، ونجاح تصحيح العطل أو الإخفاق فيه من دون الذكاء الاصطناعي (بمهلة لا تتجاوز 60 دقيقة)، والإجابة عن 4 أسئلة للتحقق من الفهم بعد العمل. وتُعرض هذه النتائج منفصلة، ولا تُجمع في درجة واحدة، لأن الدرجة الواحدة قد تحجب الفجوة بين «ظننت أنني فهمت» والنتيجة الفعلية عند التعامل مع الشيفرة.
يشبّه المؤلف ذلك بسائق يعتمد دائمًا على نظام الملاحة. إذا سألته «هل تعرف الطريق إلى المنزل؟» أجاب «نعم». لكن الإجابة الحقيقية لا تظهر إلا بعد إيقاف هاتفه الذكي. ويمكن القول إن «CodeOwnership» أداة لإيقاف تشغيل ذلك الهاتف.
تدابير لضمان الإنصاف
المؤلف هو مصمم الأداة وأحد الخاضعين للاختبار في الوقت نفسه، ولذلك أُدرجت فيها تدابير عديدة للحد من التحيز. يُثبّت ملف القواعد باستخدام قيمة تجزئة (بصمة تتغير قيمتها عند تغير المحتوى)، ويُوقف التنفيذ إذا عُدّل الملف. وهذا قريب من فكرة التسجيل المسبق للخطة في الأبحاث.
لا يُدخل المؤلف العطل بنفسه، بل يتولى ذلك وكيل آخر. يعرف المؤلف السلوك الذي سيتعطل، لكنه لا يطّلع على الفروق التي تكشف مواضع التغيير. ولا تتضمن نسخة العمل المستخدمة أثناء تصحيح العطل سجل Git أو المواصفات أو الاختبارات الخاصة أو معايير التقييم. ويجب تسجيل التقييم الذاتي قبل إدخال العطل، وإيداع الشرح قبل ظهور الدرجات. كما أُعدّ 72 اختبارًا ذاتيًا للتحقق من عمل هذه القيود على النحو الصحيح.
الثقة: 4، لكن العطل لم يُكتشف
كان موضوع الاختبار مكتبة ملاحظات تتضمن وظيفة المجلدات. تتيح إنشاء الملاحظات واسترجاعها، وإنشاء المجلدات وحذفها، ونقل الملاحظات، وعرض قائمة بالملاحظات الموجودة في مجلد. كما يمكن وضع الملاحظة نفسها في عدة مجلدات. والقاعدة الأساسية هي أن حذف المجلد لا يحذف الملاحظات؛ بل يزيل ارتباطها بالمجلد فحسب.
تولى التنفيذ ChatGPT (حساب مجاني، والنموذج Auto، ومحادثة مؤقتة). اجتازت الاختبارات العامة الـ11 واختبارات القبول الخاصة الـ13 جميعها، كما اجتاز التطبيق التحقق من المعايير. وبعد قراءة الشيفرة، قيّم المؤلف فهمه لها بـ4 من 5 وسجل ذلك في Git قبل إدخال العطل. ثم أجرت جلسة منفصلة من Claude تعديلات استنادًا إلى المواصفات وحدها، واجتازت التعديلات أيضًا اختبار السلوك.
بعد 8 دقائق و12 ثانية من بدء تصحيح العطل، أوقف المؤلف العمل من دون أن يعثر على السبب. وذكر أنه كان متعبًا ومنزعجًا بسبب مشكلات في التحضير في اليوم السابق. لم تترك الأداة له سوى خيارين: «تم الإصلاح» أو «انتهت المهلة»، فاختار «تم الإصلاح» لمواصلة الاختبار. لكنه لم يغيّر الشيفرة، وأظهرت عملية التحقق الموضوعية أن العطل «لم يُصلح». اجتازت الاختبارات العامة الـ11 كلها، بينما اجتازت الشيفرة 10 من أصل 13 اختبارًا خاصًا وفشلت في 3. ولم تُجرَ أسئلة التحقق الأربعة من الفهم، لذلك سُجل التقرير على أنه «غير مكتمل».
التغيير الذي أُدخل لم يتجاوز سطرين
اتضح لاحقًا أن التغيير أضاف سطرين إلى عملية حذف المجلد: إذا أصبح المجلد فارغًا من الملاحظات المرتبطة به، تُحذف تلك الملاحظة من مكان تخزينها. هذا كل ما في الأمر. أما الملاحظات الموجودة في عدة مجلدات، فيبقى لها ارتباط واحد على الأقل، ولذلك لا تتأثر. لكن الملاحظة الموجودة في مجلد واحد فقط تُحذف مع المجلد.
تبدو الفكرة منطقية للوهلة الأولى: القائمة فارغة، لذا احذف. لكن عدم وجود جهة تتبعها لا يعني أن الملاحظات غير ضرورية. ويستذكر الكاتب أنه ربما كان سيهتدي إلى الخيط لو أعاد طرح السؤال: «من المسؤول عن حذف الملاحظات في هذا التطبيق؟». فالمطلوب لم يكن مجرد تتبّع نص الشيفرة، بل القدرة على تصور توزيع الأدوار.
ما الذي يمكن أن تكشفه محاولة شخص واحد؟
ينبغي توخي الحذر عند قراءة النتائج. فقد شارك مطوّر واحد، وكان موضوع التجربة واحدا، ولم تُجرَ سوى محاولة واحدة للتصحيح، توقفت في منتصفها. ويقرّ الكاتب نفسه بأن هذه التجربة لا تكفي للقول إن فهم مستخدمي الذكاء الاصطناعي للشيفرة يصبح أقل عمقا. كما أن المهلة كانت 60 دقيقة، ولا توضح هذه المحاولة ما إذا كان سيعثر على الخلل لو واصل العمل.
يذكر الكاتب أنه توصل إلى السبب لاحقا بعد نحو 30 دقيقة. لكن هذا إفادة ذاتية منه؛ فلم يقس الوقت، ولم يتحقق من الإصلاح، ولذلك لم تُحتسب النتيجة ضمن التقييم. ويشير أيضا إلى أنه، بصفته مصمم الأداة، كان يعرف «ما الذي سيتعطل»، وإلى تعذر فصل أثر الإرهاق ومشكلات الإعداد، وخروجه عن الخطة الأصلية التي كانت تقضي باستخدام وكيل يعمل داخل مجلد العمل، فضلا عن تغير مجموعة الأدوات المستخدمة في أثناء التجربة. ونظرا إلى نشر الاختبارات المخفية ومعايير التقييم في المستودع لضمان إمكانية إعادة التجربة، فهناك قيد آخر: لن يتمكن من يقرأها ثم يجربها من الحفاظ على شرط التعمية.
ومع ذلك، لهذه المحاولة الواحدة فائدة. فحالة «ثقتي 4 والاختبارات كلها ناجحة» لا تعني بالضرورة أن الشخص «قادر فعلا على الإصلاح بنفسه». ولعل قراءتها بوصفها مثالا ملموسا على ذلك هي الطريقة الأكثر إنصافا.
مؤشرات من الأبحاث ذات الصلة
يستشهد الكاتب بعدة دراسات لتوضيح خلفية هذا السؤال. لكنه لا يقدم أيا منها دليلا على فعالية الأداة المستخدمة هنا، بل يوردها في سياق توضيح دوافع طرح المسألة.
في دراسة نشرتها METR في يوليو 2025، استخدم 16 مطورا متمرسا لمشروعات مفتوحة المصدر أدوات الذكاء الاصطناعي لإنجاز 246 مهمة حقيقية في مستودعاتهم. وأظهرت النتائج أن الوقت اللازم لإتمام المهام زاد بنسبة 19%. وكان المطورون يتوقعون مسبقا أن يصبحوا أسرع بنسبة 24%، وشعروا بعد انتهاء التجربة بأنهم أسرع بنسبة 20%. لكن الدراسة تقيس الوقت المستغرق في العمل، لا مدى فهم الشيفرة. وقد وصفت METR هذه النتيجة بأنها أصبحت قديمة، وأعلنت في فبراير 2026 أنها ستعيد النظر في تصميم التجربة.
في دراسة نشرتها Anthropic في يناير 2026، شارك 52 مهندسا يتعلمون مكتبة Python المسماة Trio، وكان كثير منهم مطورين قليلي الخبرة. حصلت المجموعة التي استعانت بالذكاء الاصطناعي على متوسط 50% في اختبار لاحق، مقابل 67% للمجموعة التي كتبت الشيفرة يدويا؛ واعتُبر الفارق ذا دلالة إحصائية. وأنهت مجموعة الذكاء الاصطناعي المهمة قبل المجموعة الأخرى بنحو دقيقتين، لكن هذا الفارق في الوقت لم يكن ذا دلالة إحصائية. في المقابل، ارتبطت أساليب الاستخدام التي تضمنت طلب الشرح أو طرح أسئلة إضافية بمستويات تعلم أعلى. ويبدو أن طريقة الاستخدام، لا مجرد الاستعانة بالذكاء الاصطناعي، هي ما يصنع الفارق. ومن الجدير بالذكر أيضا أن الكاتب أوضح أنه يستخدم Claude عادة، وأنه استعان به في إعداد هذا المقال.
الأتمتة تسلبنا رصيد «التدريب»
ويستند الكاتب أيضا إلى دراسة كلاسيكية. ففي عام 1983، جادلت ليسان بينبريدج في ورقتها «مفارقات الأتمتة» (Ironies of Automation) بأن فرص الإنسان في التدريب تتناقص كلما تقدمت الأتمتة، وأن هذا النقص تظهر آثاره عندما يضطر الإنسان إلى تولي المهمة في الظروف غير المعتادة. والعلاقة بين الطيار الآلي ومهارات الطيارين مثال نموذجي على ذلك.
وفي عام 1985، كتب بيتر ناور في «البرمجة بوصفها بناءً للنظرية» (Programming as Theory Building) أن البرمجة لا تقتصر على كتابة الشيفرة، بل هي مسعى لبناء فهم (نظرية) لكيفية عمل البرمجيات. فإلى أي مدى يبقى هذا الفهم لدى الإنسان في سير عمل يكتب فيه الوكيل الشيفرة ولا يفعل الإنسان سوى الموافقة عليها؟ ويرتبط السؤال أيضا بما وصفه أندريه كارباتي في فبراير 2025 بأنه «البرمجة بالمزاج» (vibe coding)، أي أسلوب قبول المخرجات من دون قراءتها كثيرا: قد يكون هذا الأسلوب مريحا في مشروع عابر لعطلة نهاية الأسبوع، لكن ماذا يحدث عند استخدامه في برمجيات تحتاج إلى صيانة؟
تمرين مبسط يمكنك القيام به ابتداء من اليوم
يمكنك التدرب على الفكرة نفسها من دون تثبيت النسخة الكاملة. اختر قطعة صغيرة من الشيفرة كتبها الذكاء الاصطناعي، وسجّل أولا تقييمك على مقياس من خمس درجات لسؤال: «إذا تعطلت هذه الليلة، هل أستطيع إصلاحها؟». ثم اطلب من الذكاء الاصطناعي، في جلسة منفصلة، تغيير سلوك واحد فقط، من دون النظر إلى الفروق (diff). شغّل المؤقت، وأغلق جلسة الذكاء الاصطناعي، وحاول إصلاح الخلل اعتمادا فقط على وصف الأعراض. اكتب السبب بكلماتك قبل التحقق من الإجابة، ثم قارن في النهاية بين تقييمك الذاتي الأولي والنتيجة.
قد تثق بنفسك ولا تعثر على الخلل، وقد تتمكن من إصلاحه أسرع مما توقعت. لا يمكن معرفة أي من الأمرين بمجرد اجتياز الاختبارات كلها. وإذا أردت تجربة النسخة الكاملة، فهناك خطوات لتشغيل الاختبار الذاتي للمستودع، ثم تنفيذ الأمرين freeze وpilot بالتتابع.
يذكر المؤلف أربعة دروس: قيّم نفسك قبل البدء؛ واعلم أن اجتياز الاختبارات لا يعني بالضرورة أنك قادر على إصلاح الأخطاء؛ وتدرّب قبل أن يتعطل شيء فعلاً؛ واطلب من الذكاء الاصطناعي شرح الكود. وتشير دراسة أجرتها Anthropic أيضاً إلى أن المشاركين الذين طلبوا شروحاً أو طرحوا أسئلة إضافية حققوا نتائج أفضل. لكن المؤلفين يصفون ذلك بأنه ارتباط، لا علاقة سببية.
ما سيتغير في V0.2
يقول المؤلف إنه سيُدخل أربعة تغييرات في الإصدار التالي. أولاً، إضافة خيار يتيح تسجيل «استسلمت» على نحو صحيح. سيعرض إجابات المستخدم إلى جانب نتائج الفحوص الموضوعية، ولن يفرض عليه الاختيار بين «أصلحت المشكلة» و«انتهى الوقت المحدد». ثانياً، سيأخذ استراحة قبل تصحيح الأخطاء كي لا يؤثر الإرهاق الناجم عن الأعمال التحضيرية في النتائج. ثالثاً، سيعود إلى خطته الأصلية باستخدام وكيل يعمل داخل مجلد المشروع ويستطيع تشغيل الاختبارات بنفسه. رابعاً، سيطلب من مطورين آخرين تجربة الخطوات نفسها، لأن نتيجة شخص واحد لا تكفي لمعرفة مدى نجاح الأداة مع الآخرين.
コメント