
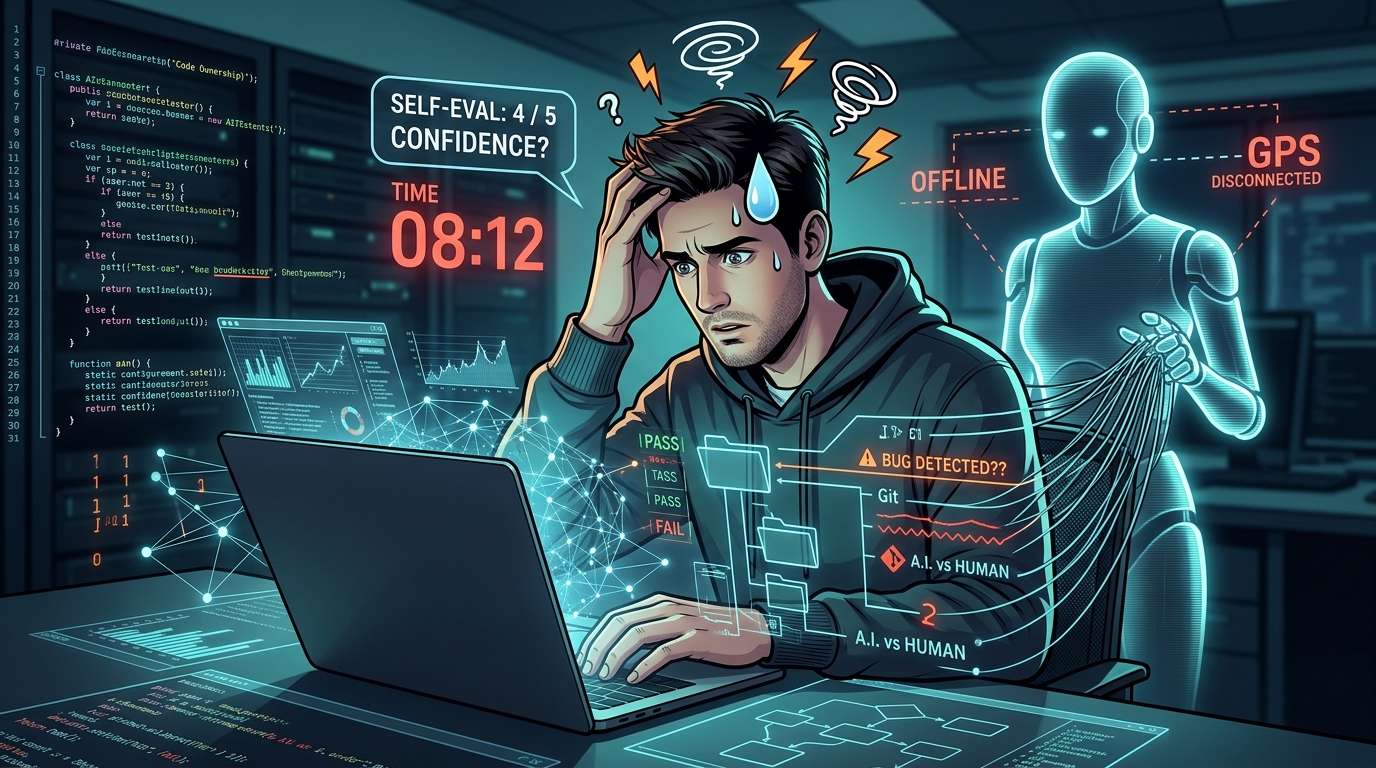
Lässt sich von einer KI implementierter Code warten, ohne die KI um Hilfe zu bitten, die ihn geschrieben hat? Der Entwickler Emmimal Alexander hat Version 0.1 des Prüfwerkzeugs „CodeOwnership“ veröffentlicht, das genau diese Frage untersucht.
Beim ersten Versuch schätzte er sein Verständnis selbst auf 4 von 5 ein. Den von einer anderen KI eingebauten Fehler konnte er jedoch auch nach 8 Minuten und 12 Sekunden nicht finden und brach ab – bei einem Zeitlimit von 60 Minuten.
Ein Name im Commit macht den Code nicht zum eigenen, wenn man ihn nicht reparieren kann
Alle Tests grün, der Build läuft durch. Wer das hört, klickt meist beruhigt auf die Schaltfläche „Merge“ (Zusammenführung in den Hauptzweig). Doch drei Wochen später geht eine Fehlermeldung ein, und der KI-Assistent ist nicht verfügbar. Vielleicht ist das Nutzungskontingent ausgeschöpft, vielleicht sitzt man in einem Pendlerzug ohne Empfang. Kann man dann den vorhandenen Code eigenständig nachvollziehen und reparieren? Genau das will CodeOwnership messen.
Mit „Ownership“ ist hier nicht Urheberrecht oder Lizenzierung gemeint. Es geht um die Fähigkeit, die Logik des Codes nachzuvollziehen und ihn ohne Hilfe einer KI zu ändern – also um praktische Kompetenz bei der Wartung. Dass Tests bestehen, belegt zwar, dass die Software unter günstigen Bedingungen funktioniert. Es beweist aber nicht, dass man ihren inneren Aufbau versteht. Diese Unterscheidung ist der Ausgangspunkt.
Der Ablauf ähnelt einem Test mit ausgeschaltetem GPS
Der Ablauf ist folgender: Zuerst implementiert ein KI-Agent eine Funktion. Anschließend hält der Entwickler auf einer Skala von 1 bis 5 fest, wie gut er sie seiner Einschätzung nach versteht. Dann baut ein anderer Agent anhand einer vorab festgelegten Spezifikation genau einen Fehler ein. Schließlich schaltet der Entwickler die KI aus und sucht mithilfe eines Fehlerberichts nach der Ursache.
Erfasst werden drei Dinge: die Selbsteinschätzung vor der Arbeit, der Erfolg beim Debuggen ohne KI (Zeitlimit: 60 Minuten) und ein Verständnischeck mit vier Fragen im Anschluss. Die Ergebnisse werden nicht zu einer einzigen Punktzahl zusammengefasst, sondern getrennt ausgewiesen. Eine Gesamtpunktzahl würde den Unterschied zwischen dem Gefühl, etwas verstanden zu haben, und dem tatsächlichen Ergebnis bei der Arbeit am Code verschleiern.
Der Autor vergleicht das mit einem Fahrer, der sich immer auf sein Navi verlässt. Fragt man ihn: „Kennen Sie den Weg nach Hause?“, antwortet er mit „Ja“. Erst wenn das Smartphone ausgeschaltet ist, zeigt sich die tatsächliche Antwort. CodeOwnership ist gewissermaßen das Werkzeug, das dieses Smartphone ausschaltet.
Maßnahmen zur Sicherung der Fairness
Der Autor ist zugleich Entwickler des Werkzeugs und Versuchsperson. Um Verzerrungen zu verringern, sind daher zahlreiche Vorkehrungen eingebaut. Die Regeldatei wird durch einen Hashwert fixiert – eine Art Fingerabdruck, der sich ändert, wenn sich der Inhalt ändert. Wird die Datei verändert, stoppt die Ausführung. Das ähnelt der Idee, bei einer Studie den Plan vorab zu registrieren.
Den Fehler baut nicht der Autor selbst ein, sondern ein anderer Agent. Der Autor weiß, welches Verhalten dadurch kaputtgeht, sieht aber nicht den Diff, also die konkreten Änderungen. Die beim Debuggen verwendete Arbeitskopie enthält weder den Git-Verlauf noch die Spezifikation, nicht öffentliche Tests oder Bewertungskriterien. Die Selbsteinschätzung muss vor dem Einbau des Fehlers ins Git-Repository committet werden, der Erklärungstext, bevor die Punktzahl angezeigt wird. Um zu prüfen, ob diese Einschränkungen korrekt greifen, gibt es 72 Selbsttests.
Selbsteinschätzung: 4, Fehler nicht gefunden
Als Beispiel dient eine Notizbibliothek mit Ordnerfunktion. Sie ermöglicht das Erstellen und Abrufen von Notizen, das Anlegen und Löschen von Ordnern, das Verschieben von Notizen und das Anzeigen der Inhalte eines Ordners. Eine Notiz kann außerdem in mehreren Ordnern liegen. Entscheidend ist die Regel, dass beim Löschen eines Ordners die Notizen erhalten bleiben und nur ihre Zuordnung zu diesem Ordner entfernt wird.
Die Implementierung übernahm ChatGPT (kostenloses Konto, Modell Auto, temporärer Chat). Alle 11 öffentlichen Tests und alle 13 nicht öffentlichen Abnahmetests bestanden; auch die Kriterienprüfung war erfolgreich. Nachdem der Autor den Code gelesen hatte, bewertete er sein Verständnis auf einer Skala von 1 bis 5 mit 4 und hielt diese Einschätzung vor dem Einbau des Fehlers in Git fest. Anschließend nahm eine separate Claude-Sitzung ausschließlich anhand der Spezifikation Änderungen vor; auch die Verhaltensprüfung war erfolgreich.
Nach 8 Minuten und 12 Sekunden Debugging brach der Autor die Arbeit ab, ohne die Ursache gefunden zu haben. Er sei wegen Problemen bei den Vorbereitungen am Vortag müde und gereizt gewesen. Das Werkzeug bietet nur zwei Optionen: „repariert“ oder „Zeitlimit überschritten“. Um fortfahren zu können, wählte der Autor „repariert“. Am Code hatte er jedoch nichts geändert; die objektive Prüfung ergab daher „nicht repariert“. Alle 11 öffentlichen Tests bestanden, bei den nicht öffentlichen Tests waren 10 von 13 erfolgreich und 3 schlugen fehl. Da auch die vier Verständnisfragen unbeantwortet blieben, wurde der Bericht als „unvollständig“ vermerkt.
Eingebaut wurden gerade einmal zwei Zeilen
Die später offengelegte Änderung bestand aus zwei Zeilen, die der Löschroutine für Ordner hinzugefügt wurden: Wenn eine Notiz keinem Ordner mehr zugeordnet ist, wird sie aus dem Speicher gelöscht. Das ist alles. Bei Notizen in mehreren Ordnern bleibt mindestens eine Zuordnung bestehen, sie sind also sicher. Notizen, die nur in einem Ordner liegen, verschwinden hingegen zusammen mit diesem Ordner.
Auf den ersten Blick wirkt die Bedingung plausibel: Die Liste ist leer, also wird gelöscht. Doch dass eine Notiz keiner Kategorie zugeordnet ist, heißt nicht, dass sie überflüssig ist. Rückblickend sagt der Autor, ein Hinweis wäre vielleicht darin gelegen, sich zu fragen: „Wer ist in dieser App dafür zuständig, Notizen zu löschen?“ Entscheidend war also, ob man nicht nur dem Wortlaut des Codes folgt, sondern sich auch die Zuständigkeiten vorstellen kann.
Was ein einzelner Versuch aussagen kann
Die Ergebnisse sind mit Vorsicht zu interpretieren. Getestet wurde nur ein Entwickler, an einem einzigen Beispiel und in einem einzigen Debugging-Durchlauf, der vorzeitig abgebrochen wurde. Der Autor selbst betont, dass sich aus diesem Experiment nicht ableiten lässt, ob KI-Nutzer ein geringeres Verständnis von Code entwickeln. Das Zeitlimit lag bei 60 Minuten; ob der Fehler bei einem längeren Versuch gefunden worden wäre, ist ebenfalls unklar.
Es gibt zwar einen Bericht, wonach der Autor später nach etwa 30 Minuten die Ursache gefunden habe. Das beruht jedoch auf seiner eigenen Aussage; die Zeit wurde nicht gemessen und die Korrektur nicht überprüft, weshalb dies nicht als Leistung gewertet wurde. Der Autor nennt außerdem mehrere Einschränkungen: Als Entwickler des Tools wusste er, „was kaputtgehen würde“; der Einfluss von Müdigkeit und Problemen bei der Vorbereitung lässt sich nicht herausrechnen; der ursprüngliche Plan, einen Agenten einzusetzen, der im Arbeitsordner arbeitet, wurde nicht eingehalten; und die verwendete Werkzeugkombination änderte sich im Verlauf. Die nicht öffentlichen Tests und Bewertungskriterien wurden zur besseren Reproduzierbarkeit im Repository veröffentlicht. Wer den Versuch nachstellt, kann deshalb die Blindbedingungen nicht mehr einhalten.
Trotzdem ist dieser eine Versuch aufschlussreich. Der Zustand „Selbsteinschätzung: 4, alle Tests grün“ muss nicht dasselbe bedeuten wie „Ich kann den Fehler tatsächlich selbst beheben“. Am ehrlichsten lässt sich der Versuch als konkretes Beispiel dafür lesen.
Hinweise aus der Forschung im Umfeld
Der Autor verweist zum Hintergrund dieser Frage auf mehrere Studien. Keine davon belegt jedoch das hier vorgestellte Tool; sie werden vielmehr als Kontext für die Fragestellung angeführt.
In einer im Juli 2025 veröffentlichten Untersuchung von METR bearbeiteten 16 erfahrene Open-Source-Entwickler mithilfe von KI-Tools 246 tatsächliche Aufgaben in ihren eigenen Repositories. Das Ergebnis: Sie benötigten 19 Prozent länger bis zum Abschluss. Vor Beginn hatten die Entwickler mit einer Beschleunigung um 24 Prozent gerechnet; im Nachhinein hatten sie weiterhin den Eindruck, 20 Prozent schneller gewesen zu sein. Gemessen wurde die Arbeitszeit, nicht das Verständnis des Codes. METR selbst bezeichnete diese Ergebnisse als überholt und kündigte im Februar 2026 eine Überarbeitung des Versuchsdesigns an.
Eine im Januar 2026 veröffentlichte Studie von Anthropic untersuchte 52 Ingenieure, die die Python-Bibliothek „Trio“ lernten; die meisten waren noch wenig erfahrene Entwickler. Die Gruppe mit KI-Unterstützung erreichte in einem späteren Quiz durchschnittlich 50 Prozent, die Gruppe, die den Code selbst schrieb, 67 Prozent. Der Unterschied gilt als statistisch signifikant. Die KI-Gruppe war etwa zwei Minuten früher fertig, doch dieser Zeitunterschied war nicht signifikant. Wer die KI um Erklärungen bat oder zusätzliche Fragen stellte, erzielte tendenziell bessere Lernergebnisse. Weniger die Nutzung von KI an sich als vielmehr die Art ihrer Nutzung könnte also den Unterschied machen. Erwähnenswert ist auch, dass der Autor angibt, Claude üblicherweise zu verwenden und auch diesen Artikel damit erstellt zu haben.
Wenn Automatisierung die Übung verdrängt
Auch ein Klassiker wird herangezogen: 1983 argumentierte Lisanne Bainbridge in ihrem Aufsatz „Ironies of Automation“, dass mit zunehmender Automatisierung die Übungsmöglichkeiten für Menschen abnehmen und sich dieser Mangel bemerkbar macht, wenn sie in Ausnahmesituationen übernehmen müssen. Das Verhältnis zwischen Autopilot und den Fähigkeiten von Piloten ist ein typisches Beispiel.
1985 schrieb Peter Naur in „Programming as Theory Building“, dass Programmieren nicht nur darin besteht, Code zu schreiben, sondern auch darin, ein Verständnis – eine Theorie – darüber aufzubauen, wie eine Software funktioniert. Wie viel von diesem Verständnis bleibt beim Menschen, wenn ein Agent den Code schreibt und der Mensch ihn nur noch absegnet? Damit verbunden ist auch die Frage, was aus dem von Andrej Karpathy im Februar 2025 beschriebenen „Vibe-Coding“ wird: einem Stil, bei dem man Ausgaben akzeptiert, ohne sie genau zu lesen. Für ein Wegwerfprojekt am Wochenende mag das unbeschwert sein – aber was ist mit Software, die gewartet werden muss?
Eine einfache Übung für heute
Für eine Übung nach demselben Prinzip muss man nicht die vollständige Version installieren. Wähle ein kleines Stück KI-generierten Code aus und notiere zunächst auf einer Skala von 1 bis 5, ob du es reparieren könntest, wenn es heute Abend kaputtginge. Bitte dann eine KI in einer separaten Sitzung, genau ein Verhalten zu ändern, und sieh dir den Diff nicht an. Starte einen Timer, schließe die KI-Sitzung und versuche, den Fehler ausschließlich anhand der Symptombeschreibung zu beheben. Schreibe die vermutete Ursache vor dem Abgleich in eigenen Worten auf und vergleiche zum Schluss deine erste Selbsteinschätzung mit dem Ergebnis.
Vielleicht warst du zuversichtlich und findest den Fehler trotzdem nicht; vielleicht lässt er sich schneller beheben als gedacht. Beides hätte sich allein daran, dass alle Tests bestehen, nicht erkennen lassen. Wer die vollständige Version ausprobieren möchte, kann den Selbsttest im Repository ausführen und anschließend nacheinander die Befehle freeze und pilot ausführen.
Der Autor nennt vier Lehren: Vor dem Start die eigenen Fähigkeiten einschätzen. Wissen, dass bestandene Tests nicht bedeuten, dass man den Code auch reparieren kann. Üben, bevor tatsächlich etwas kaputtgeht. Und die KI bitten, den Code zu erklären. Auch in einer Studie von Anthropic schnitten Teilnehmende besser ab, wenn sie um Erklärungen oder zusätzliche Informationen baten. Die Autoren betonen jedoch, dass es sich dabei um einen Zusammenhang und nicht um einen Kausalzusammenhang handelt.
Was sich in Version 0.2 ändern soll
Für die nächste Version kündigt der Autor vier Änderungen an. Erstens soll es eine Möglichkeit geben, „aufgegeben“ korrekt zu erfassen. Die Antworten der Nutzer und die Ergebnisse der objektiven Überprüfung sollen nebeneinander angezeigt werden, sodass niemand zwischen „repariert“ und „Zeitlimit abgelaufen“ wählen muss. Zweitens soll vor dem Debuggen eine Pause eingelegt werden, damit die Erschöpfung durch die Vorbereitungsarbeit das Ergebnis nicht beeinflusst. Drittens will der Autor zum ursprünglichen Plan zurückkehren und einen Agenten verwenden, der im Projektordner arbeitet und die Tests selbst ausführen kann. Viertens sollen auch andere Entwickler denselben Ablauf ausprobieren. Das Ergebnis einer einzelnen Person lässt schließlich keine Rückschlüsse darauf zu, wie gut das Tool bei anderen funktioniert.
コメント