
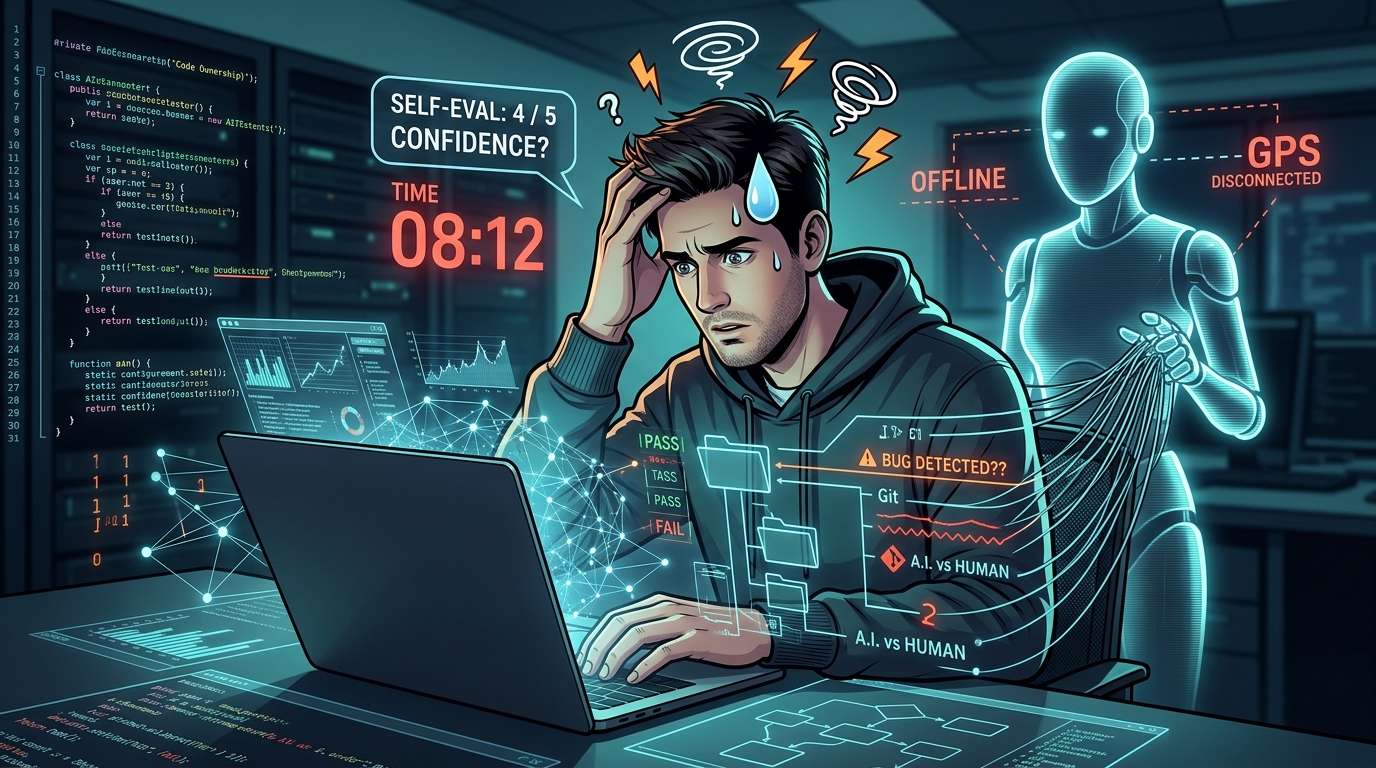
Si è in grado di mantenere il codice implementato dall’IA senza ricorrere all’IA che lo ha scritto? Lo sviluppatore Emmimal Alexander ha pubblicato la versione V0.1 di «CodeOwnership», uno strumento di verifica pensato per misurare proprio questo.
Al primo tentativo, pur avendo valutato la propria comprensione con un 4 su una scala di 5, l’autore ha interrotto la prova dopo 8 minuti e 12 secondi senza riuscire a trovare il bug inserito da un’altra IA, su un limite di 60 minuti.
Se non riesci a correggerlo, non è «codice tuo», anche se il tuo nome compare nel commit
Tutti i test sono verdi e la build è andata a buon fine. Sentendo questo, molte persone premono tranquillamente il pulsante di merge (integrazione nel ramo principale). Tre settimane dopo, però, arriva una segnalazione di malfunzionamento e l’assistente IA non è disponibile: hai esaurito la quota oppure sei su un treno pendolari senza copertura. In quel momento, sei in grado di capire e correggere da solo il codice che hai davanti? È proprio questo che CodeOwnership cerca di misurare.
Qui «proprietà» non ha a che fare con il copyright o le licenze. Si riferisce alla capacità, nella pratica della manutenzione, di seguire la logica del codice e modificarlo senza l’aiuto dell’IA. Il superamento dei test può dimostrare che il software funziona in condizioni favorevoli, ma non che se ne comprenda il funzionamento interno. È da questa distinzione che prende le mosse il progetto.
Il meccanismo ricorda una prova in cui si spegne il GPS
Il processo è il seguente. Per prima cosa, un agente IA implementa una funzionalità. Poi lo sviluppatore registra, su una scala da 1 a 5, quanto ritiene di averla compresa. A quel punto, un altro agente inserisce un solo bug, seguendo specifiche registrate in anticipo. Infine, con l’IA disattivata, lo sviluppatore cerca la causa del problema basandosi sulla segnalazione del malfunzionamento.
Vengono registrati tre elementi: l’autovalutazione prima del lavoro, l’esito del debug senza IA (con un limite di 60 minuti) e una verifica della comprensione composta da quattro domande, a cui rispondere al termine. I risultati vengono riportati separatamente, senza essere riassunti in un unico punteggio. Un singolo punteggio nasconderebbe infatti la discrepanza tra «credere di aver capito» e ciò che accade quando si mette mano al codice.
L’autore paragona il sistema a un automobilista che si affida sempre al navigatore. Alla domanda «Sai come arrivare a casa?» risponderà «Sì». Solo spegnendo lo smartphone si ottiene la risposta vera. Si può dire che CodeOwnership sia lo strumento che spegne quel telefono.
Accorgimenti per garantire l’imparzialità
L’autore è sia il progettista dello strumento sia il soggetto del test. Per ridurre i possibili bias, sono state introdotte diverse misure. Il file delle regole è vincolato tramite un hash (una sorta di impronta digitale che cambia se cambia il contenuto) e, se viene modificato, l’esecuzione si interrompe. L’approccio ricorda la preregistrazione del piano di uno studio di ricerca.
A inserire il bug non è l’autore, ma un agente distinto. L’autore sa quale comportamento si rompe, ma non esamina le differenze che mostrano dove sono state apportate le modifiche. La copia di lavoro usata durante il debug non contiene la cronologia Git, le specifiche, i test non pubblici né i criteri di valutazione. L’autovalutazione deve essere registrata prima che venga inserito il bug, mentre la spiegazione deve essere inviata prima che venga mostrato il punteggio. Sono stati predisposti 72 autotest per verificare che questi vincoli funzionino correttamente.
Sicurezza valutata 4, ma il bug resta introvabile
Il progetto scelto è una libreria di note con funzionalità per le cartelle. Consente di creare e recuperare note, creare ed eliminare cartelle, spostare note e visualizzare l’elenco dei contenuti di una cartella; una stessa nota può anche essere inserita in più cartelle. La regola fondamentale è che, eliminando una cartella, le note restano: viene rimossa soltanto l’associazione con la cartella.
L’implementazione è stata affidata a ChatGPT (account gratuito, modello Auto, chat temporanea). Tutti gli 11 test pubblici e i 13 test di accettazione non pubblici sono stati superati, così come la verifica dei criteri. Dopo aver letto il codice, l’autore ha valutato la propria comprensione con un 4 su 5 e lo ha registrato su Git prima che venisse inserito il bug. In seguito, una sessione separata di Claude ha apportato modifiche basandosi soltanto sulle specifiche, e anche la verifica del comportamento è stata superata.
Dopo 8 minuti e 12 secondi dall’inizio del debug, l’autore ha interrotto il lavoro senza riuscire a trovare la causa. Ha spiegato di essere stanco e irritato per i problemi incontrati nei preparativi del giorno precedente. Lo strumento offriva solo due opzioni: «corretto» oppure «tempo scaduto»; per poter proseguire, l’autore ha selezionato «corretto». Non ha però modificato il codice e il controllo oggettivo ha dato esito «non corretto». Tutti gli 11 test pubblici sono stati superati; dei 13 test non pubblici, 10 sono passati e 3 non sono stati superati. Anche le quattro domande di verifica della comprensione sono rimaste senza risposta, perciò il rapporto è stato contrassegnato come «incompleto».
Il bug era stato inserito con appena due righe
La modifica rivelata in seguito consisteva in due righe aggiunte alla procedura di eliminazione delle cartelle. Se una nota non apparteneva più ad alcuna cartella, veniva eliminata dal sistema di archiviazione. Tutto qui. Le note presenti in più cartelle restano intatte, perché conservano almeno un’associazione; quelle inserite in una sola cartella, invece, spariscono insieme a essa.
A prima vista, il ragionamento sembra coerente: la lista è vuota, quindi si elimina. Ma il fatto che una nota non sia associata a nulla non significa che sia inutile. L’autore riflette che avrebbe potuto trovare un indizio chiedendosi: «A chi spetta, in questa app, la responsabilità di eliminare le note?». La prova, quindi, consisteva non solo nel seguire il testo del codice, ma anche nel riuscire a immaginare la ripartizione dei ruoli.
Cosa può dirci un singolo tentativo
È bene essere cauti nell’interpretare i risultati. A partecipare alla prova è stato un solo sviluppatore, su un solo progetto, con un unico tentativo di debugging interrotto a metà. Lo stesso autore afferma che da questo esperimento non si può stabilire se chi usa l’IA finisca per comprendere meno il codice. Il limite di tempo era di 60 minuti, ma la prova non permette di sapere se avrebbe trovato il bug continuando.
L’autore riferisce di essere riuscito a individuare la causa in seguito, dopo circa 30 minuti. Si tratta però di una sua dichiarazione: non ha cronometrato il tempo né verificato la correzione, quindi il risultato non è stato conteggiato. L’autore segnala anche che, essendo il progettista dello strumento, sapeva «che cosa si sarebbe rotto»; che non è possibile isolare gli effetti della stanchezza o dei problemi di preparazione; che la prova si è discostata dal piano iniziale, che prevedeva l’uso di un agente operante nella cartella di lavoro; e che la combinazione di strumenti è cambiata nel corso del tentativo. I test privati e i criteri di valutazione sono pubblicati nel repository per consentire la riproducibilità, ma questo comporta anche che chi li prova non possa mantenere condizioni alla cieca.
Ciò nonostante, questo singolo tentativo è utile per illustrare un punto: «Sono sicuro, voto 4; i test sono tutti verdi» e «riesco davvero a correggere il bug da solo» non sono necessariamente la stessa cosa. È questo il modo più corretto di interpretarlo.
Gli indizi offerti dalla ricerca sul tema
Per inquadrare la questione, l’autore cita diversi studi. Nessuno, tuttavia, convalida lo strumento presentato: sono menzionati per contestualizzare il problema.
In uno studio pubblicato nel luglio 2025, METR ha coinvolto 16 sviluppatori esperti di software open source, che hanno usato strumenti di IA per affrontare 246 problemi reali nei propri repository. Il risultato: il tempo necessario per completare le attività è aumentato del 19%. Prima della prova gli sviluppatori prevedevano di essere più veloci del 24% e, al termine, ritenevano di esserlo stati del 20%. Lo studio misura il tempo di lavoro, non la comprensione del codice. METR, inoltre, considera ormai superati questi risultati e nel febbraio 2026 ha annunciato una revisione del disegno sperimentale.
Uno studio pubblicato da Anthropic nel gennaio 2026 ha coinvolto 52 ingegneri che stavano imparando la libreria Python «Trio», molti dei quali sviluppatori con poca esperienza. Nel quiz successivo, il gruppo che aveva ricevuto assistenza dall’IA ha ottenuto una media del 50%, contro il 67% del gruppo che aveva scritto il codice a mano: la differenza è stata giudicata statisticamente significativa. Il gruppo assistito dall’IA ha terminato circa due minuti prima, ma la differenza nei tempi non è risultata significativa. D’altra parte, chiedere spiegazioni o porre domande aggiuntive era associato a risultati di apprendimento migliori. A fare la differenza potrebbe essere il modo in cui si usa l’IA, più che il suo impiego in sé. Va anche ricordato che l’autore dichiara di usare abitualmente Claude e di averlo impiegato per realizzare questo articolo.
L’automazione sottrae una risorsa: la «pratica»
Viene citato anche un classico. Nel 1983, Lisanne Bainbridge sosteneva nel saggio «Ironies of Automation» che, con l’avanzare dell’automazione, diminuiscono le occasioni di esercitarsi per gli esseri umani, e che questa mancanza pesa quando devono subentrare in caso di anomalia. Il rapporto tra il pilota automatico di un aereo e le capacità del pilota ne è un esempio tipico.
Nel 1985, Peter Naur scriveva in «Programming as Theory Building» che programmare non significa limitarsi a scrivere codice, ma costruire una comprensione — una teoria — del funzionamento del software. In un flusso di lavoro in cui l’agente scrive e l’essere umano si limita ad approvare, quanta di quella comprensione resta davvero a disposizione di chi programma? La domanda si collega anche alla «vibe coding», espressione usata da Andrej Karpathy nel febbraio 2025 per descrivere uno stile in cui si accetta il risultato senza leggerlo granché: può essere comodo per un progetto usa e getta del fine settimana, ma che cosa succede quando si tratta di software da mantenere?
Un semplice esercizio da provare già oggi
Si può fare un esercizio con la stessa impostazione anche senza installare la versione completa. Scegliete un piccolo frammento di codice scritto dall’IA e valutate prima, su una scala da 1 a 5: «Se si rompesse stasera, riuscirei a correggerlo?». Poi chiedete a un’IA, in una sessione separata, di modificare un solo comportamento, senza guardare le differenze. Avviate un timer, chiudete la sessione con l’IA e provate a riparare il codice basandovi soltanto sulla descrizione del sintomo. Prima di controllare la risposta, annotate con parole vostre la causa; infine confrontate la valutazione iniziale con il risultato.
A volte si può essere sicuri di sé e non riuscire a trovare il bug; altre volte si riesce a correggerlo prima del previsto. Sono entrambe cose che non si sarebbero potute sapere solo perché tutti i test passano. Chi vuole provare la versione completa può seguire le istruzioni disponibili: eseguire l’autotest del repository e poi lanciare, nell’ordine, i comandi freeze e pilot.
Le lezioni che l’autore trae sono quattro: valutare se stessi prima di iniziare; capire che superare i test e riuscire a correggere il codice sono due cose diverse; esercitarsi prima che qualcosa si rompa davvero; e chiedere all’IA di spiegare il codice. Anche uno studio di Anthropic ha rilevato risultati migliori tra i partecipanti che chiedevano spiegazioni o ponevano domande aggiuntive. Gli autori precisano però che si tratta di una correlazione, non di un rapporto causale.
Cosa cambierà nella v0.2
Per la prossima versione, l’autore prevede quattro modifiche. La prima è aggiungere un’opzione che registri correttamente «mi sono arreso». Le risposte degli utenti saranno mostrate accanto ai risultati dei controlli oggettivi, senza costringerli a scegliere tra «ho corretto il bug» e «tempo scaduto». La seconda è prevedere una pausa prima del debug, così che la stanchezza accumulata durante i preparativi non influenzi i risultati. La terza è tornare al piano iniziale e usare un agente che operi all’interno della cartella del progetto e possa eseguire i test autonomamente. La quarta è chiedere ad altri sviluppatori di seguire la stessa procedura. I risultati di una sola persona, infatti, non bastano a stabilire quanto lo strumento possa essere efficace anche per gli altri.
コメント