
¿Es posible mantener código implementado por una IA sin recurrir a la IA que lo escribió? El desarrollador Emmimal Alexander ha publicado la versión 0.1 de «CodeOwnership», una herramienta de evaluación concebida para medirlo.
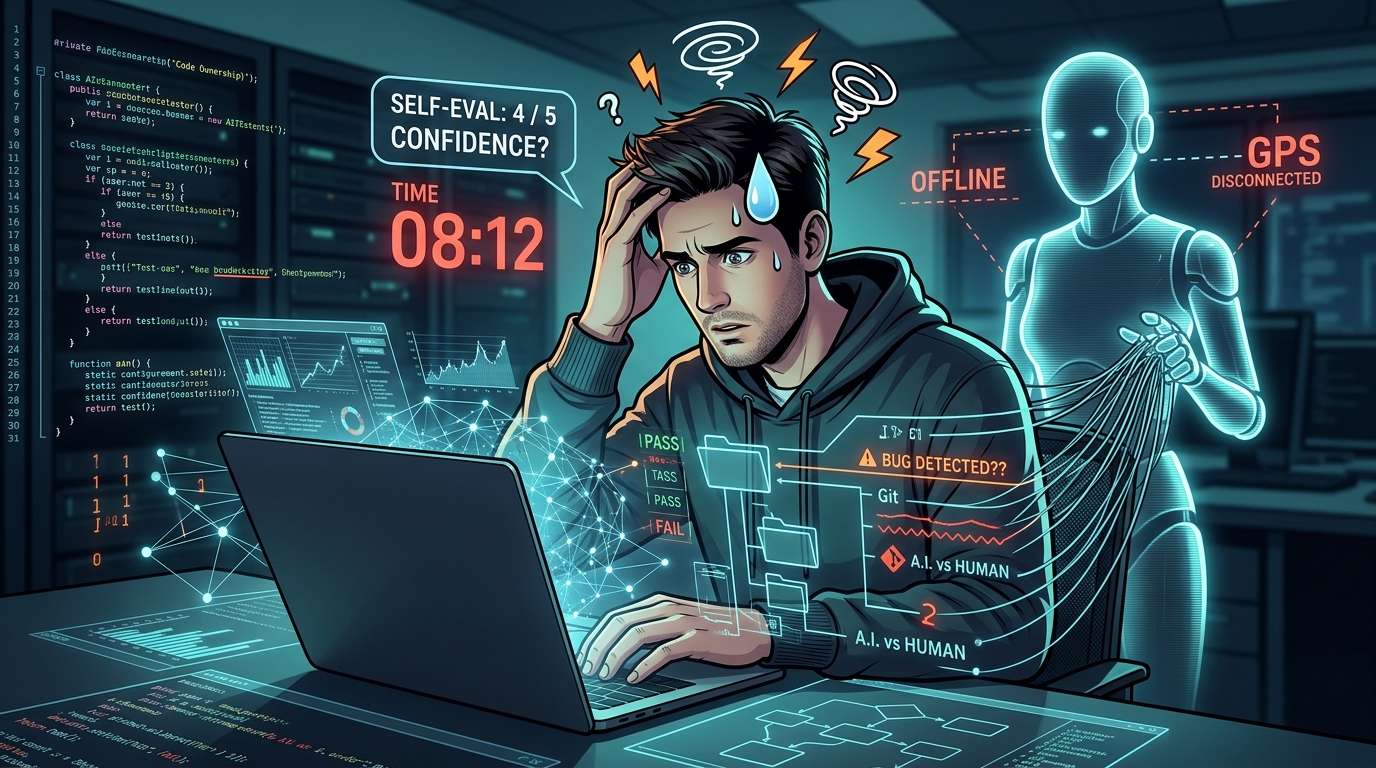
En el primer intento, el autor se puso un 4 sobre 5 en comprensión, pero abandonó sin encontrar el error introducido por otra IA. Solo habían transcurrido 8 minutos y 12 segundos de los 60 minutos disponibles.
Aunque su nombre figure en el commit, si no puede corregirlo, no es «su código»
Todas las pruebas estaban en verde y la compilación se completó sin problemas. Ante esa noticia, muchos pulsan tranquilos el botón de merge (integración en la rama principal). Pero tres semanas después llega un aviso de error y el asistente de IA no está disponible: se ha agotado la cuota o se viaja en un tren sin cobertura, por ejemplo. ¿Se puede entender y corregir entonces el código a mano? Eso es precisamente lo que CodeOwnership intenta medir.
Aquí, «propiedad» no se refiere a los derechos de autor ni a las licencias. Se refiere a la capacidad práctica de seguir la lógica del código y modificarlo sin ayuda de la IA, algo necesario en las tareas de mantenimiento. Que las pruebas se superen demuestra que el software funciona en condiciones favorables, pero no que se comprenda lo que hay dentro. Esta distinción es el punto de partida.
Un test parecido a apagar el GPS
El proceso es el siguiente: primero, un agente de IA implementa una funcionalidad. Después, el desarrollador registra en una escala del 1 al 5 cuánto cree comprenderla. A continuación, otro agente introduce un único error de acuerdo con una especificación registrada de antemano. Por último, el desarrollador, con la IA desactivada, busca la causa a partir de un informe del problema.
Se registran tres aspectos: la autoevaluación previa, el resultado de la depuración sin IA —con un límite de 60 minutos— y una prueba de comprensión de cuatro preguntas que se responde al terminar. Se informan por separado, sin reducirlos a una única puntuación. Si se combinan en una sola nota, desaparece la diferencia entre «creer que se entiende» y lo que ocurre al enfrentarse al código.
El autor lo compara con un conductor que siempre depende del navegador. Si le preguntan «¿sabes cómo llegar a casa?», responderá que sí. Solo al apagar el móvil se obtiene la respuesta real. Puede decirse que CodeOwnership es la herramienta que apaga ese móvil.
Medidas para garantizar la imparcialidad
El autor es tanto el diseñador de la herramienta como el sujeto de la prueba. Por eso, incorpora numerosas medidas para reducir los sesgos. Los archivos de reglas quedan fijados mediante un valor hash —una especie de huella digital que cambia si cambia el contenido— y, si se modifican, la ejecución se detiene. La idea es similar al registro previo de un plan de investigación.
El error no lo introduce el propio autor, sino otro agente. El autor conoce el comportamiento que se romperá, pero no ve el diff que muestra qué se ha cambiado. La copia de trabajo usada durante la depuración no incluye el historial de Git, la especificación, las pruebas privadas ni los criterios de evaluación. La autoevaluación debe registrarse antes de introducir el error, y la explicación debe quedar comprometida antes de que se muestre la puntuación. Hay 72 pruebas internas para comprobar que estas restricciones funcionan correctamente.
Confianza de 4 sobre 5; no encuentra el error
El ejercicio consiste en una biblioteca de notas con funciones de carpetas. Permite crear y recuperar notas, crear y eliminar carpetas, mover notas y ver el contenido de una carpeta. También se puede incluir la misma nota en varias carpetas. La regla clave es que, al eliminar una carpeta, las notas permanecen: solo desaparece su vínculo con esa carpeta.
La implementación corrió a cargo de ChatGPT —cuenta gratuita, modelo Auto y chat temporal—. Las 11 pruebas públicas y las 13 pruebas de aceptación privadas se superaron, y la comprobación de los criterios también fue satisfactoria. Tras leer el código, el autor se asignó un 4 sobre 5 en comprensión y lo registró en Git antes de que se introdujera el error. Después, otra sesión de Claude hizo cambios basándose únicamente en la especificación y también superó la verificación del comportamiento.
A los 8 minutos y 12 segundos de empezar a depurar, el autor interrumpió el trabajo sin encontrar la causa. Según explicó, estaba cansado e irritado por problemas durante los preparativos del día anterior. La herramienta solo ofrecía dos opciones: «corregido» o «se ha agotado el tiempo». Para poder continuar, el autor eligió «corregido». Sin embargo, no había modificado el código y la comprobación objetiva indicó «sin corregir». Las 11 pruebas públicas se superaron; de las 13 privadas, 10 pasaron y 3 fallaron. Como tampoco se respondieron las cuatro preguntas de comprensión, el informe quedó registrado como «incompleto».
El error introducido constaba de solo dos líneas
El cambio que se reveló posteriormente consistía en dos líneas añadidas al proceso de eliminación de carpetas: si una nota se quedaba sin carpetas asociadas, se borraba del almacenamiento. Y nada más. Las notas incluidas en varias carpetas conservaban al menos un vínculo y no se veían afectadas, pero las que solo estaban en una carpeta desaparecían junto con ella.
A primera vista, la lógica parece sólida: si la lista está vacía, se elimina. Pero que algo no esté asociado a nada no significa que la nota sea innecesaria. El autor recuerda que quizá habría encontrado una pista si se hubiera preguntado: «¿A quién le corresponde borrar las notas en esta aplicación?». No bastaba con seguir el texto del código; también se trataba de comprobar si era capaz de imaginar cómo se repartían las responsabilidades.
Lo que puede revelar un único intento
Conviene interpretar los resultados con cautela. La prueba la realizó un solo desarrollador, sobre un único caso, y la única sesión de depuración se interrumpió antes de terminar. El propio autor señala que este experimento no permite concluir si el uso de IA hace que sus usuarios entiendan peor el código. Había un límite de 60 minutos y tampoco se sabe si habría encontrado el error de haber seguido intentándolo.
El autor cuenta que más adelante encontró la causa tras dedicarle unos 30 minutos. Sin embargo, se trata de una declaración del propio autor: no cronometró el tiempo ni comprobó la reparación, por lo que no se ha contabilizado como resultado. También señala que, como diseñador de la herramienta, sabía «qué podía romperse»; que no puede aislar el efecto del cansancio ni de los problemas durante la preparación; que se apartó del plan inicial de usar un agente que operase dentro de la carpeta de trabajo, y que la combinación de herramientas cambió durante la prueba. Además, las pruebas privadas y los criterios de puntuación se han publicado en el repositorio para que el experimento pueda reproducirse, así que quienes lo intenten después de leerlo no podrán mantener las condiciones a ciegas.
Aun así, este único intento resulta útil. La situación de «confianza: 4, todas las pruebas en verde» no tiene por qué equivaler a «ser capaz de arreglarlo realmente por cuenta propia». Lo más honesto es leerlo como un ejemplo concreto de esa diferencia.
Pistas que aportan estudios relacionados
El autor cita varios estudios para situar esta cuestión. No obstante, ninguno valida la herramienta utilizada en esta ocasión: los menciona para contextualizar la preocupación.
En un estudio publicado por METR en julio de 2025, 16 desarrolladores experimentados de código abierto utilizaron herramientas de IA para abordar 246 problemas reales de sus propios repositorios. Tardaron un 19 % más en completar las tareas. Antes de empezar, los desarrolladores esperaban ser un 24 % más rápidos y, al terminar, seguían creyendo que habían sido un 20 % más rápidos. El estudio mide el tiempo de trabajo, no la comprensión del código. METR considera obsoletos estos resultados y anunció en febrero de 2026 que revisaría el diseño experimental.
En un estudio publicado por Anthropic en enero de 2026 participaron 52 ingenieros que aprendían a usar la biblioteca de Python «Trio»; muchos eran desarrolladores con poca experiencia. En el cuestionario posterior, el grupo que recibió ayuda de la IA obtuvo una media del 50 %, frente al 67 % del grupo que escribió el código a mano; la diferencia se consideró estadísticamente significativa. El grupo con IA terminó unos dos minutos antes, pero esa diferencia no fue significativa. Por otro lado, pedir explicaciones o formular preguntas adicionales se asoció con mejores resultados de aprendizaje. El factor decisivo podría ser cómo se usa la IA, más que el mero hecho de utilizarla. También conviene señalar que el autor afirma que usa Claude habitualmente y que lo utilizó para elaborar este artículo.
La práctica, un recurso que la automatización puede arrebatarnos
También se citan trabajos clásicos. En 1983, Lisanne Bainbridge sostuvo en el artículo «Ironies of Automation» que, cuanto más avanza la automatización, menos oportunidades de práctica tiene la gente, y que esa falta de experiencia pesa cuando se debe tomar el control ante una anomalía. La relación entre el piloto automático de un avión y la destreza de sus pilotos es un ejemplo clásico.
En 1985, Peter Naur afirmó en «Programming as Theory Building» que programar no se limita a escribir código: también implica construir una comprensión —una teoría— del funcionamiento del software. En un flujo de trabajo en el que los agentes escriben y las personas solo dan su aprobación, ¿cuánto de esa comprensión se conserva? La cuestión también conecta con el «vibe coding» del que habló Andrej Karpathy en febrero de 2025: un estilo que consiste en aceptar los resultados sin apenas leerlos. Puede resultar cómodo en proyectos de fin de semana pensados para usar y tirar, pero ¿qué ocurre con el software que hay que mantener?
Un ejercicio sencillo que puedes hacer hoy
No hace falta instalar la versión completa para practicar la misma idea. Elige un pequeño fragmento de código escrito por una IA y anota primero, en una escala del 1 al 5, si crees que podrías arreglarlo si se estropeara esta noche. Después, pide a una IA en otra sesión que cambie un solo aspecto del comportamiento y no mires el diff. Pon en marcha un temporizador, cierra la sesión de IA e intenta reparar el código guiándote únicamente por la descripción de los síntomas. Antes de comprobar la solución, escribe con tus propias palabras cuál crees que es la causa; al final, compara tu autoevaluación inicial con el resultado.
Puede que no des con el error pese a tener confianza, o que lo arregles antes de lo esperado. Ninguna de esas cosas podía saberse solo porque todas las pruebas pasaran. Si quieres probar la versión completa, hay instrucciones para ejecutar la autoevaluación del repositorio y, después, los comandos freeze y pilot.
Las lecciones que señala el autor son cuatro: evaluarse antes de empezar; entender que superar las pruebas y ser capaz de arreglar el código son cosas distintas; practicar antes de que algo se rompa de verdad; y pedirle a la IA que explique el código. En un estudio de Anthropic, los participantes que pidieron explicaciones o hicieron preguntas adicionales también obtuvieron mejores resultados. No obstante, los autores señalan que se trata de una correlación, no de una relación causal.
Cambios en la V0.2
El autor dice que en la próxima versión cambiará cuatro aspectos. Primero, añadirá una opción que permita registrar correctamente que alguien se ha rendido. Mostrará juntas la respuesta del usuario y el resultado de la comprobación objetiva, y evitará obligarlo a elegir solo entre «Lo he arreglado» y «Se ha agotado el tiempo». Segundo, dejará un descanso antes de depurar, para que el cansancio de las tareas preparatorias no afecte al resultado. Tercero, volverá al plan inicial de utilizar un agente que opere dentro de la carpeta del proyecto y pueda ejecutar las pruebas por sí mismo. Cuarto, pedirá a otros desarrolladores que prueben el mismo procedimiento. Los resultados de una sola persona no permiten saber hasta qué punto la herramienta funcionará para los demás.
コメント