
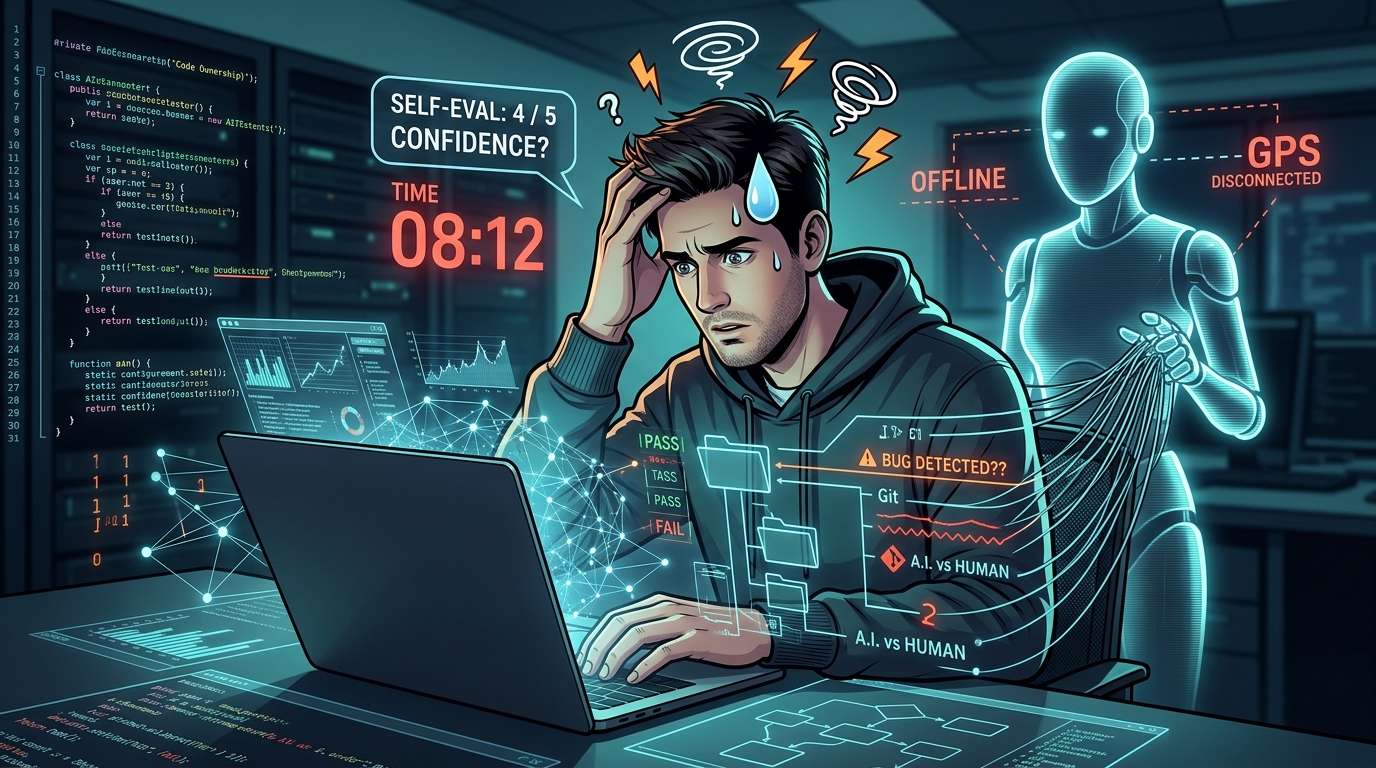
क्या AI द्वारा लागू किए गए कोड का रखरखाव उसे लिखने वाले AI की मदद के बिना किया जा सकता है? डेवलपर Emmimal Alexander ने इस सवाल को परखने वाले टूल «CodeOwnership» का V0.1 जारी किया है।
पहले प्रयास में उन्होंने अपनी समझ को 5 में से 4 अंक दिए, लेकिन दूसरी AI द्वारा डाले गए बग को 60 मिनट की समय-सीमा में 8 मिनट 12 सेकंड तक खोजने की कोशिश के बाद भी नहीं ढूंढ़ पाए और प्रयास रोक दिया।
कमिट में नाम दर्ज हो, तब भी अगर आप कोड ठीक नहीं कर सकते, तो वह «आपका कोड» नहीं है
सारे टेस्ट पास हुए, बिल्ड भी सफल रहा। यह सुनकर ज़्यादातर लोग निश्चिंत होकर मर्ज (मुख्य कोड में एकीकरण) बटन दबा देते हैं। लेकिन 3 हफ्ते बाद किसी खराबी की रिपोर्ट आती है और AI असिस्टेंट उपलब्ध नहीं होता। हो सकता है कि इस्तेमाल की सीमा (क्वोटा) खत्म हो गई हो, या आप ऐसी कम्यूटर ट्रेन में हों जहां नेटवर्क न हो। तब क्या आप सामने मौजूद कोड को खुद समझकर ठीक कर सकते हैं? «CodeOwnership» इसी एक बात को मापने की कोशिश करता है।
यहां «स्वामित्व» से आशय कॉपीराइट या लाइसेंस से नहीं है। इसका मतलब है कोड के तर्क को समझते हुए, AI की मदद के बिना उसमें बदलाव कर पाने की क्षमता—यानी रखरखाव के काम में आपकी वास्तविक दक्षता। टेस्ट पास होना यह साबित कर सकता है कि सॉफ्टवेयर अनुकूल परिस्थितियों में काम करता है, लेकिन यह नहीं कि आप उसके भीतर के कोड को समझते हैं। यही अंतर इस टूल का शुरुआती आधार है।
इसकी प्रक्रिया GPS बंद करके की जाने वाली परीक्षा जैसी है
प्रक्रिया इस तरह चलती है। पहले AI एजेंट कोई सुविधा लागू करता है। फिर डेवलपर 5 के पैमाने पर दर्ज करता है कि वह कोड को कितना समझता है। इसके बाद एक अलग एजेंट, पहले से दर्ज विनिर्देशों के मुताबिक, उसमें सिर्फ 1 बग डालता है। अंत में डेवलपर AI बंद करके, खराबी की रिपोर्ट के सहारे समस्या का कारण ढूंढ़ता है।
तीन चीज़ें दर्ज की जाती हैं: काम शुरू करने से पहले किया गया आत्म-मूल्यांकन, AI के बिना डिबगिंग में मिली सफलता या असफलता (समय-सीमा 60 मिनट), और काम के बाद पूछे जाने वाले समझ के 4 सवाल। इन सबको मिलाकर एक अंक नहीं दिया जाता, बल्कि अलग-अलग रिपोर्ट किया जाता है। एक ही अंक देने से «समझ लेने का एहसास» और कोड पर खुद काम करते समय मिलने वाला नतीजा—इन दोनों के बीच का अंतर दिखाई नहीं देगा।
लेखक इसकी तुलना ऐसे ड्राइवर से करते हैं जो हमेशा नेविगेशन पर निर्भर रहता है। उससे पूछें, «क्या आपको घर जाने का रास्ता पता है?» तो वह «हां» कहेगा। असली जवाब तभी मिलेगा जब स्मार्टफोन बंद होगा। कहा जा सकता है कि «CodeOwnership» उस स्मार्टफोन को बंद करने का टूल है।
निष्पक्षता बनाए रखने के उपाय
लेखक इस टूल के डिज़ाइनर भी हैं और परीक्षण-विषय भी। इसलिए पक्षपात कम करने के लिए इसमें कई उपाय किए गए हैं। नियमों वाली फ़ाइल को हैश मान (एक तरह का फिंगरप्रिंट, जो सामग्री बदलने पर बदल जाता है) से लॉक किया जाता है; उसमें बदलाव हुआ हो तो टूल चलना बंद कर देता है। यह शोध में योजना को पहले से दर्ज करने की सोच के करीब है।
बग लेखक खुद नहीं, बल्कि एक अलग एजेंट डालता है। लेखक को पता होता है कि «क्या खराब होगा», लेकिन वह यह अंतर नहीं देखते कि «कहां बदलाव किया गया»। डिबगिंग के दौरान इस्तेमाल की जाने वाली वर्किंग कॉपी में Git का इतिहास, विनिर्देश, छिपे हुए टेस्ट या मूल्यांकन के मानदंड शामिल नहीं होते। आत्म-मूल्यांकन बग डाले जाने से पहले और स्पष्टीकरण अंक दिखाए जाने से पहले कमिट करना ज़रूरी है। इन पाबंदियों के सही ढंग से काम करने की पुष्टि के लिए 72 स्व-परीक्षण भी तैयार किए गए हैं।
आत्मविश्वास का अंक 4, लेकिन बग नहीं मिला
परीक्षण के लिए फ़ोल्डर सुविधा वाली नोट्स लाइब्रेरी बनाई गई। इसमें नोट्स बनाना और प्राप्त करना, फ़ोल्डर बनाना और हटाना, नोट्स को एक जगह से दूसरी जगह ले जाना और फ़ोल्डर में मौजूद नोट्स की सूची देखना संभव है। एक ही नोट को कई फ़ोल्डरों में भी रखा जा सकता है। यहां अहम नियम यह है कि फ़ोल्डर हटाने पर नोट्स बने रहते हैं; सिर्फ़ फ़ोल्डर के साथ उनका जुड़ाव हटता है।
इसे लागू करने का काम ChatGPT ने किया (मुफ़्त अकाउंट, Auto मॉडल, अस्थायी चैट)। 11 सार्वजनिक टेस्ट और 13 निजी स्वीकृति टेस्ट सभी पास हुए और आधारभूत जांच भी सफल रही। लेखक ने कोड पढ़ने के बाद अपनी समझ को 5 में से 4 अंक दिए और बग डाले जाने से पहले इसे Git में दर्ज कर दिया। इसके बाद Claude के एक अलग सेशन ने सिर्फ़ विनिर्देशों के आधार पर बदलाव किया और व्यवहार की जांच भी पास हुई।
डिबगिंग शुरू होने के 8 मिनट 12 सेकंड बाद लेखक कारण ढूंढ़ने में नाकाम रहे और उन्होंने काम रोक दिया। उनके मुताबिक, पिछले दिन तक तैयारी में आई दिक्कतों के कारण वे थके हुए और चिड़चिड़े थे। टूल में सिर्फ़ दो विकल्प थे—«ठीक कर दिया» या «समय-सीमा समाप्त»। आगे बढ़ने के लिए लेखक ने «ठीक कर दिया» चुना। हालांकि, उन्होंने कोड में कोई बदलाव नहीं किया था और वस्तुनिष्ठ जांच का नतीजा «ठीक नहीं हुआ» था। सभी 11 सार्वजनिक टेस्ट पास हुए, जबकि 13 में से 10 निजी टेस्ट पास हुए और 3 विफल रहे। समझ के 4 सवाल भी नहीं किए गए, इसलिए रिपोर्ट में स्थिति «अधूरी» दर्ज हुई।
डाला गया बदलाव सिर्फ़ 2 पंक्तियों का था
बाद में सामने आया कि फ़ोल्डर हटाने की प्रक्रिया में सिर्फ़ 2 पंक्तियां जोड़ी गई थीं। अगर किसी नोट से जुड़े फ़ोल्डर खाली हो जाएं, तो उस नोट को संग्रहण से हटा दिया जाए। बस इतना ही। जो नोट कई फ़ोल्डरों में रखे हैं, उनका एक जुड़ाव बाकी रहता है, इसलिए वे सुरक्षित रहते हैं। लेकिन जो नोट सिर्फ़ एक ही फ़ोल्डर में हैं, वे उस फ़ोल्डर के साथ मिट जाते हैं।
पहली नज़र में, शर्तें तर्कसंगत लगती हैं। सूची खाली है, इसलिए उसे मिटा दें—बात कुछ ऐसी है। लेकिन किसी चीज़ का किसी से जुड़ा न होना और नोट का गैरज़रूरी होना, दोनों अलग बातें हैं। लेखक पीछे मुड़कर कहते हैं कि अगर उन्होंने खुद से यह पूछा होता कि “इस ऐप में नोट मिटाने की ज़िम्मेदारी किसकी है?”, तो उन्हें सुराग मिल सकता था। सवाल यह था कि क्या वे सिर्फ़ कोड के शब्दों पर नज़र रखने के बजाय भूमिकाओं के बँटवारे की कल्पना कर पा रहे थे।
एक व्यक्ति का प्रयास क्या बता सकता है
नतीजे को समझते समय सावधानी ज़रूरी है। यह परीक्षण सिर्फ़ एक डेवलपर ने किया, इसमें एक ही विषय था और डिबगिंग को बीच में रोकने का केवल एक प्रयास हुआ। लेखक खुद भी कहते हैं कि इस प्रयोग से यह नहीं बताया जा सकता कि AI इस्तेमाल करने वालों की कोड की समझ उथली हो जाती है या नहीं। समय-सीमा 60 मिनट थी, और यह परीक्षण यह भी नहीं बताता कि जारी रखने पर क्या वे बग ढूँढ़ पाते।
बाद में करीब 30 मिनट लगाकर कारण तक पहुँचने का ज़िक्र है। लेकिन यह उनका अपना बयान है; समय भी नहीं नापा गया और सुधार की जाँच भी नहीं हुई, इसलिए इसे प्रदर्शन के नतीजे में नहीं गिना गया। लेखक यह भी बताते हैं कि टूल के डिज़ाइनर होने के नाते उन्हें पता था कि “क्या टूटेगा”; वे थकान और तैयारी संबंधी समस्याओं के असर को अलग-अलग नहीं कर सकते; वे उस मूल योजना से हट गए थे जिसमें वर्किंग फ़ोल्डर के भीतर चलने वाले एजेंट का इस्तेमाल होना था; और इस्तेमाल किए गए टूल का संयोजन बीच में बदल गया था। पुनरुत्पादन के लिए निजी परीक्षण और अंक देने के मानदंड रिपॉज़िटरी में सार्वजनिक किए गए हैं, इसलिए इन्हें पढ़ने वाले लोग अगर खुद प्रयास करें, तो ब्लाइंड परीक्षण की शर्तें बरकरार नहीं रख पाएँगे।
फिर भी, यह एक प्रयास एक उपयोगी बात दिखाता है। “आत्मविश्वास 4 है, सभी टेस्ट पास हैं” और “मैं इसे सचमुच खुद ठीक कर सकता हूँ”—ये दोनों स्थितियाँ एक जैसी हों, यह ज़रूरी नहीं। इस प्रयास को पढ़ने का सबसे ईमानदार तरीका यही है कि इसे उस बात का ठोस उदाहरण माना जाए।
आसपास के शोध से मिलने वाले संकेत
लेखक इस सवाल की पृष्ठभूमि में कई शोधों का हवाला देते हैं। हालाँकि, इनमें से कोई भी इस टूल की पुष्टि नहीं करता; इन्हें सिर्फ़ उस संदर्भ के तौर पर पेश किया गया है जिसमें यह सवाल उठता है।
METR के जुलाई 2025 में प्रकाशित एक अध्ययन में, 16 अनुभवी ओपन-सोर्स डेवलपरों ने अपने रिपॉज़िटरी के 246 वास्तविक मुद्दों पर AI टूल का इस्तेमाल किया। नतीजे में काम पूरा करने में 19% ज़्यादा समय लगा। डेवलपरों ने पहले से 24% तेज़ होने का अनुमान लगाया था और काम ख़त्म होने के बाद भी उन्हें लगा कि वे 20% तेज़ रहे। अध्ययन ने काम करने में लगे समय को मापा था, कोड की समझ को नहीं। METR ने इस नतीजे को पुराना पड़ चुका बताया है और फरवरी 2026 में कहा कि वह प्रयोग की रूपरेखा की समीक्षा करेगा।
Anthropic के जनवरी 2026 में प्रकाशित एक अध्ययन में Python लाइब्रेरी “Trio” सीख रहे 52 इंजीनियर शामिल थे, जिनमें से अधिकतर कम अनुभवी डेवलपर थे। AI-सहायता वाले समूह ने बाद में हुई क्विज़ में औसतन 50% अंक हासिल किए, जबकि कोड हाथ से लिखने वाले समूह ने 67% अंक पाए; इस अंतर को सांख्यिकीय रूप से महत्वपूर्ण माना गया। AI समूह ने काम करीब 2 मिनट पहले पूरा किया, लेकिन समय का यह अंतर महत्वपूर्ण नहीं था। दूसरी ओर, स्पष्टीकरण माँगने या आगे सवाल पूछने का तरीका सीखने के बेहतर नतीजों से जुड़ा था। लगता है कि फ़र्क AI के इस्तेमाल से ज़्यादा, उसे इस्तेमाल करने के तरीके से पड़ सकता है। यह भी जोड़ना चाहिए कि लेखक ने स्पष्ट किया है कि वे आम तौर पर Claude का इस्तेमाल करते हैं और इस लेख को तैयार करने में भी उन्होंने इसका उपयोग किया।
स्वचालन से छिनता “अभ्यास” का संसाधन
एक क्लासिक लेख का भी संदर्भ दिया गया है। 1983 में, लिसैन बेनब्रिज ने अपने लेख “Ironies of Automation” में तर्क दिया था कि स्वचालन बढ़ने के साथ लोगों के अभ्यास के अवसर घटते जाते हैं और किसी गड़बड़ी के समय नियंत्रण अपने हाथ में लेने पर इस कमी का असर पड़ता है। विमान का ऑटोपायलट और पायलट का कौशल इसका एक आम उदाहरण है।
1985 में, पीटर नाउर ने “Programming as Theory Building” में लिखा कि प्रोग्रामिंग सिर्फ़ कोड लिखने तक सीमित नहीं है, बल्कि सॉफ़्टवेयर कैसे काम करता है, इसकी समझ (थ्योरी) विकसित करने की प्रक्रिया है। जब एजेंट कोड लिखता है और इंसान सिर्फ़ उसे मंज़ूरी देता है, तो यह समझ कितनी बची रहती है? यह सवाल फरवरी 2025 में आंद्रेज कार्पथी द्वारा बताए गए “वाइब कोडिंग” से भी जुड़ता है—यानी ऐसा तरीका जिसमें आउटपुट को ज़्यादा पढ़े बिना स्वीकार कर लिया जाता है। इस्तेमाल करके छोड़ दिए जाने वाले वीकेंड प्रोजेक्ट में यह आसान लग सकता है, लेकिन ऐसे सॉफ़्टवेयर का क्या होगा जिसकी देखरेख ज़रूरी है?
आज से किया जा सकने वाला आसान अभ्यास
पूरा संस्करण इंस्टॉल किए बिना भी इसी सोच पर आधारित अभ्यास किया जा सकता है। AI से लिखवाए गए किसी एक छोटे कोड को चुनें और पहले 5 के पैमाने पर दर्ज करें कि “अगर आज रात यह ख़राब हो जाए, तो क्या मैं इसे ठीक कर पाऊँगा?” फिर AI के एक अलग सेशन से उसके व्यवहार में सिर्फ़ एक बदलाव करवाएँ और बदलावों की तुलना न करें। टाइमर चालू करें, AI सेशन बंद करें और सिर्फ़ लक्षणों के विवरण के आधार पर उसे ठीक करने की कोशिश करें। सही जवाब देखने से पहले अपने शब्दों में लिखें कि समस्या का कारण क्या था, फिर शुरुआती आत्म-मूल्यांकन और नतीजे की तुलना करें।
कभी आत्मविश्वास होने के बावजूद बग नहीं मिलेगा, तो कभी आप उसे उम्मीद से जल्दी ठीक कर लेंगे। दोनों ही बातें ऐसी हैं, जिनका पता सिर्फ़ यह देखकर नहीं चलता कि सभी टेस्ट पास हो गए हैं। पूरा संस्करण आज़माने के लिए रिपॉज़िटरी का सेल्फ-टेस्ट चलाने और उसके बाद freeze तथा pilot कमांड चलाने के निर्देश दिए गए हैं।
लेखक चार सीख बताते हैं। शुरू करने से पहले अपना आकलन करें। समझें कि टेस्ट पास होना और कोड को ठीक कर पाना दो अलग बातें हैं। कुछ सचमुच खराब होने से पहले अभ्यास करें। और AI से कोड समझाने को कहें। Anthropic के शोध में भी, जिन प्रतिभागियों ने स्पष्टीकरण या अतिरिक्त सवाल मांगे, उनका प्रदर्शन बेहतर रहा। हालांकि, लेखकों ने इसे कारण-परिणाम का संबंध नहीं, बल्कि सहसंबंध बताया है।
V0.2 में क्या बदलेगा
लेखक का कहना है कि अगले संस्करण में चार बदलाव किए जाएंगे। पहला, «हार मान ली» को सही ढंग से दर्ज करने का विकल्प जोड़ा जाएगा। उपयोगकर्ता के जवाब और वस्तुनिष्ठ जांच के नतीजे साथ दिखाए जाएंगे, ताकि उन्हें केवल «ठीक कर दिया» या «समय सीमा समाप्त हो गई» में से एक चुनने के लिए मजबूर न होना पड़े। दूसरा, तैयारी के काम की थकान को नतीजों पर असर डालने से रोकने के लिए, डीबगिंग से पहले आराम का समय रखा जाएगा। तीसरा, शुरुआती योजना पर वापस लौटते हुए ऐसे एजेंट का इस्तेमाल किया जाएगा जो प्रोजेक्ट के फ़ोल्डर में काम करे और खुद टेस्ट भी चला सके। चौथा, अन्य डेवलपरों से भी यही प्रक्रिया आज़माने को कहा जाएगा। सिर्फ़ एक व्यक्ति के नतीजे से यह नहीं कहा जा सकता कि यह टूल दूसरों के लिए कितना कारगर होगा।
コメント