
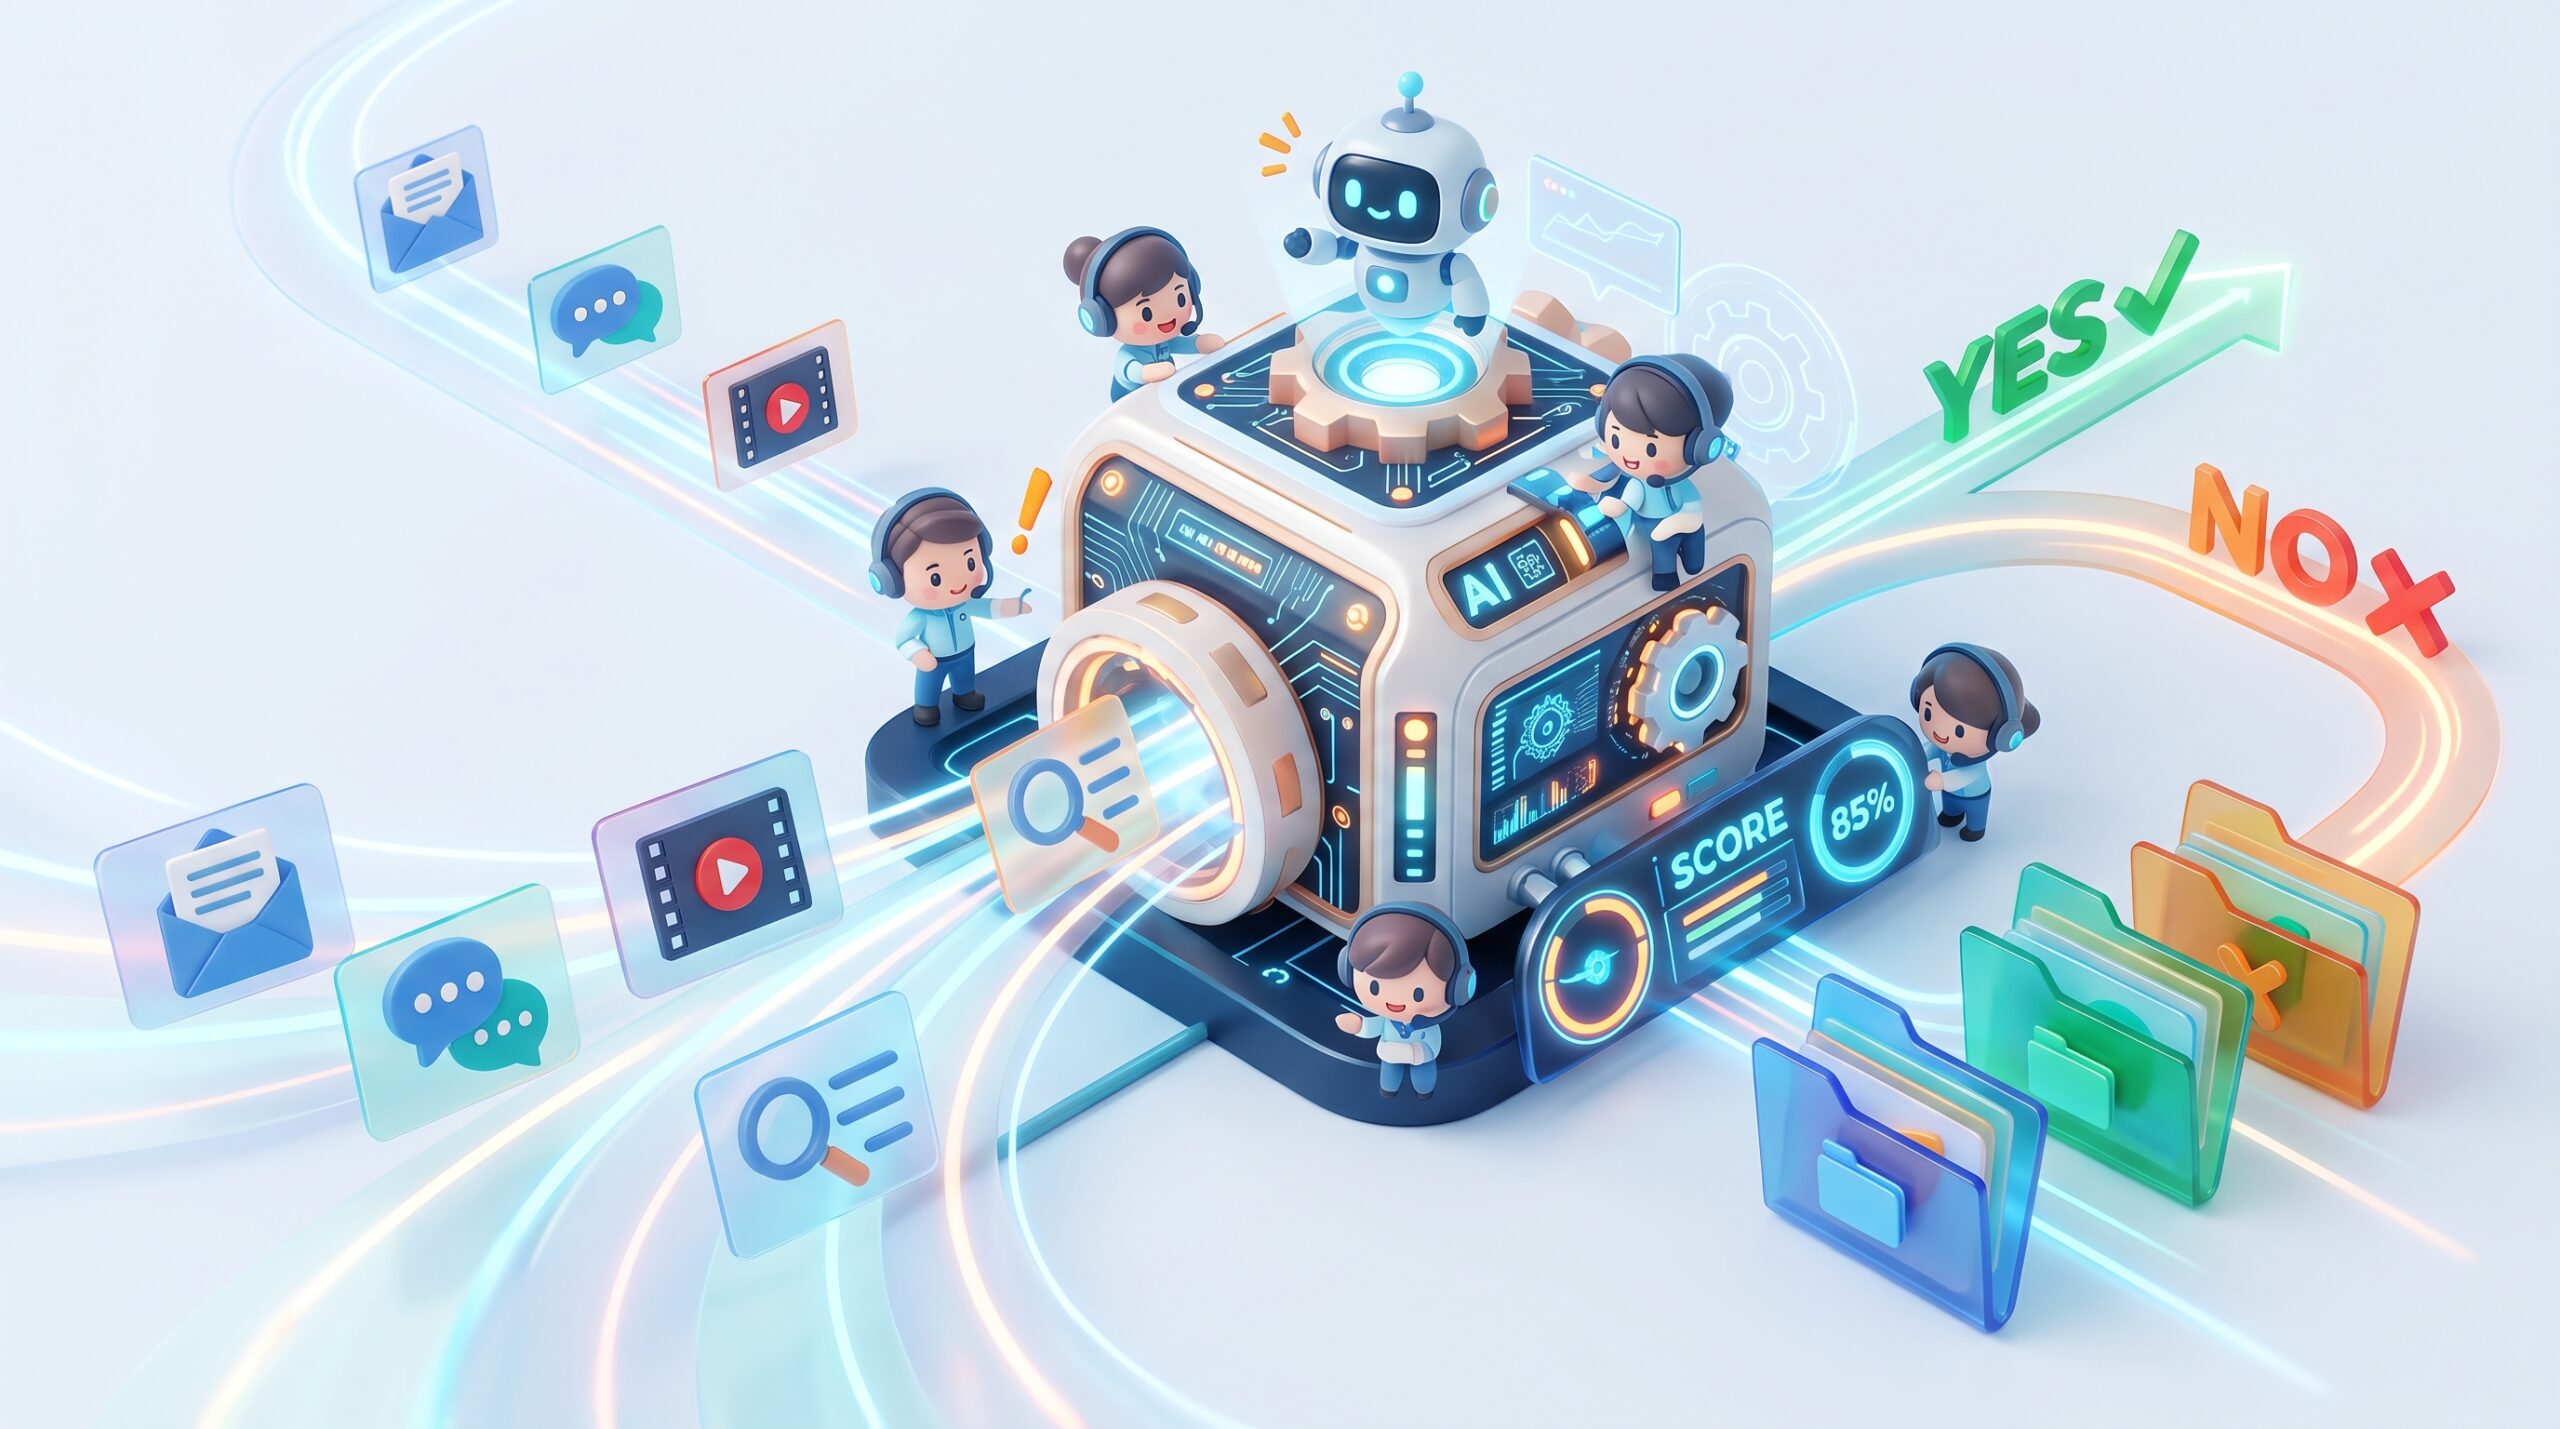
Jev de TypeSafe est une IA conçue pour intégrer dans des applications des évaluations, des classifications et des notes portant sur des textes. Voici une présentation de Jev.
Jev n’est pas un interlocuteur, mais un outil de décision intégré aux applications
Pour comprendre Jev, le plus simple est de se demander quel type de réponse on attend de l’IA. Il ne s’agit pas de demander « Explique ce texte », mais plutôt « Ce texte est-il une publicité ? », « Est-ce professionnel ou personnel ? » ou « Dans quelle mesure ce résultat de recherche est-il pertinent ? ». Jev traite ce type de questions, dont le format de réponse peut être défini à l’avance.
Les IA conversationnelles classiques sont surtout connues pour répondre aux questions sous forme de texte. Jev, en revanche, est pensé pour être utilisé par les développeurs au sein de leurs logiciels. Plutôt que de dialoguer directement avec Jev, les utilisateurs le retrouvent en coulisses, dans les applications qu’ils utilisent au quotidien, où il sert à trier les informations et à orienter les traitements.
L’API constitue le point de contact. Une API est une interface qui permet à une application de demander un traitement à un autre service et d’en recevoir le résultat. On envoie un texte et une question à Jev, puis on récupère son évaluation pour déterminer l’étape suivante dans l’application.
Les réponses prennent la forme d’évaluations, de choix ou de notes
Les documents présentent trois grands types d’utilisation : déterminer, par exemple, si un contenu est une publicité ; choisir parmi plusieurs possibilités, comme un dossier de destination ; et attribuer une note, par exemple pour mesurer la pertinence d’un résultat de recherche. Comme elles sont chargées de prendre des décisions, ces IA sont présentées comme des « modèles de décision ».
Par exemple, une application de tri des e-mails pourrait prendre le corps d’un message en entrée et choisir une catégorie parmi « professionnel », « personnel » et « autre ». Cet exemple sert à expliquer le fonctionnement : au lieu de lire une longue explication puis d’en extraire la catégorie, l’application reçoit directement une réponse qu’elle peut exploiter.
Les grands modèles de langage classiques peuvent eux aussi effectuer des classifications et produire des résultats dans un format défini. La différence ne tient donc pas à leur capacité à classer, mais au fait que Jev est conçu et proposé principalement pour ce type de prise de décision. Les documents disponibles ne permettent toutefois pas de vérifier la structure interne de Jev ni ses performances par rapport aux modèles de langage courants.
Réduire les petites frictions dans les recherches et le visionnage de vidéos
Parmi les exemples de développement cités figurent une extension qui passe les séquences sponsorisées des vidéos YouTube, une fonction qui retire les commentaires négatifs des conversations, une recherche Gmail adaptée aux intentions de l’utilisateur et le filtrage de tâches. D’autres essais visent à modifier des opérations comme le copier-coller, le glisser-déposer ou la recherche dans une page.
Ces exemples ont un point commun : il s’agit moins de créer de nouveaux textes que de sélectionner des informations déjà disponibles. Garder les passages que l’on veut voir, retrouver les e-mails recherchés, filtrer les éléments à traiter. On peut y voir un déplacement de l’IA, de la fenêtre de discussion vers les gestes du quotidien.
Cependant, les exemples de développement présentés ne sont pas nécessairement des fonctionnalités fiables et prêtes à l’emploi. Retirer les « commentaires négatifs », par exemple, suppose de distinguer le harcèlement de la critique légitime, ce qui peut changer le sens du résultat. Avant le déploiement, il faut définir ce que l’on souhaite exclure et vérifier les cas où le système a supprimé des éléments à tort.
Le rôle de l’IA ne se limite pas à générer du texte
Un document daté du 10 octobre 2026 présente plusieurs entreprises qui proposent des modèles de décision sous une forme similaire à celle de Jev. Ces modèles renvoient des réponses directement exploitables par les logiciels : probabilité qu’une condition soit remplie, choix parmi plusieurs options ou évaluation sur une échelle.
Cette évolution s’explique notamment par le fait qu’une IA qui exécute plusieurs tâches n’a pas besoin de produire de longs textes à chaque étape. Pour décider du traitement à appliquer ensuite ou vérifier si un résultat répond à certaines conditions, des choix ou des valeurs d’évaluation suffisent à poursuivre le processus.
L’approche de Jev consiste à intégrer une fonction de décision dans une application plutôt qu’à traiter l’IA comme un interlocuteur. Cependant, un format de réponse simple ne signifie pas que la décision elle-même est facile à prendre. Le même document fait état de premières évaluations qui soulignent des difficultés persistantes concernant la cohérence des modèles de décision et les choix complexes.
Avant de privilégier la rapidité, il faut définir les limites des décisions confiées à l’IA
Pour une utilisation concrète, il est judicieux de commencer par distinguer « ce que l’on veut faire décider » de « ce qui se passe en cas d’erreur ». Les conséquences d’une erreur ne sont pas les mêmes lorsqu’il s’agit d’attribuer une étiquette à un e-mail ou de masquer automatiquement un commentaire. Il faut aussi envisager de renvoyer à un humain les cas difficiles à trancher.
Le fait de renvoyer des réponses courtes ne réduit pas nécessairement le coût total du système. Les documents soulignent également que l’intégration de cette solution pour condenser l’historique des conversations d’une IA d’assistance au codage pourrait compromettre le mécanisme de réduction des coûts fondé sur la réutilisation des entrées précédentes.
Les documents disponibles ne précisent pas la grille tarifaire de Jev, ne fournissent aucune vérification indépendante de sa précision et n’indiquent pas les conditions de conservation et d’utilisation des données. Pour un déploiement impliquant des e-mails professionnels ou des commentaires de clients, il convient de vérifier séparément ces conditions ainsi que le taux d’erreur sur des données réelles.

コメント