
TypeSafeのJevは、文章に対する判定や分類、採点をアプリに組み込むためのAIです。今回はJevについて説明します。
Jevは会話相手ではなくアプリの判断係です
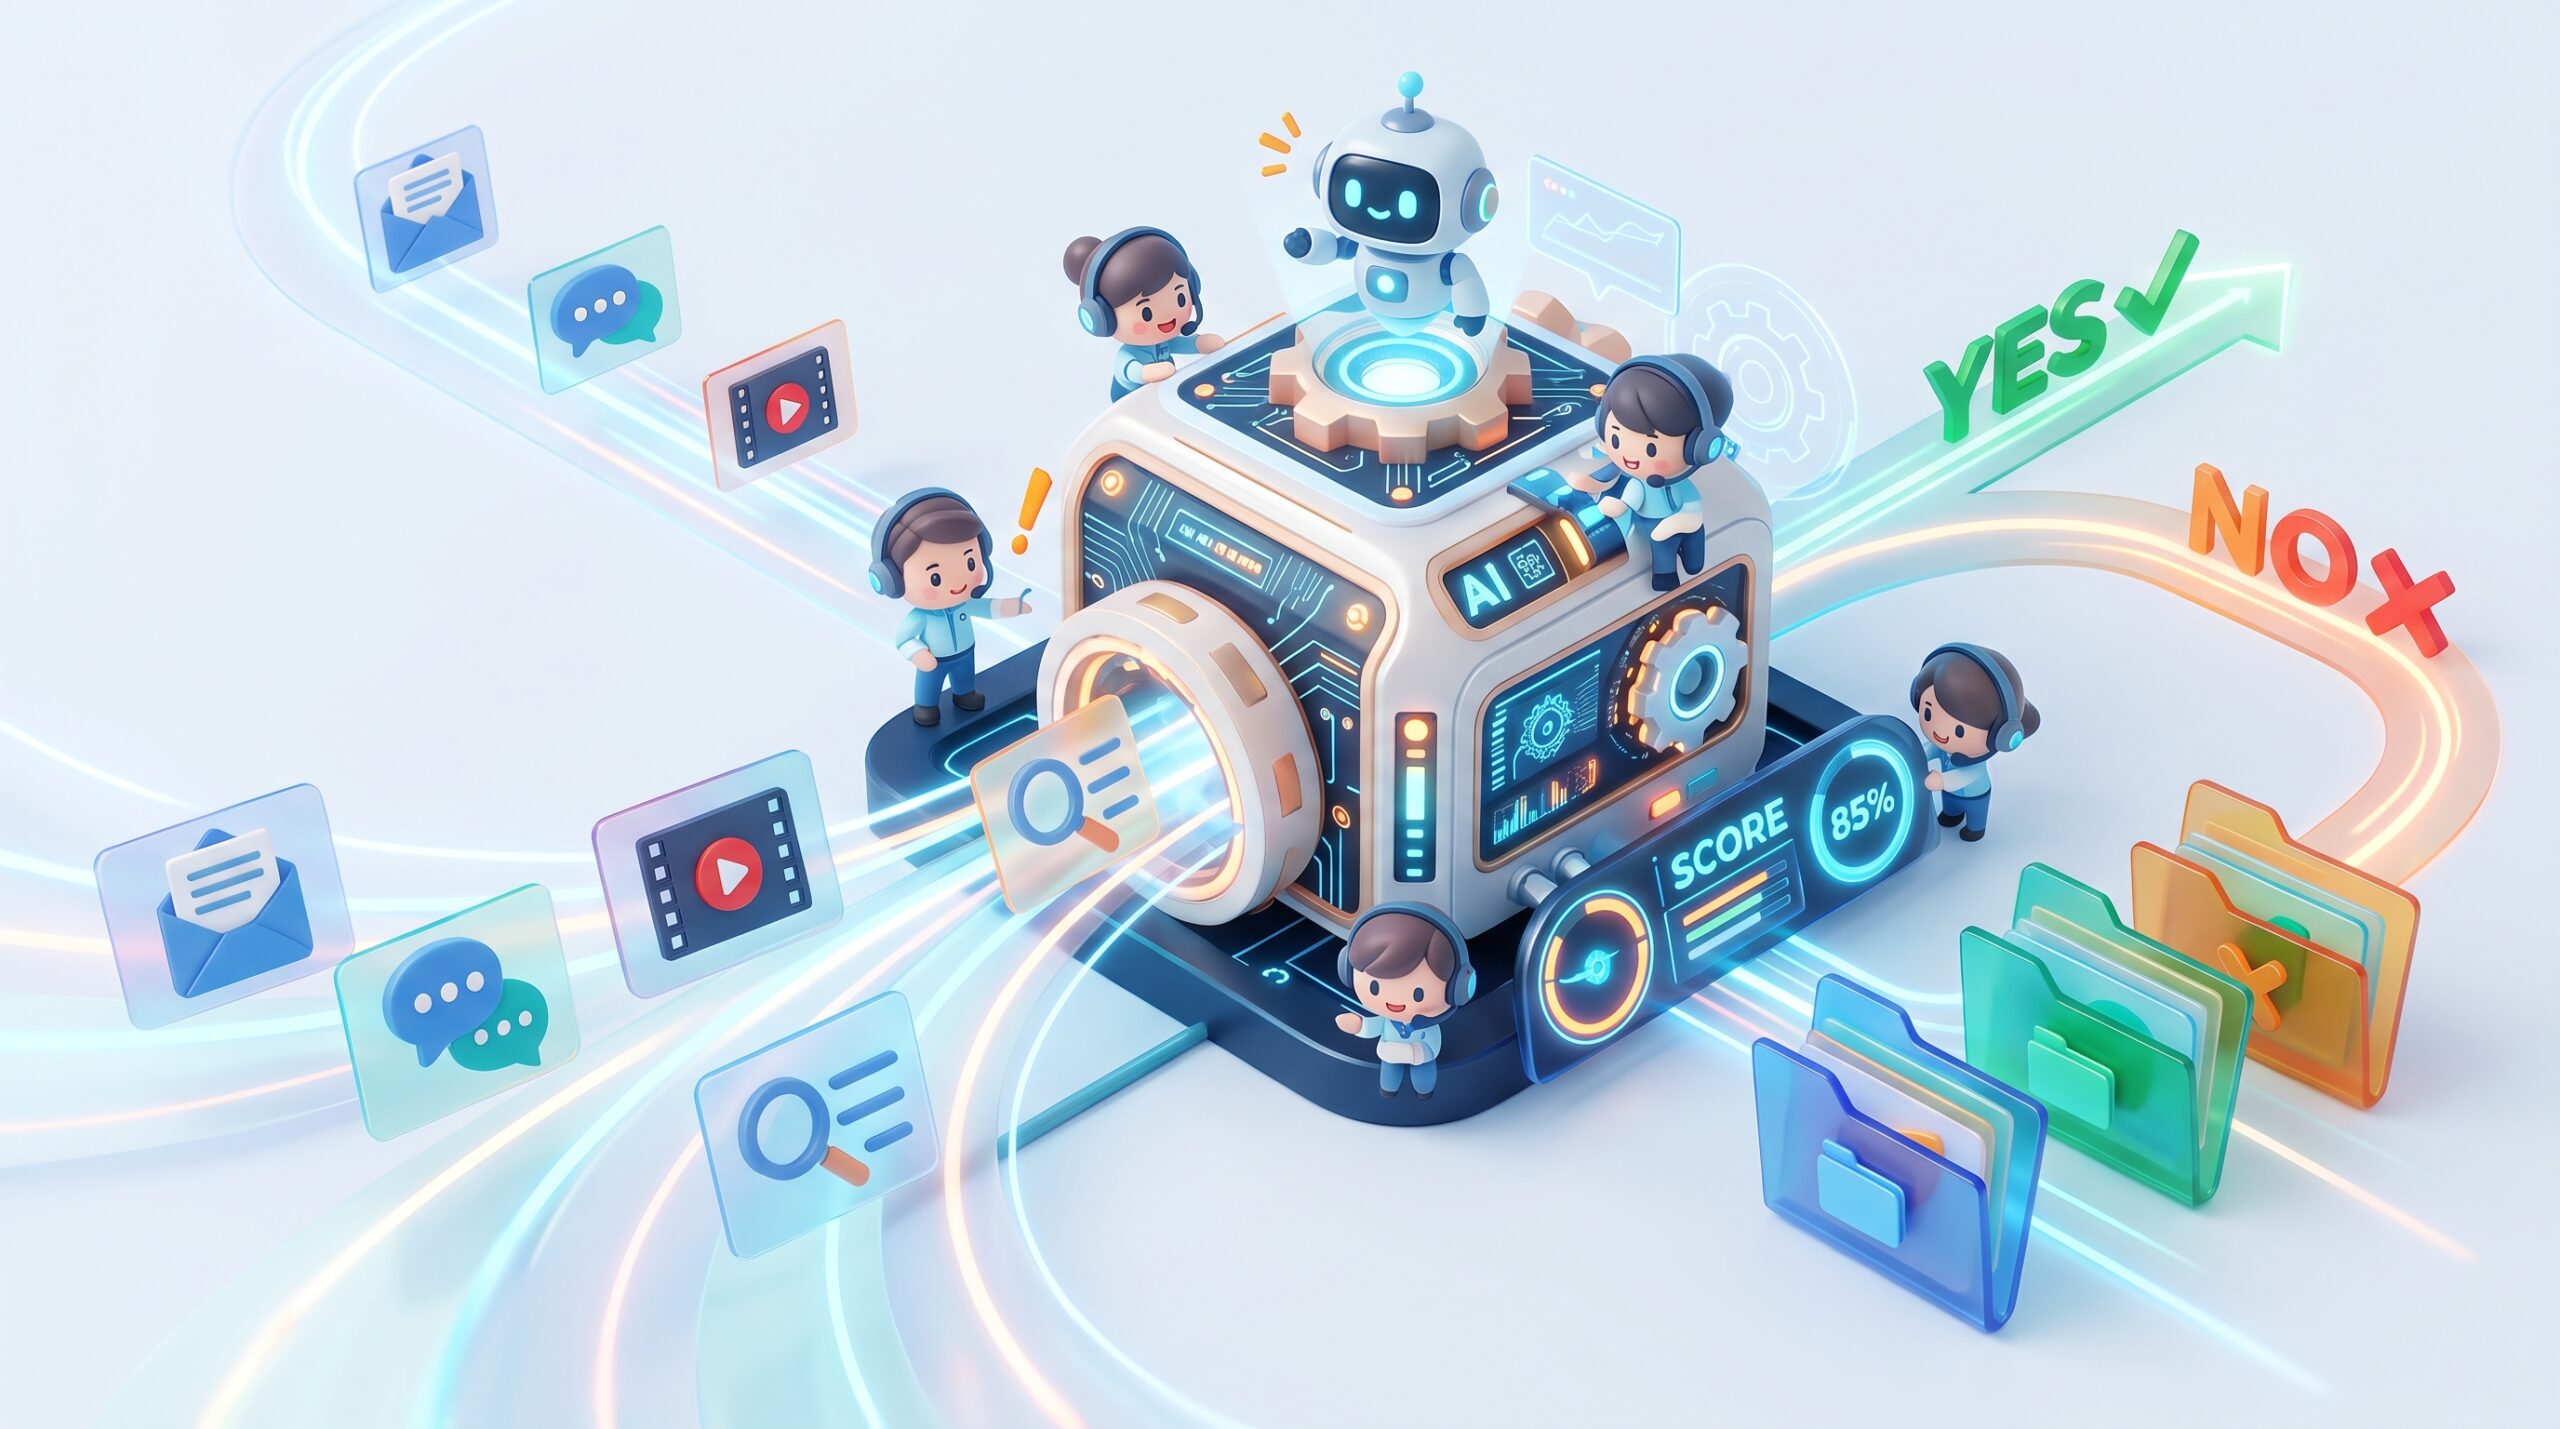
Jevを理解する近道は、AIに何を返してほしいかを考えることです。「この文章を説明して」ではなく、「この文章は広告か」「仕事と私用のどちらか」「検索結果としてどれくらい関連しているか」。こうした、答えの形式をあらかじめ決められる問いを扱います。
一般的な対話型AIは、質問に文章で答える使い方がよく知られています。一方、Jevは開発者がソフトウェアの内部で使うことを想定しています。利用者がJevと直接会話するというより、普段使うアプリの裏側で、情報の仕分けや処理の分岐を担う位置づけです。
その接点になるのがAPIです。APIとは、アプリから別のサービスに処理を依頼し、結果を受け取るための窓口です。Jevに文章と質問を送り、判定結果を受け取って、アプリの次の動作につなげます。
返ってくるのは判定や選択肢や点数です
資料で紹介されている使い方は、大きく三つです。広告かどうかのような判定、保存先フォルダーのような候補からの選択、検索結果の関連度のような採点です。判断を担うモデルという意味で、こうしたAIは「判断モデル」として紹介されています。
例えば、メールを整理するアプリなら、本文を入力し、「仕事」「私用」「その他」という候補から分類先を選ばせる使い方が考えられます。これは仕組みを説明するための例ですが、長い説明文を読んでから分類先を取り出すのではなく、アプリが使う答えを直接受け取る発想です。
通常の大規模言語モデルでも、分類や決まった形式での出力は可能です。違いは、分類ができるかどうかではなく、そうした判断を主な用途として設計・提供している点にあります。ただし、提供資料だけでは、Jevの内部構造や一般的な言語モデルとの性能差までは確認できません。
検索や動画視聴の小さな手間を減らす
開発例として挙げられているのは、YouTube動画のスポンサー区間を飛ばす拡張機能、チャットから否定的なコメントを除く機能、利用者の意図に沿ったGmail検索、タスクの絞り込みなどです。コピー&ペーストやドラッグ&ドロップ、ページ内検索の操作を変える試みも紹介されています。
これらに共通するのは、文章を新しく作ることより、すでにある情報を選ぶことです。見たい部分を残す、探しているメールを拾う、処理すべき項目を絞る。AIの出番が、チャット画面から日常の操作へ移るという見方ができます。
ただし、紹介された開発例と、安定した製品機能は別です。例えば「否定的なコメント」を取り除く場合、嫌がらせと正当な批判をどう区別するかで結果の意味が変わります。導入時には、何を除外したいのかを決め、誤って消した例も含めて確かめる必要があります。
AIの仕事は文章生成だけではありません
2026年10月10日付の資料では、Jevに似た形式の判断モデルを複数の企業が提供する動きが紹介されています。条件が成立する確率、候補からの選択、段階別の評価など、ソフトウェアがそのまま扱いやすい答えを返す方式です。
背景には、AIが複数の作業を進める際、すべての段階で長い文章が必要なわけではないという事情があります。次にどの処理を使うか、結果が条件を満たすか、といった分岐では、選択肢や判定値があれば処理を進められます。
Jevの切り口は、AIを一人の会話相手として扱うより、アプリの中に判断機能を配置することにあります。ただし、答えの形式が単純でも、判断そのものが簡単とは限りません。同資料には、判断モデルの一貫性や複雑な意思決定には課題が残るという初期評価も記載されています。
導入では速さより先に判断の境界を決める
実際に使うなら、まず「何を判断させるか」と「間違えたときに何が起きるか」を分けて考えるのが現実的です。メールにラベルを付ける処理と、コメントを自動で非表示にする処理では、誤判定の影響が違います。判断に迷うケースを人に戻す設計も検討対象です。
短い答えを返すからといって、システム全体の費用が必ず下がるわけでもありません。資料には、コーディング支援AIの会話履歴を圧縮する用途への組み込みが、過去の入力を再利用して費用を抑える仕組みを損なう可能性も指摘されています。
提供資料にはJevの具体的な料金表、独立した精度検証、データの保存・利用条件は含まれていません。業務メールや顧客のコメントを扱う導入では、これらの条件と、実際の入力に対する誤判定率を別途確認する必要があります。

コメント