
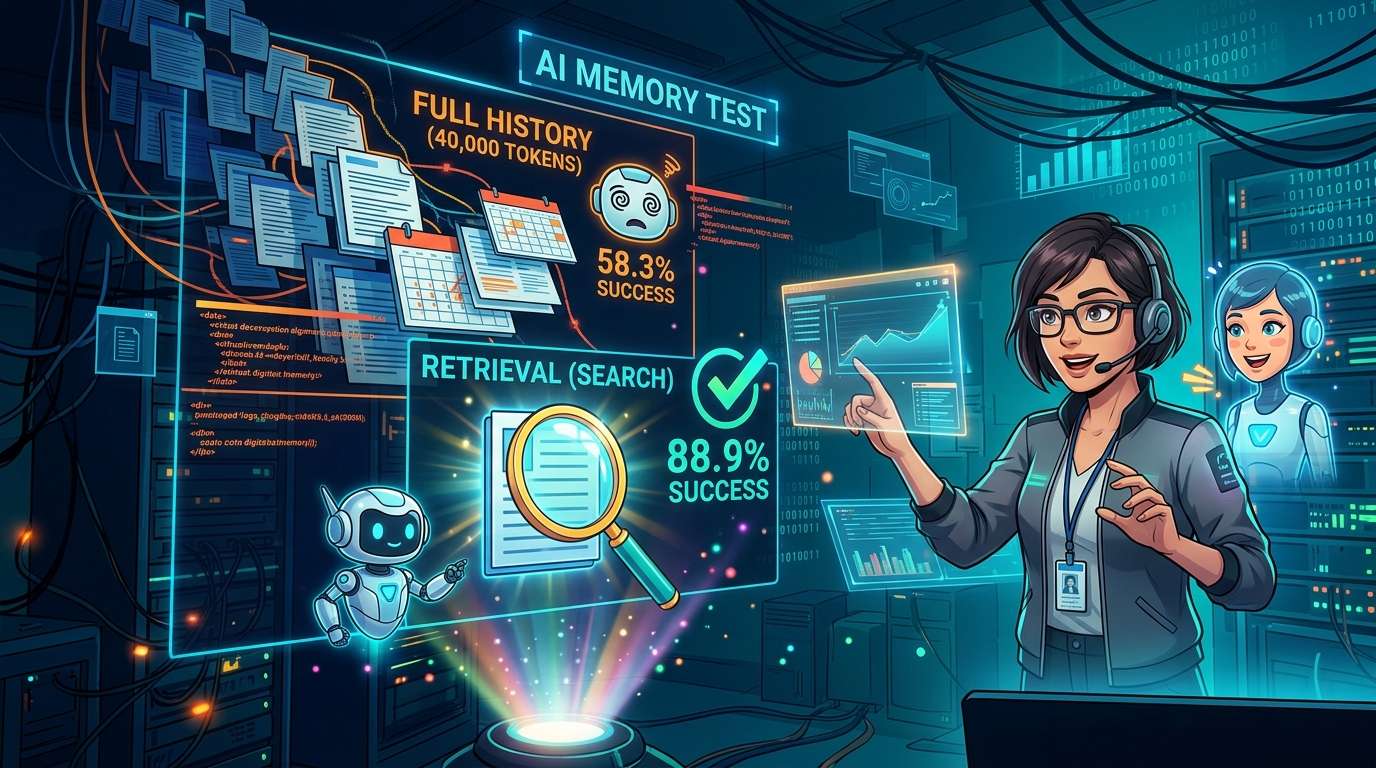
Une étude comparant quatre méthodes pour doter les assistants IA d’une « mémoire » a été publiée sur Towards Data Science, un média spécialisé dans la science des données. Lors d’un test fondé sur l’historique d’environ 40 000 tokens d’un chef de projet fictif et sur 30 demandes, GPT-4o mini a réussi 58,3 % des tâches lorsqu’on lui fournissait l’historique intégral, contre 88,9 % avec une méthode de recherche qui ne lui transmettait que les passages nécessaires.
« Se souvenir » et « savoir utiliser » sont deux choses différentes
Le point de départ de cette étude est DolphinBench, un nouveau test des capacités de mémoire de l’IA. L’article complet est disponibledans cet article de vérification.
La plupart des tests de mémoire traditionnels posent directement des questions sur des faits passés, par exemple : « Quel est le café préféré de Sam ? » Les auteurs de DolphinBench soulignent toutefois que la question elle-même indique déjà qu’une réponse est consignée quelque part. Le test demande donc à l’IA d’effectuer une tâche, comme « commande du café », afin de vérifier si elle utilise le bon fait.
Le protocole prévoit trois personnages fictifs, chacun doté d’un historique de conversation d’environ 500 000 tokens, et 200 demandes par personne. Les résultats doivent rendre compte non seulement de la précision, mais aussi du coût et du temps d’exécution.
Ce test a été créé par une entreprise qui commercialise un système de mémoire appelé Mem0. Dans ses résultats, la configuration de l’entreprise arrive en tête, avec 70,67 % de demandes réussies. L’auteur de l’étude n’a ni reproduit DolphinBench ni testé le produit d’une entreprise en particulier. Il s’est simplement inspiré de son approche pour concevoir une petite expérience.
Quatre méthodes de mémorisation testées avec Dana, cheffe de projet fictive
L’expérience met en scène Dana Whitfield, une cheffe de projet fictive. Les chercheurs ont préparé un historique de conversation couvrant une année, composé de 80 échanges, dans lequel ils ont intégré des éléments à repérer.
Un an d’historique et 30 demandes
L’historique compte environ 40 000 tokens. Trente échanges mentionnent chacun un fait, comme le restaurant où elle déjeune habituellement, l’heure d’une réunion, la date de lancement d’un projet ou le nom d’un responsable. Onze échanges modifient par la suite ces faits, tandis que les 39 autres portent sur des sujets anodins, comme une imprimante, un train ou la météo. Des conversations ordinaires ont été délibérément mêlées aux faits pour que ceux-ci ne ressortent pas.
Les 30 demandes prennent la forme d’appels à des outils pour planifier une réunion, commander un repas, envoyer un message ou attribuer une tâche. Neuf d’entre elles nécessitent deux faits, par exemple le nom d’un responsable et une date. L’évaluation ne tient pas compte du texte de la réponse : elle vérifie uniquement si les valeurs transmises à l’outil sont correctes. Une question classique sur chacun des faits a également été préparée afin de vérifier si le modèle pouvait répondre avec la valeur la plus récente.
Les quatre méthodes comparées
Quatre méthodes ont été comparées : « sans mémoire », où rien n’est fourni ; « historique intégral », où les 40 000 tokens d’historique sont transmis à chaque fois ; « résumé », où l’historique est lu progressivement et un résumé d’environ 1 000 mots est réécrit au fil du temps ; et « recherche », où cinq extraits d’historique liés à la demande sont récupérés et transmis.
Pour résumer, il s’agit soit de remettre chaque matin le journal d’une année entière, soit de fournir une fiche récapitulative préparée par quelqu’un, soit d’extraire les pages pertinentes à chaque nouvelle demande.
Les modèles utilisés étaient GPT-4o mini d’OpenAI et Claude Haiku 4.5 d’Anthropic, pour un total de 1 260 exécutions. Les journaux de toutes les expériences sont conservés sur Weights & Biases, un outil de gestion d’expériences.
コメント