
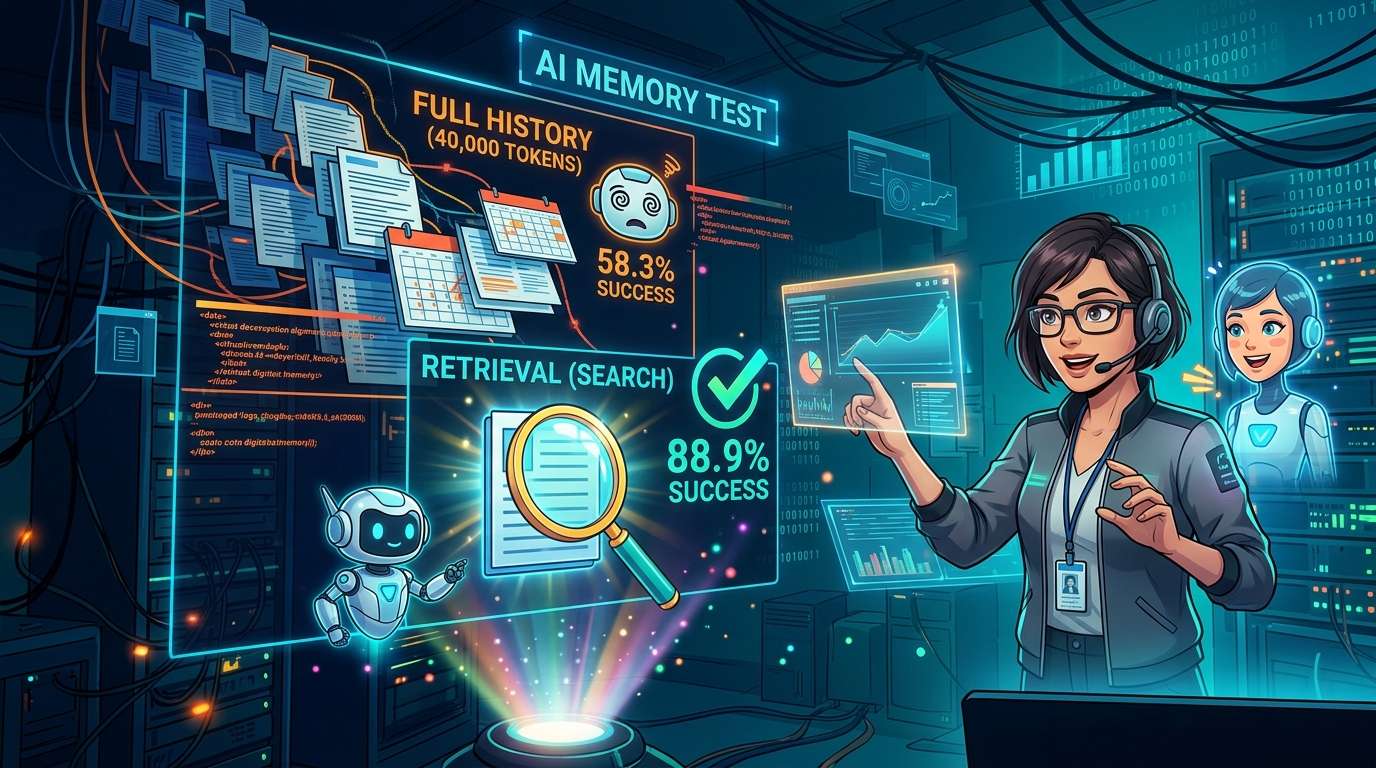
一項比較讓 AI 助理擁有「記憶」的 4 種方法的測試,刊登於資料科學媒體 Towards Data Science。測試使用一名虛構專案經理約 4 萬個 token 的歷史紀錄,以及 30 項請求;結果顯示,GPT-4o mini 的任務成功率,在每次提供完整歷史紀錄的方式下為 58.3%,在只搜尋並提供所需內容的方式下則達 88.9%。
「記得」和「用得上」是兩回事
這項測試的出發點,是一項衡量 AI 記憶能力的新測試「DolphinBench」。全文可見這篇測試文章。
許多傳統記憶測試會直接詢問過去的事實,例如「山姆喜歡哪家咖啡店?」不過,DolphinBench 的作者認為,問題本身就會暗示「答案記錄在某處」,這是個問題。因此,這項測試會交辦「幫我點咖啡」之類的工作,藉此確認 AI 是否能運用正確資訊。
測試設計為 3 名虛構人物各自擁有約 50 萬個 token 的對話歷史紀錄,並分別接受 200 項請求。結果除了準確度,也必須同時報告費用和耗時。
這項測試由銷售記憶系統 Mem0 的企業所設計。該公司公布的結果顯示,其系統成功完成 70.67% 的請求,排名第一。本文作者並未重現 DolphinBench,也沒有測試特定企業的產品,而是借用其概念,自行設計了一項小型實驗。
以虛構專案經理 Dana 測試 4 種記憶方法
實驗主角是虛構的專案經理 Dana Whitfield。作者準備了她一整年、共 80 則的對話歷史紀錄,並在其中埋下線索。
一年的歷史紀錄與 30 項請求
歷史紀錄約有 4 萬個 token。其中 30 則各自提到一項事實,例如常去的午餐店、會議時間、專案發布日期或負責人。有 11 則內容會在之後更改這些事實,其餘 39 則則是關於印表機、火車或天氣等閒聊。為了不讓重要事實太過醒目,作者刻意混入日常對話。
共有 30 項請求,形式是呼叫設定會議、點餐、傳送訊息或指派任務等工具,其中 9 項需要用到兩項事實,例如負責人和日期。評分時不讀取回覆文字,只判斷傳給工具的值是否正確。作者也針對相同事實各設計了一道一般問答題,檢查模型能否以最新資訊作答。
比較的 4 種方式
共有 4 種方式:不提供任何資訊的「無記憶」、每次都提供完整 4 萬個 token 歷史紀錄的「完整歷史」、逐步閱讀歷史紀錄並反覆改寫約 1,000 字摘要的「摘要」,以及取出 5 段與請求最相關的歷史紀錄提供給模型的「搜尋」。
打個比方,差別就在於:每天早上把一整年的日記交給模型、交給它某人整理的一張小抄,或是在每次收到請求時只摘出相關頁面。
使用的模型為 OpenAI 的 GPT-4o mini 和 Anthropic 的 Claude Haiku 4.5,總共執行 1,260 次。所有實驗紀錄都保存在實驗管理工具 Weights & Biases。
コメント