
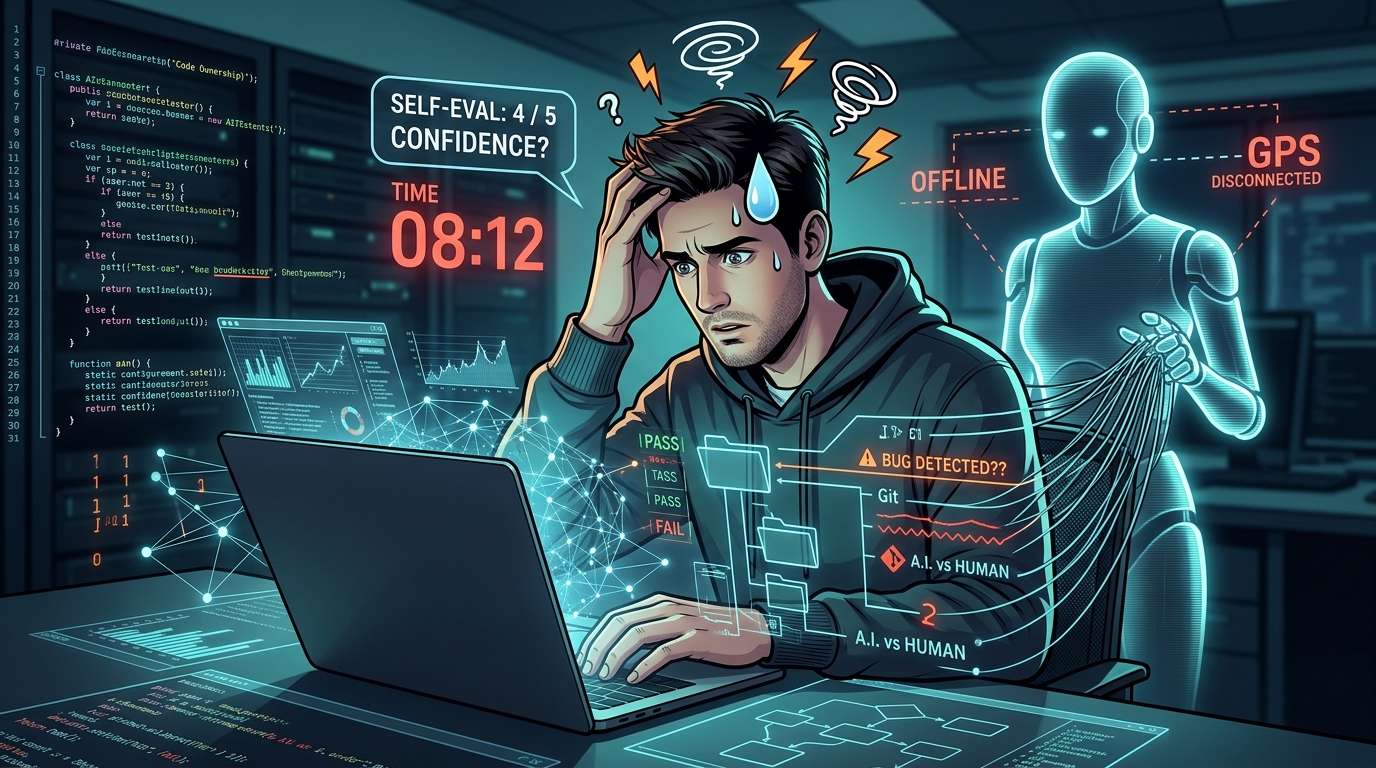
AIが実装したコードを、書いたAIに頼らず保守できるのか。開発者のEmmimal Alexander氏は、この問いを測る検証ツール「CodeOwnership」のV0.1を公開しました。
初回の試行では、本人が理解度を5段階で4と自己評価したものの、別のAIが仕込んだバグを60分の制限のうち8分12秒で探せないまま中断しています。
名前がコミットに残っていても、直せなければ「自分のコード」ではない
テストはすべて緑、ビルドも通った。そう聞けば、多くの人は安心してマージ(本流への統合)ボタンを押します。ところが3週間後に不具合の報告が届き、AIアシスタントは使えない。クォータ(利用枠)を使い切った、あるいは電波の入らない通勤電車の中、という状況です。そのとき手元のコードを自力で読み解いて直せるのか。CodeOwnershipが測ろうとしているのは、この一点です。
ここでの「所有」は、著作権やライセンスの話ではありません。コードの論理をたどり、AIの助けなしに修正できるかという、保守の現場での実力を指しています。テストが通ることは、ソフトウェアが好条件で動くことの証明にはなっても、中身を理解していることの証明にはならない。この区別が出発点です。
仕組みはGPSを切るテストに近い
流れはこうです。まずAIエージェントが機能を実装します。次に開発者が、自分がどれだけ理解しているかを5段階で記録します。続いて別のエージェントが、事前に登録した仕様に沿ってバグを1つだけ仕込みます。最後に開発者はAIを切った状態で、障害報告を手がかりに原因を探します。
記録するのは3つです。作業前の自己評価、AIなしでのデバッグの成否(制限は60分)、作業後に答える4問の理解確認。これらは1つの点数にまとめず、別々に報告されます。点数を1つにすると、「分かったつもり」と「実際に触ったときの結果」のずれが見えなくなるためです。
作者はこれを、いつもナビに頼るドライバーにたとえています。「家までの道は分かりますか」と聞けば「はい」と答える。スマートフォンを切って初めて、本当の答えが出る。CodeOwnershipは、そのスマホの電源を切る道具だと言えます。
公平性を保つための工夫
作者は、ツールの設計者であり被験者でもあります。そのため偏りを減らす仕掛けが多く入っています。ルールのファイルはハッシュ値(内容が変わると値が変わる指紋のようなもの)で固定され、変更されていれば実行が止まります。研究で計画を事前登録する発想に近いものです。
バグを仕込むのは作者自身ではなく、別のエージェントです。作者は「何が壊れるか」という挙動は知っていますが、「どこを変えたか」の差分は見ません。デバッグ中に使う作業コピーには、Gitの履歴も仕様も非公開テストも採点基準も含まれません。自己評価はバグが入る前に、説明文は点数が表示される前にコミットする決まりです。こうした制約が正しく働くことを確かめる自己テストが72件用意されています。
自信は4、バグは見つからず
題材は、フォルダー機能つきのノートライブラリーです。ノートの作成・取得、フォルダーの作成・削除、ノートの移動、フォルダー内の一覧表示ができ、同じノートを複数のフォルダーに入れることもできます。肝になる決まりは、フォルダーを削除してもノートは残り、消えるのはフォルダーとの紐づけだけという点です。
実装はChatGPT(無料アカウント、モデルはAuto、一時チャット)が担当しました。公開テスト11件、非公開の受け入れテスト13件がすべて通り、基準確認は合格。作者はコードを読んだうえで、理解度を5段階で4と評価し、バグが入る前にGitへ記録しました。その後、別のClaudeセッションが仕様だけを頼りに変更を加え、挙動の検証も通っています。
デバッグ開始から8分12秒。作者は原因を見つけられないまま、作業を打ち切りました。前日までの準備のトラブルで疲れ、いら立っていたとのことです。ツールの選択肢は「修正した」か「制限時間切れ」の2択しかなく、作者は先へ進むために「修正した」を選びました。ただしコードには手を入れておらず、客観チェックの結果は「未修正」。公開テストは11件すべて通過し、非公開テストは13件中10件の通過、3件が失敗でした。理解確認の4問も未実施のため、報告書は「未完了」と記録されています。
仕込まれたのは、たった2行
後で明かされた変更は、フォルダー削除の処理に加えられた2行でした。ノートの所属フォルダーが空になったら、そのノートを保管場所から削除する。これだけです。複数のフォルダーに入っているノートは1つ紐づけが残るので無事ですが、1つのフォルダーにしか入っていないノートは、フォルダーと一緒に消えます。
一見すると、条件は筋が通って見えます。リストが空だから消す、という流れです。しかし、所属先がないことと、ノートが不要であることは別の話です。作者は、もし「このアプリでノートを消す責任はどこにあるのか」と問い直していれば手がかりになっただろうと振り返っています。コードの文面を追うだけでなく、役割分担を頭に描けているかが問われたわけです。
一人の試行が語れる範囲
結果の読み方には注意が要ります。試行したのは開発者1人、題材は1つ、デバッグは途中で止めた1回だけです。作者自身も、AIを使う人のコード理解が浅くなるかどうかは、この実験からは言えないとしています。制限は60分あり、続けていれば見つけられたのかどうかも、この試行では分かりません。
後日、約30分かけて原因にたどり着いたという記述はあります。ただしこれは本人の自己申告で、時間も計っておらず、修正の検証も行っていないため、成績としては数えられていません。作者は、ツールの設計者であるため「何が壊れるか」を知っていた点、疲労や準備のトラブルの影響を切り分けられない点、作業フォルダー内で動くエージェントを使う当初の計画から外れた点、ツールの組み合わせが途中で変わった点も挙げています。非公開テストと採点基準は再現性のためにリポジトリで公開されているため、読んだ人が試す場合は、ブラインドの条件を保てないという制約もあります。
それでも、この1回には使いどころがあります。「自信は4、テストは全部緑」という状態と、「実際に自力で直せる」という状態が、同じとは限らない。その具体例として読むのが、いちばん誠実な扱い方でしょう。
周辺の研究が示す手がかり
作者は、この問いの背景として複数の研究を引いています。ただし、どれも今回のツールを裏づけるものではなく、問題意識の文脈を示すものとして紹介されています。
METRが2025年7月に公表した調査では、経験豊富なオープンソース開発者16人が、自分のリポジトリの実際の課題246件にAIツールを使って取り組みました。結果は、完了までの時間が19%長くなったというものです。開発者は事前に24%速くなると予想し、終了後も20%速くなったと感じていました。測っているのは作業時間で、コードの理解度ではありません。なおMETRはこの結果を古くなったものと位置づけ、2026年2月には実験設計を見直すと表明しています。
Anthropicが2026年1月に公表した研究では、Pythonのライブラリー「Trio」を学ぶ52人のエンジニア(多くは経験の浅い開発者)が対象でした。AI支援ありのグループは後のクイズで平均50%、手で書いたグループは67%で、差は統計的に有意とされています。AIグループは約2分早く終えましたが、この時間差は有意ではありません。一方で、説明を求めたり追加で質問したりした使い方は、学習成果が高い傾向と関連していました。AIを使うこと自体より、使い方が分かれ目になりそうです。作者が普段Claudeを使い、この記事の作成にも使ったことを明記している点も付け加えておきます。
自動化が奪う「練習」という資産
古典も参照されています。1983年、リサーン・ベインブリッジは論文「Ironies of Automation」で、自動化が進むほど人間の練習機会が減り、異常時に引き継ぐ場面でその不足が響くと論じました。飛行機の自動操縦と、操縦士の腕の関係が典型です。
1985年にはペーター・ナウアが「Programming as Theory Building」で、プログラミングとはコードを書くことにとどまらず、ソフトの仕組みについての理解(理論)を築く営みだと述べています。エージェントが書き、人間が承認するだけの流れで、その理解はどこまで手元に残るのか。2025年2月にアンドレイ・カルパシー氏が語った「バイブコーディング」、つまり出力をあまり読まずに受け入れるスタイルは、使い捨ての週末プロジェクトなら気軽でも、保守が必要なソフトではどうなるのか、という問いにもつながります。
今日からできる簡易ドリル
完全版をインストールしなくても、同じ発想の練習はできます。AIに書かせた小さなコードを1つ選び、まず「今夜これが壊れたら直せるか」を5段階で記録します。次に、別のセッションのAIに挙動を1つだけ変えてもらい、差分は見ません。タイマーを回し、AIのセッションを閉じて、症状の報告だけを頼りに修復を試みます。原因は答え合わせの前に自分の言葉で書き出し、最後に最初の自己評価と結果を並べて比べます。
自信があったのに見つからないこともあれば、思ったより早く直せることもあるでしょう。どちらも、テストが全部通っているだけでは分からなかったことです。完全版を試したい場合は、リポジトリの自己テストを実行し、続けてfreeze、pilotの各コマンドを実行する手順が用意されています。
作者が挙げる教訓は4つです。始める前に自分を評価しておくこと。テストが通ることと直せることは別だと知ること。本当に壊れる前に練習しておくこと。そしてAIに、コードの説明を頼むこと。Anthropicの研究でも、説明や追加質問を求めた参加者の成績が高かったとされています。ただし著者らはこれを因果ではなく関連と述べています。
V0.2で変えること
作者は次の版で、4点を変えるとしています。1つ目は、「諦めた」を正しく記録できる選択肢の追加です。ユーザーの回答と客観チェックの結果を並べて表示し、「修正した」と「制限時間切れ」の2択を強いないようにします。2つ目は、準備作業の疲れが結果に響かないよう、休憩を挟んでからデバッグすること。3つ目は、プロジェクトのフォルダー内で動き、テストも自分で走らせられるエージェントを使うという当初の計画に戻すこと。4つ目は、他の開発者にも同じ手順を試してもらうことです。1人分の結果だけでは、ツールが他の人にどこまで通用するかは言えないためです。
コメント