
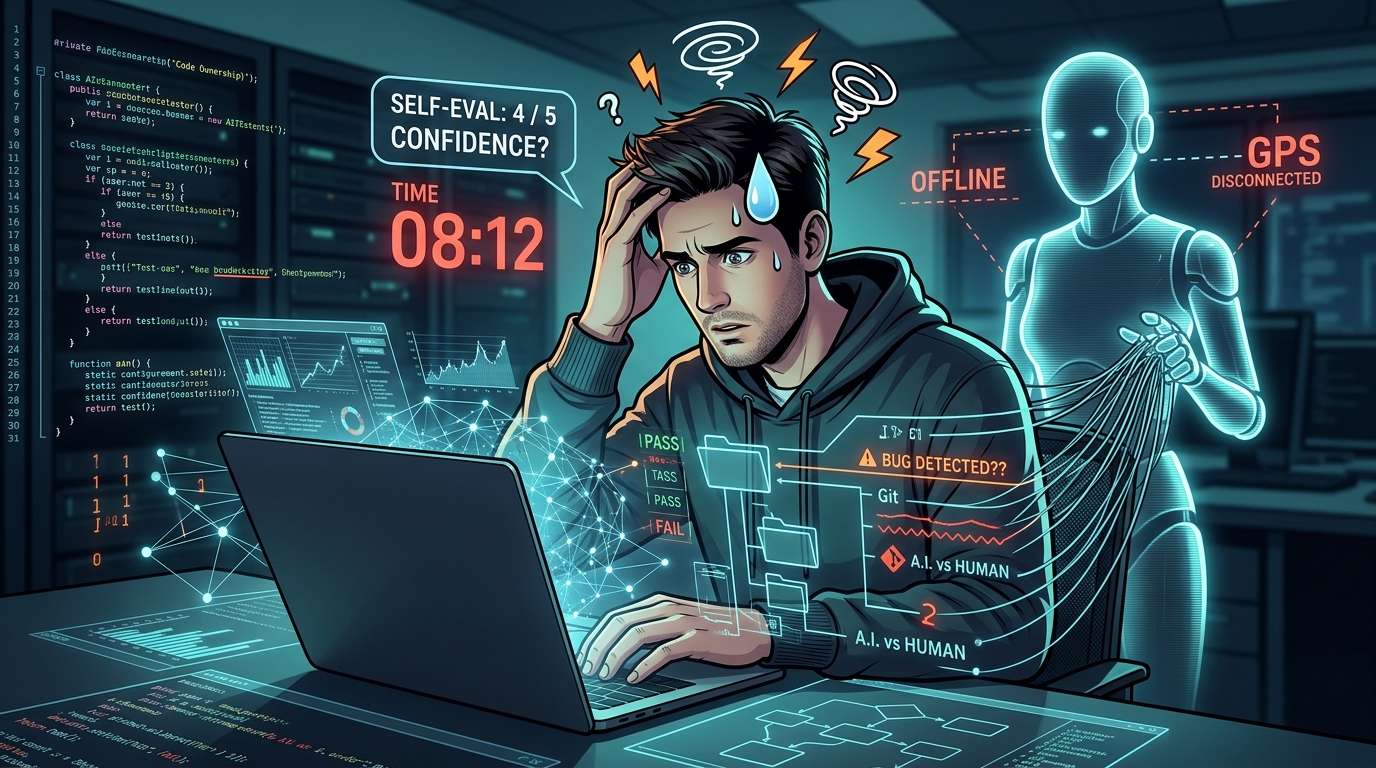
Será possível manter código implementado por IA sem recorrer à IA que o escreveu? O programador Emmimal Alexander publicou a versão V0.1 da «CodeOwnership», uma ferramenta de avaliação criada para responder a esta pergunta.
Na primeira tentativa, apesar de se ter avaliado com 4 em 5 quanto ao seu nível de compreensão, interrompeu o teste sem conseguir encontrar um erro introduzido por outra IA, ao fim de 8 minutos e 12 segundos do limite de 60 minutos.
O código não é «seu» se não o consegue corrigir, mesmo que o seu nome conste do commit
Os testes passaram todos e a compilação também. Perante essa informação, muitas pessoas carregariam tranquilamente no botão de merge (integração no ramo principal). Mas, três semanas depois, chega uma comunicação de um problema e o assistente de IA não está disponível. O limite de utilização esgotou-se ou a pessoa está num comboio sem rede. Será que consegue analisar e corrigir o código por conta própria? É precisamente isto que a CodeOwnership pretende medir.
Aqui, «ser dono» não tem que ver com direitos de autor ou licenças. Refere-se à capacidade prática de seguir a lógica do código e de o corrigir sem ajuda da IA, uma competência essencial na manutenção. O facto de os testes passarem pode provar que o software funciona em condições favoráveis, mas não que se compreende o que está por dentro. É esta a distinção que serve de ponto de partida.
O mecanismo é semelhante a um teste que desliga o GPS
O processo é o seguinte: primeiro, um agente de IA implementa uma funcionalidade. Depois, o programador regista, numa escala de cinco pontos, quanto acha que compreende o código. Em seguida, outro agente introduz um único erro, de acordo com uma especificação registada previamente. Por fim, com a IA desligada, o programador tenta descobrir a causa, usando como pista um relatório do problema.
São registados três elementos: a autoavaliação antes do trabalho, o resultado da depuração sem IA (com um limite de 60 minutos) e um teste de compreensão com quatro perguntas, respondido no final. Os resultados são apresentados separadamente, em vez de serem reunidos numa única pontuação. Caso contrário, deixaria de ser possível ver a diferença entre «achar que se compreende» e o resultado obtido ao mexer efetivamente no código.
O autor compara a situação à de um condutor que depende sempre do GPS. Se lhe perguntarem «Sabe o caminho para casa?», responderá «Sim». Só quando desligar o smartphone é que se saberá a resposta verdadeira. Pode dizer-se que a CodeOwnership é uma ferramenta para desligar esse smartphone.
Medidas para garantir a imparcialidade
O autor é simultaneamente o criador da ferramenta e um dos participantes no teste. Por isso, foram incluídas várias medidas para reduzir possíveis enviesamentos. O ficheiro de regras é fixado através de um hash (uma espécie de impressão digital cujo valor muda quando o conteúdo é alterado); se houver alterações, a execução é interrompida. A ideia é semelhante ao pré-registo de um plano num estudo de investigação.
O erro não é introduzido pelo próprio autor, mas por outro agente. O autor sabe que comportamento será afetado, mas não vê as diferenças que indicam onde foi feita a alteração. A cópia de trabalho usada durante a depuração não inclui o histórico do Git, as especificações, os testes não públicos nem os critérios de avaliação. A autoavaliação tem de ser registada antes de o erro ser introduzido, e a explicação tem de ser submetida antes de a pontuação ser apresentada. Existem 72 testes de autoverificação para confirmar que estas restrições funcionam corretamente.
Confiança de 4 em 5, mas o erro passou despercebido
O exemplo é uma biblioteca de notas com funcionalidades de pastas. É possível criar e consultar notas, criar e eliminar pastas, mover notas e ver listagens do conteúdo de uma pasta. Uma mesma nota pode também estar em várias pastas. A regra fundamental é que, ao eliminar uma pasta, as notas permanecem: só é removida a associação à pasta.
A implementação ficou a cargo do ChatGPT (conta gratuita, modelo Auto, conversa temporária). Os 11 testes públicos e os 13 testes de aceitação não públicos passaram, e a verificação dos critérios também foi aprovada. Depois de ler o código, o autor avaliou a sua compreensão em 4 em 5 e registou essa avaliação no Git antes de o erro ser introduzido. Em seguida, uma sessão separada do Claude fez alterações com base apenas nas especificações, e a verificação do comportamento também foi aprovada.
Ao fim de 8 minutos e 12 segundos de depuração, o autor interrompeu o trabalho sem encontrar a causa. Segundo o próprio, estava cansado e irritado por causa de problemas na preparação do dia anterior. A ferramenta só oferece duas opções — «Corrigido» ou «Tempo limite esgotado» — e o autor escolheu «Corrigido» para poder avançar. No entanto, não alterou o código, e a verificação objetiva indicou «Não corrigido». Os 11 testes públicos passaram todos; dos 13 testes não públicos, 10 passaram e três falharam. Como também não respondeu às quatro perguntas de compreensão, o relatório ficou registado como «Incompleto».
O erro consistia em apenas duas linhas
A alteração, revelada mais tarde, consistia em duas linhas acrescentadas ao processo de eliminação de pastas. Se uma nota ficar sem pastas associadas, é eliminada do local onde está guardada. É só isto. As notas que estão em várias pastas mantêm uma associação e não são afetadas; as que estão numa única pasta desaparecem juntamente com ela.
À primeira vista, a condição parece lógica: a lista está vazia, por isso, apaga-se. No entanto, não estar associado a nenhum elemento não significa que a nota seja desnecessária. O autor reflete que uma pista poderia ter surgido se tivesse perguntado: «A quem cabe, nesta aplicação, a responsabilidade de apagar notas?» O que estava em causa era saber se conseguia visualizar a divisão de responsabilidades, em vez de se limitar a seguir o texto do código.
O que uma única tentativa nos pode dizer
É preciso cautela ao interpretar os resultados. Participou apenas um programador, foi usado apenas um exemplo e a depuração foi interrompida a meio numa única ocasião. O próprio autor reconhece que esta experiência não permite concluir se as pessoas que usam IA passam a compreender pior o código. O limite era de 60 minutos e, com esta tentativa, também não é possível saber se teria encontrado o erro caso tivesse continuado.
Há um relato de que, mais tarde, demorou cerca de 30 minutos a chegar à causa. No entanto, trata-se de uma estimativa do próprio: o tempo não foi cronometrado e a correção não foi verificada, pelo que não foi contabilizada como resultado. O autor aponta ainda que, por ser o criador da ferramenta, sabia «o que podia correr mal»; que não é possível separar os efeitos da fadiga e dos problemas de preparação; que a experiência se afastou do plano inicial, que previa usar um agente a funcionar dentro da pasta de trabalho; e que a combinação de ferramentas mudou a meio do processo. Os testes não públicos e os critérios de avaliação estão disponíveis no repositório para permitir a reprodução da experiência, mas isso significa que quem a tentar depois de os consultar não poderá manter as condições de teste cego.
Ainda assim, esta única tentativa é útil para ilustrar uma ideia: um estado de «confiança 4, todos os testes a verde» pode não ser o mesmo que conseguir realmente corrigir o problema sem ajuda. É essa a forma mais honesta de interpretar o exemplo.
Pistas dadas por estudos relacionados
O autor cita vários estudos para contextualizar esta questão. No entanto, nenhum deles valida a ferramenta em causa; são apresentados apenas para enquadrar as preocupações que motivaram o trabalho.
Num estudo divulgado pela METR em julho de 2025, 16 programadores experientes de código aberto usaram ferramentas de IA para trabalhar em 246 problemas reais dos seus próprios repositórios. O resultado foi um aumento de 19% no tempo necessário para concluir as tarefas. Antes da experiência, os programadores esperavam ser 24% mais rápidos e, no final, continuavam a sentir que tinham sido 20% mais rápidos. O estudo mede o tempo de trabalho, não a compreensão do código. A METR considera, além disso, que estes resultados estão desatualizados e anunciou, em fevereiro de 2026, que iria rever o desenho experimental.
Num estudo divulgado pela Anthropic em janeiro de 2026, participaram 52 engenheiros a aprender a biblioteca Python «Trio», muitos dos quais eram programadores com pouca experiência. No questionário posterior, o grupo com apoio de IA obteve uma média de 50%, contra 67% no grupo que escreveu o código à mão; a diferença foi considerada estatisticamente significativa. O grupo com IA terminou cerca de dois minutos mais cedo, mas essa diferença não foi significativa. Por outro lado, pedir explicações ou fazer perguntas adicionais esteve associado a melhores resultados de aprendizagem. Parece que a forma de usar a IA poderá ser mais determinante do que o seu uso em si. Convém também referir que o autor usa habitualmente o Claude e que recorreu a ele para escrever este artigo.
A «prática», um recurso que a automatização pode retirar
O autor recorre também a um estudo clássico. Em 1983, Lisanne Bainbridge argumentou, no artigo «Ironies of Automation», que, quanto mais avança a automatização, menos oportunidades de prática têm as pessoas, e que essa falta se faz sentir quando é preciso assumir o controlo numa situação anómala. A relação entre o piloto automático de um avião e a perícia do piloto é um exemplo típico.
Em 1985, Peter Naur afirmou, em «Programming as Theory Building», que programar não se resume a escrever código: é também construir uma compreensão — uma teoria — do funcionamento do software. Num fluxo de trabalho em que o agente escreve e o ser humano apenas aprova, até que ponto permanece essa compreensão com este último? A questão liga-se também ao «vibe coding», expressão usada por Andrej Karpathy em fevereiro de 2025 para descrever um estilo de trabalho em que se aceitam os resultados sem os ler muito. Pode ser uma abordagem descontraída para projetos descartáveis de fim de semana, mas o que acontece quando se trata de software que precisa de manutenção?
Um exercício simples para começar hoje
É possível praticar a mesma ideia sem instalar a versão completa. Escolha um pequeno trecho de código escrito por IA e comece por avaliar, numa escala de cinco pontos, se conseguiria corrigi-lo caso avariasse esta noite. Depois, peça a uma IA, numa sessão separada, que altere apenas um comportamento, sem consultar as diferenças. Inicie um cronómetro, feche a sessão da IA e tente corrigir o problema com base apenas na descrição dos sintomas. Antes de confirmar a resposta, descreva por palavras suas a causa e, por fim, compare a autoavaliação inicial com o resultado.
Por vezes, a confiança é grande, mas o erro não é encontrado; outras vezes, consegue-se corrigi-lo mais depressa do que se esperava. Nenhuma destas situações seria evidente apenas por os testes passarem todos. Quem quiser experimentar a versão completa pode seguir as instruções do repositório: executar o autoteste e, em seguida, os comandos freeze e pilot.
O autor aponta quatro lições: avaliar-se antes de começar; perceber que passar nos testes e ser capaz de corrigir o código são coisas diferentes; praticar antes de algo avariar a sério; e pedir à IA que explique o código. Um estudo da Anthropic também concluiu que os participantes que pediram explicações ou fizeram perguntas adicionais tiveram melhores resultados. Os autores ressalvam, porém, que se trata de uma associação, não de uma relação causal.
O que vai mudar na versão 0.2
O autor afirma que vai introduzir quatro alterações na próxima versão. A primeira é acrescentar uma opção que permita registar corretamente que alguém «desistiu». As respostas dos utilizadores serão apresentadas ao lado dos resultados das verificações objetivas, sem os obrigar a escolher entre «corrigi» e «o tempo acabou». A segunda é fazer uma pausa antes de depurar o código, para que o cansaço do trabalho de preparação não afete os resultados. A terceira é retomar o plano inicial e usar um agente que funcione dentro da pasta do projeto e consiga executar os testes por si. A quarta é pedir a outros programadores que experimentem o mesmo procedimento. Os resultados de uma só pessoa não permitem perceber até que ponto a ferramenta funciona para outras.
コメント