
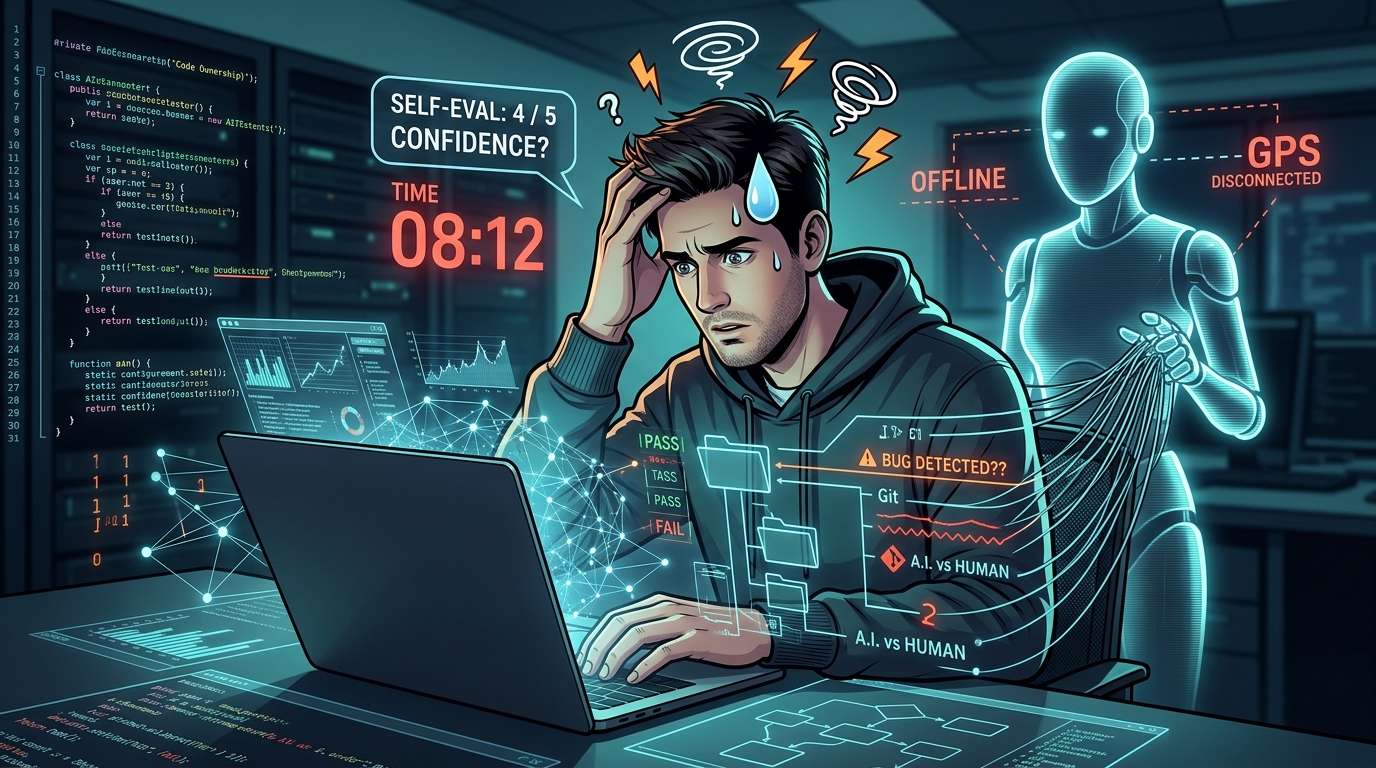
Bisakah kode yang diimplementasikan AI dipelihara tanpa bantuan AI yang menulisnya? Emmimal Alexander, seorang pengembang, merilis V0.1 CodeOwnership, alat uji untuk mengukur hal tersebut.
Dalam uji coba pertama, ia menilai pemahamannya sendiri sebesar 4 dari 5, tetapi menghentikan upaya setelah 8 menit 12 detik tanpa berhasil menemukan bug yang disisipkan AI lain, dari batas waktu 60 menit.
Nama boleh tercantum di commit, tetapi jika tak mampu memperbaikinya, itu bukan «kode sendiri»
Semua tes lulus dan proses build berhasil. Mendengar itu, banyak orang akan merasa tenang lalu mengeklik tombol merge (menggabungkan perubahan ke cabang utama). Namun, tiga minggu kemudian, laporan bug tiba dan asisten AI tak bisa digunakan. Kuota (batas penggunaan) sudah habis, atau mungkin Anda sedang berada di kereta komuter tanpa sinyal. Dalam situasi seperti itu, mampukah Anda memahami dan memperbaiki kode yang ada dengan kemampuan sendiri? Inilah satu hal yang ingin diukur CodeOwnership.
«Kepemilikan» di sini bukan soal hak cipta atau lisensi. Istilah ini merujuk pada kemampuan praktis dalam pemeliharaan perangkat lunak: menelusuri logika kode dan memperbaikinya tanpa bantuan AI. Lulus tes dapat membuktikan bahwa perangkat lunak berfungsi dalam kondisi yang menguntungkan, tetapi bukan bahwa kita memahami isinya. Pembedaan inilah yang menjadi titik awalnya.
Mekanismenya mirip tes dengan GPS dimatikan
Alurnya seperti ini. Pertama, agen AI mengimplementasikan suatu fitur. Lalu, pengembang mencatat seberapa jauh ia memahami kode tersebut, dengan skala 1 sampai 5. Berikutnya, agen lain menyisipkan satu bug saja, sesuai spesifikasi yang telah didaftarkan sebelumnya. Terakhir, pengembang mematikan AI dan mencari penyebab masalah berdasarkan laporan bug.
Ada tiga hal yang dicatat: penilaian diri sebelum bekerja, keberhasilan atau kegagalan melakukan debugging tanpa AI (batas waktu 60 menit), dan empat pertanyaan untuk menguji pemahaman yang dijawab setelahnya. Semua dilaporkan secara terpisah, bukan digabung menjadi satu skor. Sebab, jika dijadikan satu skor, kesenjangan antara «merasa sudah paham» dan hasil saat benar-benar menangani kode akan luput terlihat.
Penulis mengibaratkannya dengan pengemudi yang selalu mengandalkan navigasi. Jika ditanya, «Apakah Anda tahu jalan pulang?», ia akan menjawab, «Ya.» Baru setelah ponselnya dimatikan, jawaban yang sebenarnya terlihat. CodeOwnership bisa dibilang sebagai alat untuk mematikan ponsel itu.
Langkah-langkah untuk menjaga objektivitas
Penulis sekaligus perancang alat ini dan subjek uji coba. Karena itu, sejumlah mekanisme diterapkan untuk mengurangi bias. Berkas aturan dikunci menggunakan nilai hash (semacam sidik jari yang berubah saat isi berkas berubah); jika ada perubahan, proses akan dihentikan. Pendekatan ini mirip dengan gagasan praregistrasi rencana dalam penelitian.
Bug disisipkan oleh agen lain, bukan oleh penulis sendiri. Penulis mengetahui perilaku «apa yang rusak», tetapi tidak melihat perbedaan kode yang menunjukkan «bagian mana yang diubah». Salinan kerja yang digunakan selama debugging tidak memuat riwayat Git, spesifikasi, tes privat, maupun kriteria penilaian. Penilaian diri harus dicatat sebelum bug disisipkan, sedangkan penjelasan harus di-commit sebelum skor ditampilkan. Ada 72 tes mandiri untuk memastikan pembatasan tersebut berfungsi dengan benar.
Menilai diri 4, tetapi tak menemukan bug
Contoh yang digunakan adalah pustaka catatan dengan fitur folder. Pengguna dapat membuat dan mengambil catatan, membuat dan menghapus folder, memindahkan catatan, serta melihat daftar isi folder. Satu catatan juga dapat dimasukkan ke beberapa folder. Aturan utamanya adalah menghapus folder tidak akan menghapus catatan; yang dihapus hanya keterkaitan antara catatan dan folder.
ChatGPT (akun gratis, model Auto, obrolan sementara) menangani implementasi. Sebelas tes publik dan 13 tes penerimaan privat semuanya lulus, begitu pula pemeriksaan kriteria. Setelah membaca kode, penulis menilai pemahamannya 4 dari 5 dan mencatat penilaian itu di Git sebelum bug disisipkan. Setelah itu, sesi Claude terpisah membuat perubahan hanya berdasarkan spesifikasi, dan pemeriksaan perilaku juga berhasil.
Delapan menit 12 detik setelah debugging dimulai, penulis menghentikan pekerjaan tanpa berhasil menemukan penyebabnya. Ia mengaku lelah dan kesal akibat masalah persiapan pada hari sebelumnya. Alat ini hanya menyediakan dua pilihan: «sudah diperbaiki» atau «waktu habis». Agar bisa melanjutkan, penulis memilih «sudah diperbaiki». Namun, ia tidak mengubah kode, dan pemeriksaan objektif menyatakan «belum diperbaiki». Kesebelas tes publik lulus, sedangkan dari 13 tes privat, 10 lulus dan 3 gagal. Empat pertanyaan untuk menguji pemahaman juga belum dikerjakan, sehingga laporan mencatat hasilnya sebagai «belum selesai».
Bug yang disisipkan hanya terdiri dari dua baris
Perubahan yang baru diungkap kemudian adalah dua baris yang ditambahkan pada proses penghapusan folder. Jika sebuah catatan tidak lagi terkait dengan folder mana pun, catatan itu dihapus dari penyimpanan. Hanya itu. Catatan yang berada di beberapa folder tetap aman karena masih memiliki satu keterkaitan, tetapi catatan yang hanya berada di satu folder akan ikut hilang saat folder tersebut dihapus.
Sekilas, alurnya tampak masuk akal: karena daftarnya kosong, hapus saja. Namun, tidak adanya item yang terhubung bukan berarti catatannya tidak diperlukan. Penulis mengenang bahwa petunjuk mungkin muncul jika ia bertanya lagi, “Di bagian mana dalam aplikasi ini tanggung jawab untuk menghapus catatan berada?” Yang diuji bukan sekadar kemampuan mengikuti teks kode, melainkan juga kemampuan membayangkan pembagian tanggung jawab di dalamnya.
Sejauh apa satu percobaan dapat memberi tahu kita
Hasilnya perlu dibaca dengan hati-hati. Percobaan ini hanya melibatkan satu pengembang, satu kasus, dan satu sesi debugging yang dihentikan di tengah jalan. Penulis sendiri mengatakan eksperimen ini tidak dapat menjawab apakah penggunaan AI membuat orang kurang memahami kode. Batas waktunya 60 menit, dan percobaan ini juga tidak menunjukkan apakah masalah itu akan ditemukan seandainya pengerjaan dilanjutkan.
Penulis menyebut bahwa ia berhasil menemukan penyebabnya sekitar 30 menit kemudian. Namun, ini hanya berdasarkan pengakuannya sendiri; waktunya tidak diukur dan perbaikannya tidak diuji, sehingga tidak dihitung sebagai hasil. Penulis juga mencatat sejumlah keterbatasan: sebagai perancang alat tersebut, ia sudah tahu “apa yang akan rusak”; pengaruh kelelahan dan masalah persiapan tidak dapat dipisahkan; percobaan menyimpang dari rencana awal untuk memakai agen yang bekerja di dalam folder proyek; dan kombinasi alat berubah di tengah jalan. Karena pengujian tersembunyi dan kriteria penilaian dipublikasikan di repositori demi reproduksibilitas, siapa pun yang mencobanya setelah membaca materi itu tidak dapat mempertahankan kondisi uji buta.
Meski begitu, satu percobaan ini tetap berguna untuk satu hal: keadaan “percaya diri di angka 4, semua tes lulus” belum tentu sama dengan keadaan “benar-benar mampu memperbaikinya sendiri”. Membacanya sebagai contoh konkret tentang perbedaan itu adalah cara yang paling jujur.
Petunjuk dari penelitian terkait
Penulis mengutip sejumlah penelitian sebagai latar belakang pertanyaan ini. Namun, tak satu pun membuktikan alat yang dibahas kali ini; penelitian-penelitian tersebut disajikan untuk memberi konteks pada persoalan yang diangkat.
Dalam studi yang diterbitkan METR pada Juli 2025, 16 pengembang perangkat lunak sumber terbuka berpengalaman menggunakan alat AI untuk menangani 246 masalah nyata di repositori mereka sendiri. Hasilnya, waktu yang dibutuhkan untuk menyelesaikan pekerjaan meningkat 19%. Sebelum mengerjakan tugas, para pengembang memperkirakan AI akan membuat mereka 24% lebih cepat; setelahnya, mereka tetap merasa 20% lebih cepat. Studi ini mengukur waktu pengerjaan, bukan tingkat pemahaman kode. METR kemudian menyebut hasil tersebut sudah usang dan pada Februari 2026 menyatakan akan meninjau ulang rancangan eksperimennya.
Penelitian yang diterbitkan Anthropic pada Januari 2026 melibatkan 52 insinyur yang mempelajari pustaka Python “Trio” (kebanyakan merupakan pengembang yang belum berpengalaman). Dalam kuis setelahnya, kelompok yang mendapat bantuan AI meraih nilai rata-rata 50%, sedangkan kelompok yang menulis kode sendiri memperoleh 67%; perbedaannya dinyatakan signifikan secara statistik. Kelompok AI menyelesaikan tugas sekitar 2 menit lebih cepat, tetapi selisih waktu itu tidak signifikan. Di sisi lain, penggunaan AI dengan meminta penjelasan atau mengajukan pertanyaan lanjutan berkaitan dengan hasil belajar yang lebih baik. Jadi, cara menggunakan AI tampaknya lebih menentukan daripada sekadar menggunakannya. Perlu dicatat pula bahwa penulis menyatakan ia biasa menggunakan Claude dan juga memakainya untuk membuat artikel ini.
“Latihan”, modal yang terkikis oleh otomatisasi
Penulis juga merujuk pada karya klasik. Pada 1983, Lisanne Bainbridge berpendapat dalam makalah “Ironies of Automation” bahwa semakin maju otomatisasi, semakin sedikit kesempatan manusia untuk berlatih, dan kekurangan itu akan terasa ketika manusia harus mengambil alih saat terjadi hal yang tidak normal. Hubungan antara autopilot pesawat dan keterampilan pilot menjadi contoh yang khas.
Pada 1985, Peter Naur menyatakan dalam “Programming as Theory Building” bahwa pemrograman bukan sekadar menulis kode, melainkan juga membangun pemahaman (teori) tentang cara kerja perangkat lunak. Dalam alur kerja ketika agen menulis dan manusia hanya menyetujui, seberapa banyak pemahaman itu yang benar-benar tersimpan pada manusia? Hal ini juga berkaitan dengan pertanyaan tentang “vibe coding” yang dibicarakan Andrej Karpathy pada Februari 2025—gaya kerja yang menerima keluaran tanpa banyak membacanya. Gaya ini mungkin terasa praktis untuk proyek akhir pekan yang hanya akan dipakai sekali, tetapi bagaimana jika perangkat lunak itu perlu dipelihara?
Latihan sederhana yang bisa dilakukan mulai hari ini
Latihan dengan gagasan serupa bisa dilakukan tanpa memasang versi lengkapnya. Pilih satu potongan kecil kode yang ditulis AI, lalu catat penilaian diri dengan skala lima poin untuk pertanyaan, “Jika ini rusak malam ini, bisakah saya memperbaikinya?” Berikutnya, minta AI di sesi terpisah mengubah satu perilaku saja, tanpa melihat perbedaannya. Nyalakan timer, tutup sesi AI, lalu coba perbaiki masalah hanya berdasarkan laporan gejalanya. Sebelum memeriksa jawabannya, tuliskan penyebab masalah dengan kata-kata sendiri. Terakhir, bandingkan hasilnya dengan penilaian awal.
Ada kalanya kita tidak menemukan masalah meski merasa yakin, dan ada kalanya kita bisa memperbaikinya lebih cepat dari perkiraan. Keduanya adalah hal yang tidak akan diketahui hanya dari melihat bahwa semua tes lulus. Jika ingin mencoba versi lengkapnya, tersedia petunjuk untuk menjalankan uji mandiri di repositori, lalu menjalankan perintah freeze dan pilot.
Pelajaran yang disampaikan penulis ada empat. Nilai kemampuan diri sebelum mulai. Pahami bahwa lolos tes tidak sama dengan mampu memperbaiki kode. Berlatihlah sebelum sesuatu benar-benar rusak. Lalu, minta AI menjelaskan kodenya. Penelitian Anthropic juga menyebutkan bahwa peserta yang meminta penjelasan atau mengajukan pertanyaan tambahan mendapat hasil lebih baik. Namun, para penulis menyatakan bahwa temuan ini menunjukkan korelasi, bukan hubungan sebab-akibat.
Perubahan pada V0.2
Penulis mengatakan akan membuat empat perubahan pada versi berikutnya. Pertama, menambahkan opsi yang mencatat dengan tepat bahwa pengguna “menyerah”. Jawaban pengguna dan hasil pemeriksaan objektif akan ditampilkan berdampingan, sehingga pengguna tidak dipaksa memilih antara “berhasil memperbaiki” dan “waktu habis”. Kedua, debugging akan dilakukan setelah jeda agar kelelahan akibat pekerjaan persiapan tidak memengaruhi hasil. Ketiga, kembali ke rencana awal untuk menggunakan agen yang dapat berjalan di dalam folder proyek dan menjalankan tes sendiri. Keempat, meminta pengembang lain mencoba prosedur yang sama. Hasil dari satu orang saja tidak cukup untuk mengetahui sejauh mana alat ini berguna bagi orang lain.
コメント