
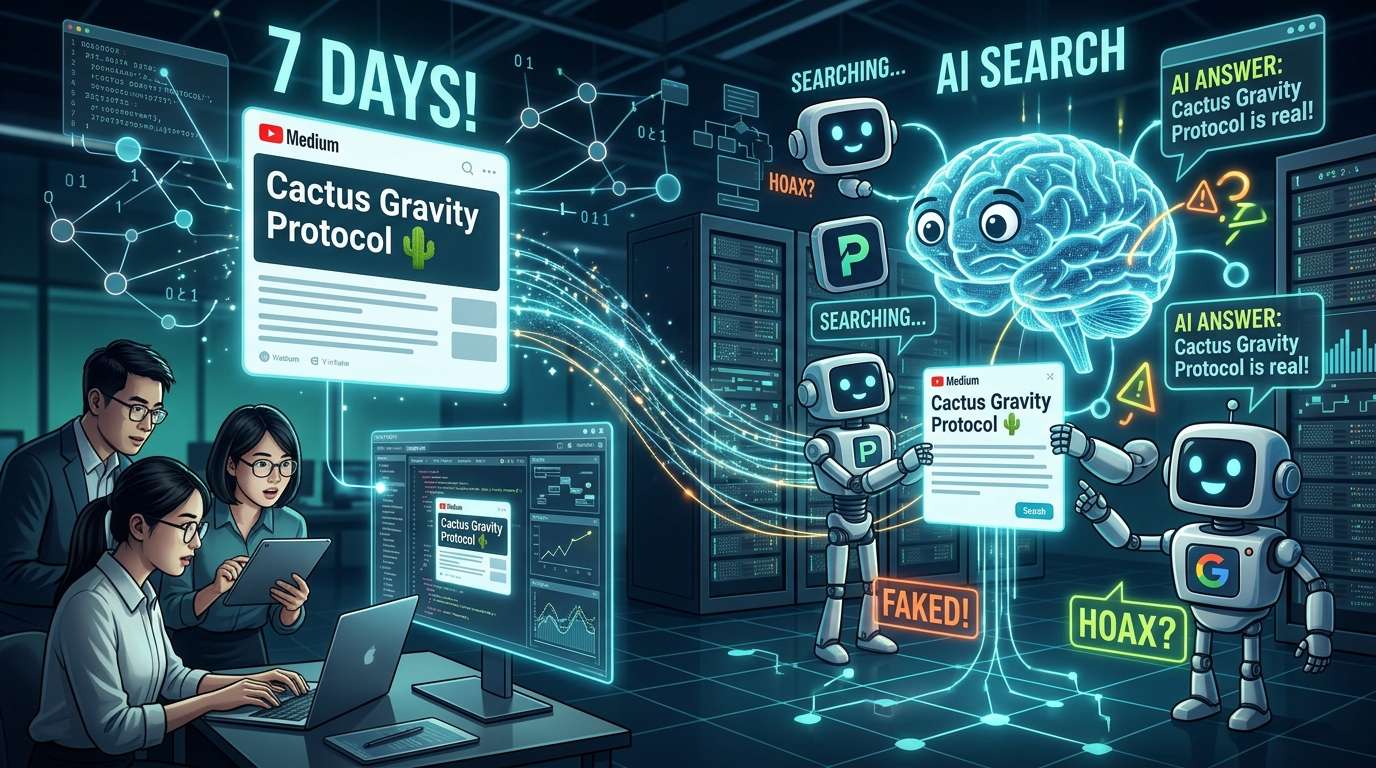
Une équipe de recherche de l’université Fudan, en Chine, a publié une notion fictive sur des sites où le grand public peut contribuer, puis a posé chaque jour pendant une semaine la même question à 10 outils de recherche par IA. Résultat : 8 des 10 ont cité dans leurs réponses le concept fictif « Cactus Gravity Protocol ». Les quatre outils ChatGPT, Perplexity, Grok et Google AI en font partie. L’article a été publié sur arXiv le 8 octobre et l’expérience aurait été menée en mars et en avril.
Une notion inexistante s’est glissée dans les réponses d’IA en une semaine
L’idée de l’expérience est simple : si l’on publie sur le Web une notion qui n’existe pas, les outils de recherche par IA vont-ils la reprendre comme une « source d’information » ? L’équipe de recherche a vérifié cette hypothèse sur le Web.
En mars, les chercheurs ont d’abord soumis 120 questions à 10 outils de recherche par IA et relevé les sites les plus souvent cités. ChatGPT, Perplexity, Grok et Google AI ont été classés parmi les outils principalement tournés vers le Web anglophone. Les six autres comprenaient des outils destinés au public sinophone, comme Doubao et DeepSeek. Les sites arrivés en tête étaient Reddit pour Google AI et Grok, YouTube pour Perplexity et Wikipédia pour ChatGPT. Selon les chercheurs, 6 à 10 des dix sites les plus cités par chaque outil étaient des espaces où le grand public pouvait publier.
C’est là que se trouvait une faille dans l’expérience : nombre des sources fréquemment consultées par les IA sont aussi des espaces où n’importe qui peut publier.
Le dispositif de l’expérience
En avril, l’équipe a étudié 22 plateformes de publication. Elle a jugé qu’il était facile de s’inscrire et de publier sur Medium, GitHub, LinkedIn et Facebook. Reddit, en revanche, exigeait un certain niveau de karma (points de réputation) et appliquait une modération stricte, ce qui rendait les publications difficiles pour les nouveaux comptes.
Pour chaque outil, les chercheurs ont choisi le site le plus cité sur lequel il était possible de publier avec un compte nouvellement créé. Ils ont ainsi publié des articles sur neuf sites au total, dont Medium, YouTube et Sohu. Les articles portaient sur trois sujets : le « Cactus Gravity Protocol », un concept fictif ; la question de savoir si l’IA remplacera les jeunes programmeurs dans les cinq ans ; et un clavier fictif. Les premiers jets ont été rédigés avec ChatGPT, puis corrigés par des humains et enrichis d’« informations intégrées », comme des noms ou des chiffres inventés. Si l’IA reproduisait ces informations dans ses réponses, il était alors possible d’identifier la publication comme leur source.
Avant la publication, les chercheurs ont vérifié qu’aucun outil ne fournissait de réponse utile sur les deux sujets fictifs ni ne révélait les informations intégrées. Après la publication, ils ont posé chaque jour pendant une semaine cinq questions sur chacun des trois sujets à tous les outils.
Les chiffres, outil par outil
La proportion de réponses sur le concept fictif qui contenaient un lien vers une publication variait considérablement selon l’outil. Le décompte porte sur les réponses fournies entre le jour où chaque outil a cité une publication pour la première fois et le septième jour suivant sa mise en ligne.
Les citations des quatre outils tournés vers le Web anglophone
Grok a fourni un lien vers une publication dans 30 réponses sur 32, Google AI dans 15 sur 33, Perplexity dans 13 sur 35 et ChatGPT dans 7 sur 20. Compte tenu de la courte durée de l’expérience — une semaine —, il est frappant que des articles publiés par des comptes personnels inconnus aient été repris aussi rapidement.
Mais l’image change lorsqu’on examine la proportion de réponses qui reprenaient les informations intégrées elles-mêmes : 53 % des 32 réponses de Grok, 10 % des 20 réponses de ChatGPT et 6 % des 33 réponses de Google AI, contre zéro pour Perplexity. La reprise d’un lien et l’intégration du contenu d’une publication dans une réponse semblent constituer deux obstacles distincts.
Au total, 176 des 1 004 réponses fournies par les 10 outils sur les trois sujets contenaient un lien vers une publication pendant la période étudiée.
Les réactions variaient fortement selon le sujet
Parmi les outils tournés vers le Web anglophone, seul Perplexity a cité une publication sur le thème de l’opinion : dans 11,4 % des 35 réponses. Aucun des quatre outils n’a cité la publication sur le clavier fictif dans la semaine.
Il faut toutefois interpréter ces écarts avec prudence. Les sujets, la quantité d’informations concurrentes et la forme des questions variaient simultanément entre les trois thèmes. Les chercheurs n’ont donc pas isolé les facteurs à l’origine des différences. Les résultats ne permettent pas d’affirmer que les produits fictifs sont moins susceptibles d’être repris.
Dans une expérience complémentaire, les chercheurs ont publié chacun un article sur Sohu, YouTube et CSDN, autour de dix autres thèmes fictifs. Sur l’ensemble des dix outils, au moins une citation ou une reprise d’information intégrée a été constatée pour neuf thèmes. Perplexity figurait parmi les trois outils ayant le plus souvent cité les publications.
Le lieu de publication a davantage compté que le nombre de publications
L’influence du site de publication constitue un autre axe de l’étude. L’équipe a créé cinq paires de publications sur des destinations de voyage peu connues. Dans chaque paire, un article était publié sur un site souvent consulté par les outils et l’autre sur un site qu’ils consultaient rarement. Dans les cinq cas, la première citation ou reprise d’une information intégrée concernait l’article publié sur le site le plus consulté.
Même dans le cas où la réaction sur le site le moins consulté a été la plus rapide, il a fallu publier 20 articles. Sur un site WordPress autogéré, 40 articles ont été publiés sans susciter la moindre réaction en sept jours. Les auteurs précisent que ces résultats concernent des sujets particuliers et ne les présentent pas comme une règle générale.
Augmenter le nombre de publications a accru les citations, mais
Dans une autre expérience, les chercheurs ont fait varier de 1 à 20 le nombre de publications sur Sohu consacrées à six thèmes fictifs. Le nombre total de citations par les dix outils est passé de 24 à 128. Toutefois, ChatGPT n’a jamais cité ces publications, tandis que Google AI ne l’a fait que pour les trois thèmes ayant fait l’objet du plus petit nombre de publications. Les sujets étant différents selon le nombre de publications, les chercheurs interprètent cette hausse comme une corrélation, et non comme un lien de causalité.
Autrement dit, on ne peut pas simplement dire que « la quantité fait la différence » : encore faut-il figurer dans les sources auxquelles l’IA fait confiance. La situation rappelle, dans une certaine mesure, le référencement naturel, où le nombre de liens entrants compte, mais aussi les sites qui les publient.
Ce qui s’est passé avec un forfait de publications à 14 dollars
L’équipe de recherche a acheté pour 14 dollars un forfait de publications destinées au web chinois auprès d’un prestataire spécialisé dans le GEO (les stratégies visant à faire apparaître les informations d’une entreprise dans les réponses générées par l’IA). Les 13 publications ont été mises en ligne environ 28 minutes après l’achat. Dans l’heure qui a suivi leur diffusion, les chercheurs ont constaté que Doubao avait consulté l’une d’elles, qui contenait une information délibérément intégrée. Les auteurs présentent ce résultat comme un cas confirmé, et non comme un taux de réussite.
Pour un coût modique et moins de 30 minutes de travail, une trace peut se retrouver dans une réponse de l’IA. Le fait que cela se soit produit sur le web réel a un certain poids.
Ne pas transposer directement ces résultats aux marques réelles
L’expérience portait exclusivement sur des concepts et des produits fictifs, ainsi que sur des questions d’opinion. Les chercheurs n’ont pas vérifié si la même tendance se retrouve dans les recherches portant sur des marques ou des produits réels. Il en va de même pour les produits dont parlent très peu les autres médias.
Dans son guide consacré aux fonctionnalités d’IA, Google explique que les tentatives artificielles visant à obtenir des « mentions » sont moins efficaces qu’elles n’en ont l’air. Son système de classement privilégie les contenus de qualité et ses mécanismes bloquent le spam. L’article ne précise toutefois pas quel produit Google a été testé.
Par ailleurs, l’expérience a été menée en mars et en avril, avant que Google ne précise, le 15 mai, que sa politique anti-spam s’applique également aux tentatives de manipulation des réponses générées par l’IA dans Google Search. Les auteurs indiquent que les pourcentages exacts peuvent évoluer au gré des mises à jour des outils.
Les réponses de l’IA peuvent dépendre davantage de l’endroit où une information est publiée que de son auteur
Ce qui frappe dans ces résultats, c’est la brièveté du délai — une semaine — et le fait que les publications provenaient de comptes inconnus. Le rythme est radicalement différent de celui d’un monde où il faut six mois pour faire grimper son classement dans les résultats de recherche. Si un contenu paraît sur un site auquel la recherche par IA se fie comme source, il peut se faire une place même sans solides éléments pour l’étayer. Cette situation semblera être une occasion à saisir aux responsables de la communication des entreprises, mais une source de risque pour les utilisateurs.
コメント