
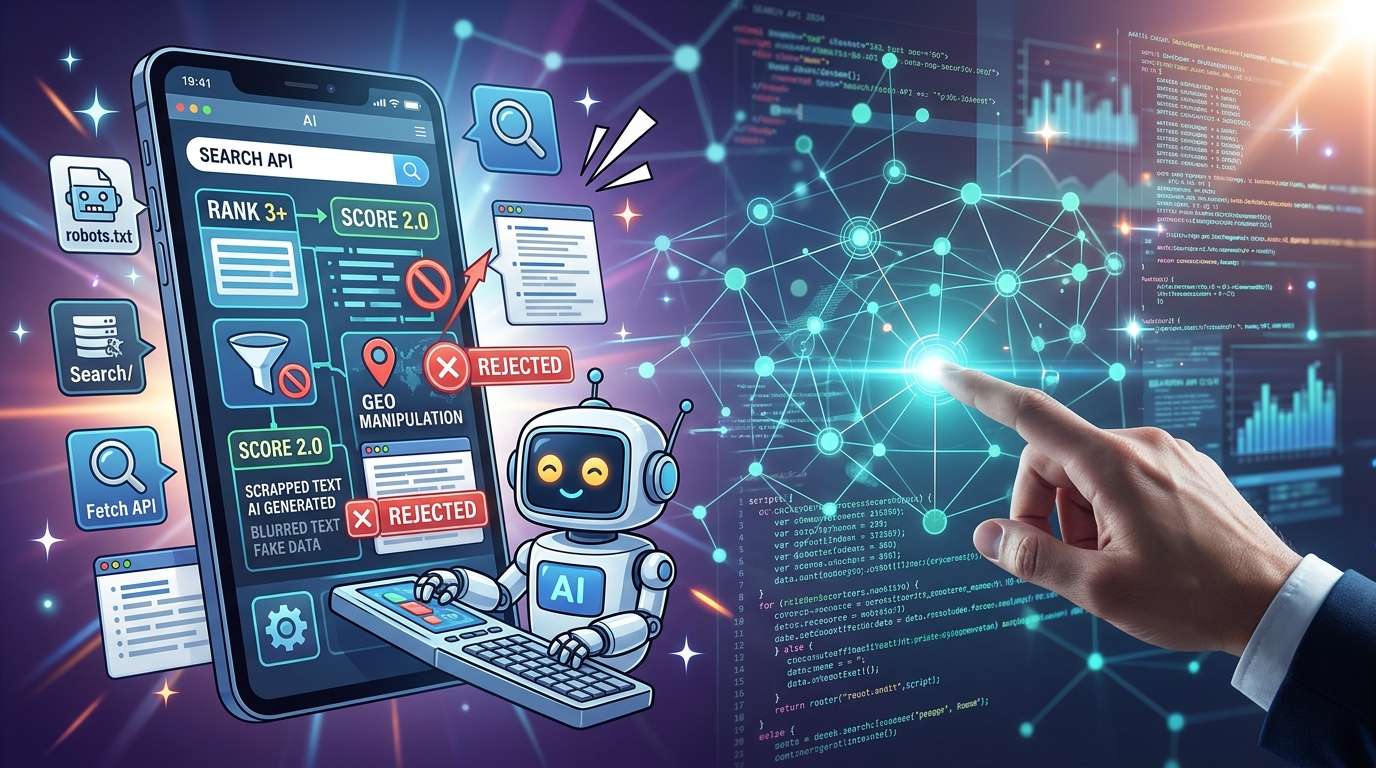
Le 17 octobre, l’entreprise chinoise spécialisée dans l’IA DeepSeek a mis à disposition des développeurs, sous la forme d’une API, le moteur de recherche qu’elle exploite elle-même. Chaque résultat est assorti d’un niveau indiquant l’autorité de la page et d’un score de pertinence par rapport à la requête. DeepSeek affirme exclure le spam SEO, les manipulations GEO et les contenus générés par IA de faible qualité.
À l’aube d’une ère où les résultats de recherche sont notés
La Search API qui vient d’être publiée est une sorte de brique de moteur de recherche : on lui soumet des mots-clés et elle renvoie des résultats de recherche sur le Web. Selon DeepSeek, ce moteur alimente déjà la recherche sur son site et via ses API. Il gère un index de plusieurs centaines de milliards de pages et des centaines de millions de requêtes de recherche quotidiennes en provenance du monde entier.
C’est le contenu des résultats qui retient l’attention. Chaque page se voit attribuer un niveau d’autorité de 0 à 4 ; si celui-ci ne peut être déterminé, la valeur « -1 » est utilisée. À partir de 3, la source est considérée comme faisant autorité. Un score de pertinence compris entre 0 et 3 est également attribué. Il tient compte de la correspondance avec la requête, mais aussi de l’autorité et de la fraîcheur de la page. Un score d’au moins 1,5 serait un indicateur de qualité élevée.
En somme, un « indicateur de fiabilité » est ajouté d’emblée aux résultats de recherche. Le moteur prend ainsi en charge une partie du choix des sources dont l’IA se servira pour construire sa réponse.
Des données conçues pour être lues par l’IA
Les données renvoyées ne sont pas conçues uniquement pour être affichées à l’écran à l’intention des humains. Le court extrait destiné à l’affichage compte environ 100 à 200 caractères, tandis que le résumé destiné à être lu par un modèle en compte environ 600 à 800. Le contenu intégral d’une page peut aussi être récupéré sur demande. Il est également possible de restreindre la recherche à un domaine avec site:, ou de la filtrer par langue et par date de publication.
Search et Fetch coûtent chacun 0,75 dollar pour 1 000 requêtes réussies. Les recherches sans résultat ne sont pas facturées, et le prix est le même que l’on demande 50 résultats ou un seul. Une recherche site: revient donc à moins d’un centime par requête.
Par ailleurs, si vous utilisez l’API DeepSeek depuis Claude Code, Codex ou DeepSeek Harness, la recherche et la récupération de pages côté serveur sont déjà prises en charge via ces API et sont gratuites pour le moment. La facturation devrait commencer le 31 octobre à 16 h (UTC).
La promesse d’écarter les manipulations GEO
Autre point notable : les contenus visés par les filtres. Dans son journal des modifications, DeepSeek indique filtrer le spam SEO, les manipulations GEO et les contenus générés par IA de faible qualité. Le GEO désigne les pratiques consistant à adapter un contenu afin qu’il soit plus susceptible d’être cité dans les réponses de l’IA. Pour le dire simplement, c’est l’équivalent du SEO, qui vise à améliorer le classement dans les moteurs de recherche, pour l’IA.
Le fait qu’un moteur de recherche mentionne explicitement l’optimisation pour l’IA parmi les pratiques surveillées est symbolique. Le 15 mai, Google a également déclaré que ses règles anti-spam s’appliquaient aux réponses générées par l’IA dans la recherche Google. À mesure que les réponses de l’IA deviennent un nouveau « lieu de visibilité », les tentatives de manipulation et les efforts pour les contrer apparaissent au grand jour.
Toutefois, les documents publiés ne précisent pas ce que recouvrent concrètement les manipulations GEO, comment elles sont détectées, ni comment sont déterminés les niveaux d’autorité et les scores de pertinence. L’existence de critères d’évaluation est désormais connue, mais il faudra attendre de nouvelles publications pour en savoir plus sur leur conception.
Ce que les gestionnaires de sites peuvent voir
Pour les gestionnaires de sites, l’intérêt pratique est de pouvoir vérifier par eux-mêmes comment leur site apparaît dans les recherches de DeepSeek. Avec une recherche site:, ils peuvent récupérer jusqu’à 50 pages de leur site et consulter, pour chacune, son niveau d’autorité et son score de pertinence. Le coût, inférieur à un centime par requête, rend l’essai abordable.
En revanche, il est impossible de savoir pourquoi un résultat attendu n’apparaît pas. La page est-elle hors de l’index ? A-t-elle été bloquée par un filtre ? A-t-elle été exclue pour une autre raison ? Ni le guide de l’utilisateur ni la référence de l’API ne proposent de moyen de distinguer ces cas.
L’identité du robot d’exploration reste une question en suspens
La gestion de l’exploration du Web soulève une autre question. L’API Fetch permet de récupérer une page au format Markdown ; le guide précise qu’elle respecte la disponibilité et les règles d’accès du site concerné. Un document de synthèse destiné à l’UE sur les données d’entraînement de DeepSeek-V4 indique que les robots d’exploration sont conçus pour respecter les protocoles standards, tels que robots.txt, mais ne précise pas de quel robot il s’agit.
Ni le guide publié au lancement, ni la référence de l’API, le journal des modifications ou l’annonce ne donnent le nom du robot d’exploration de l’index de recherche ou l’agent utilisateur déclaré par Fetch. Le répertoire Known Agents, qui recense les informations sur les robots d’exploration, mentionne DeepSeekBot et le décrit comme étant destiné aux données d’entraînement de l’IA. Les pages publiques ne permettent pas de savoir si le fait de bloquer DeepSeekBot dans robots.txt affecte également l’inclusion d’un site dans l’index de recherche.
Entre commodité et manque de visibilité
Cette publication ajoute un moyen de vérifier par des chiffres la visibilité dans la recherche par IA. Mais tant que les critères qui fondent les scores restent opaques, il est difficile de décider des mesures à prendre en se contentant de consulter ces chiffres.
Il faudra suivre la manière dont la documentation de DeepSeek précisera la définition des manipulations GEO, les critères de classement et le nom du robot d’indexation. L’utilité concrète de l’API et la transparence de ses critères d’évaluation pourraient bien déterminer si ces deux éléments s’imposent comme de nouveaux repères pour évaluer la recherche par IA.
コメント