
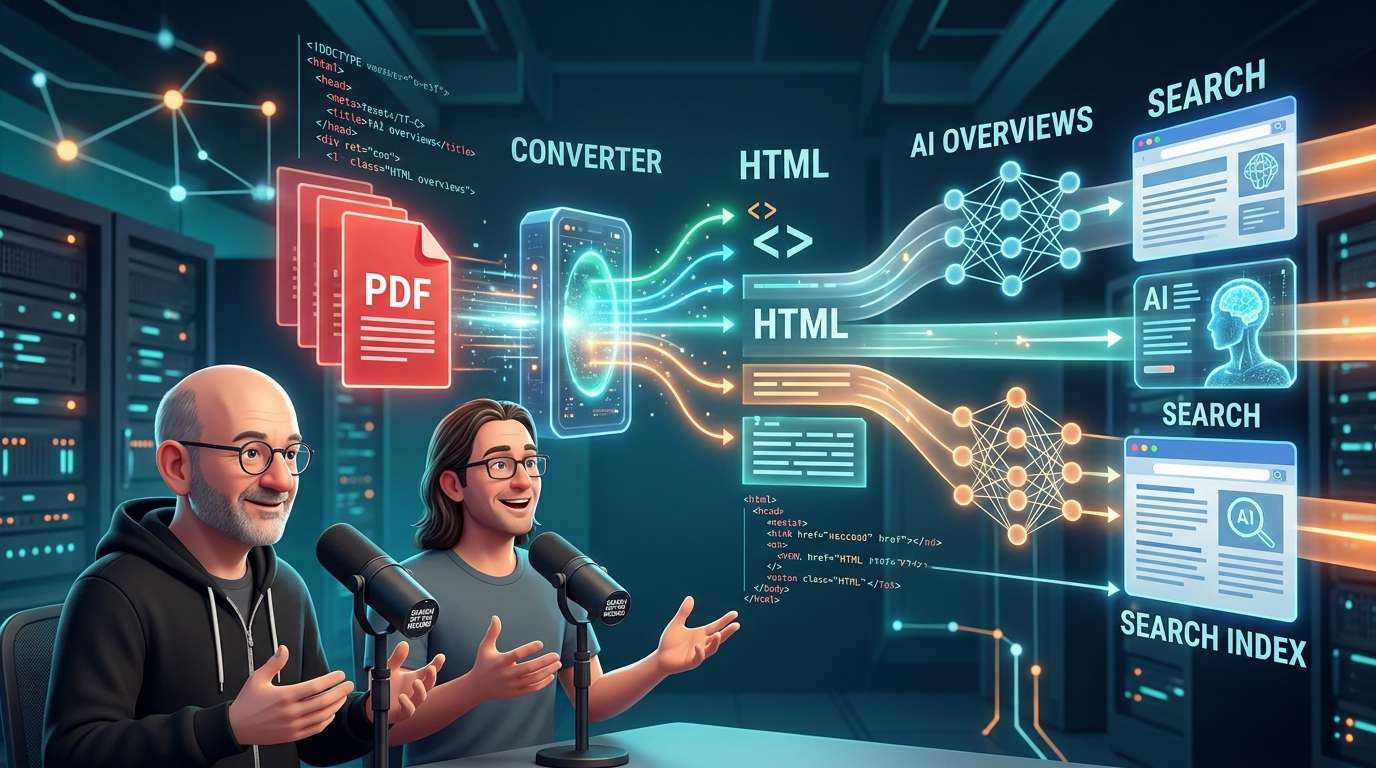
John Mueller et Martin Splitt, de Google, ont expliqué le traitement des PDF dans le podcast de l’entreprise. Pour les recherches, Google convertit les PDF en HTML à l’aide d’une fonctionnalité dédiée, puis utilise cette version HTML pour l’indexation. Les liens présents dans les PDF sont également reconnus après conversion. Selon eux, les documents peuvent apparaître dans les résultats de recherche classiques, mais aussi dans AI Overviews et AI Mode.
Les PDF ne sont pas des fichiers exclus de la recherche
Vous avez sans doute déjà entendu dire que « les PDF sont mauvais pour le SEO ». Les explications fournies cette fois-ci invitent à nuancer quelque peu cette idée.
D’après Martin Splitt, le système de recherche comprend un composant appelé convertisseur. Celui-ci intervient juste après le rendu, avant que le document soit retenu ou non pour l’indexation, et oriente le traitement selon le format du fichier. Les formats pris en charge sont variés — texte enrichi, documents, fichiers Excel, entre autres — et comprennent notamment un convertisseur pour les PDF.
Le résultat de la conversion étant du HTML, les étapes suivantes ne traitent pratiquement que ce format. Il ne s’agit pas d’ouvrir le document dans un lecteur PDF pour en examiner le contenu : on peut plutôt imaginer qu’il est ramené sur le même terrain qu’une page web.
Pourquoi les liens fonctionnent
Le fait que les liens intégrés dans un PDF fonctionnent comme des liens ordinaires s’explique par le même mécanisme. Martin Splitt a indiqué que la conversion en HTML, aussi fidèle que possible au format d’origine, permettait de récupérer des éléments tels que les liens. John Mueller a ajouté que, puisque Google transforme les PDF en une forme proche des pages web qu’il sait traiter, les liens restent utilisables.
Pour les entreprises qui diffusent des documents ou des pages d’information au format PDF, cela signifie que les liens qui y renvoient vers leur site ne sont pas nécessairement perdus.
Les PDF apparaissent dans la recherche classique comme dans les modes d’IA
Le mécanisme de conversion explique aussi pourquoi des PDF peuvent apparaître dans AI Mode. Comme pour la recherche classique, les fichiers sont convertis en HTML puis indexés. Ils peuvent donc également figurer dans AI Overviews et AI Mode. Martin Splitt précise que leur indexation et leur classement sont presque identiques à ceux des autres documents.
En somme, les PDF ne bénéficient pas d’un traitement distinct dans la recherche par IA : s’ils sont intégrés à la base de la recherche, ils peuvent emprunter la même voie d’accès.
Les PDF constitués uniquement d’images présentent un piège
Il faut toutefois garder à l’esprit que tous les PDF ne sont pas lisibles comme du texte. C’est notamment le cas des PDF créés à partir de pages numérisées enregistrées sous forme d’images : ils ressemblent à des documents, mais leur contenu est en réalité constitué d’images.
Le test proposé par Martin Splitt est simple : essayez de sélectionner et de copier du texte dans le PDF, puis de le coller dans un éditeur de texte. Si vous y parvenez, le document peut être converti et utilisé pour le classement. John Mueller a également indiqué que le texte indexable peut être utilisé dans les recherches.
Martin Splitt s’est montré prudent au sujet des images contenues dans les PDF, sans avancer d’explication définitive. Pour les images classiques, le processus de recherche d’images reçoit une URL à traiter, mais les images intégrées dans un PDF ne disposent pas d’URL distincte. Selon l’hypothèse actuelle, elles ne peuvent donc probablement pas être traitées de la même manière que dans la recherche d’images classique. Il a aussi évoqué la possibilité que leur traitement évolue à l’avenir. Concernant la taille maximale des fichiers, il a estimé qu’il devait exister une limite côté récupération, distincte de celle appliquée au HTML, sans toutefois préciser de chiffre.
Pourquoi choisir le PDF, et pourquoi le HTML est plus pratique
Faut-il alors éviter de créer des PDF ? Pour Martin Splitt, la réponse est non, si le contenu le justifie. Il a expliqué que le PDF convenait aux documents dont l’apparence doit être parfaitement maîtrisée à l’impression, ou qui nécessitent des interactions, comme les formulaires. Il a notamment cité l’exemple d’un formulaire PDF pour réserver un hébergement.
Les menus de restaurants ont également été évoqués. De nombreux établissements publient tels quels les PDF préparés par leur imprimeur, et c’est bien mieux que de ne rien mettre en ligne. John Mueller estime lui aussi que, si le choix se résume à publier ou non le menu, mieux vaut le publier en PDF.
En revanche, si le choix se porte sur un PDF ou une page web classique, John Mueller préfère cette dernière, parce qu’elle est plus facile à utiliser. Si le même contenu peut être présenté en HTML, cela simplifie déjà un peu les choses, a-t-il expliqué. Martin Splitt a lui aussi dit privilégier le HTML, plus flexible.
Éviter de compliquer le travail des moteurs de recherche
Ce qui ressort de ces explications, ce n’est pas qu’un PDF serait intrinsèquement avantagé ou désavantagé dans les résultats de recherche. L’essentiel est de réduire autant que possible le chemin qui mène à l’information.
Les PDF passent par une étape supplémentaire de conversion avant d’être intégrés aux résultats de recherche. Si le même contenu peut être proposé en HTML, mieux vaut donc le rendre directement accessible dans un format plus facile à traiter pour les moteurs de recherche comme pour les lecteurs. Le HTML permet de lire la page dès son ouverture et s’affiche généralement sans problème sur smartphone : autant d’atouts qui améliorent aussi le confort des utilisateurs.
Si vous souhaitez faire le point sur les PDF de votre site, commencez par vérifier si leur texte peut être copié. Déterminez ensuite quels contenus pourraient également être proposés en HTML. Cet ordre de vérification constitue un point de départ réaliste.
コメント