
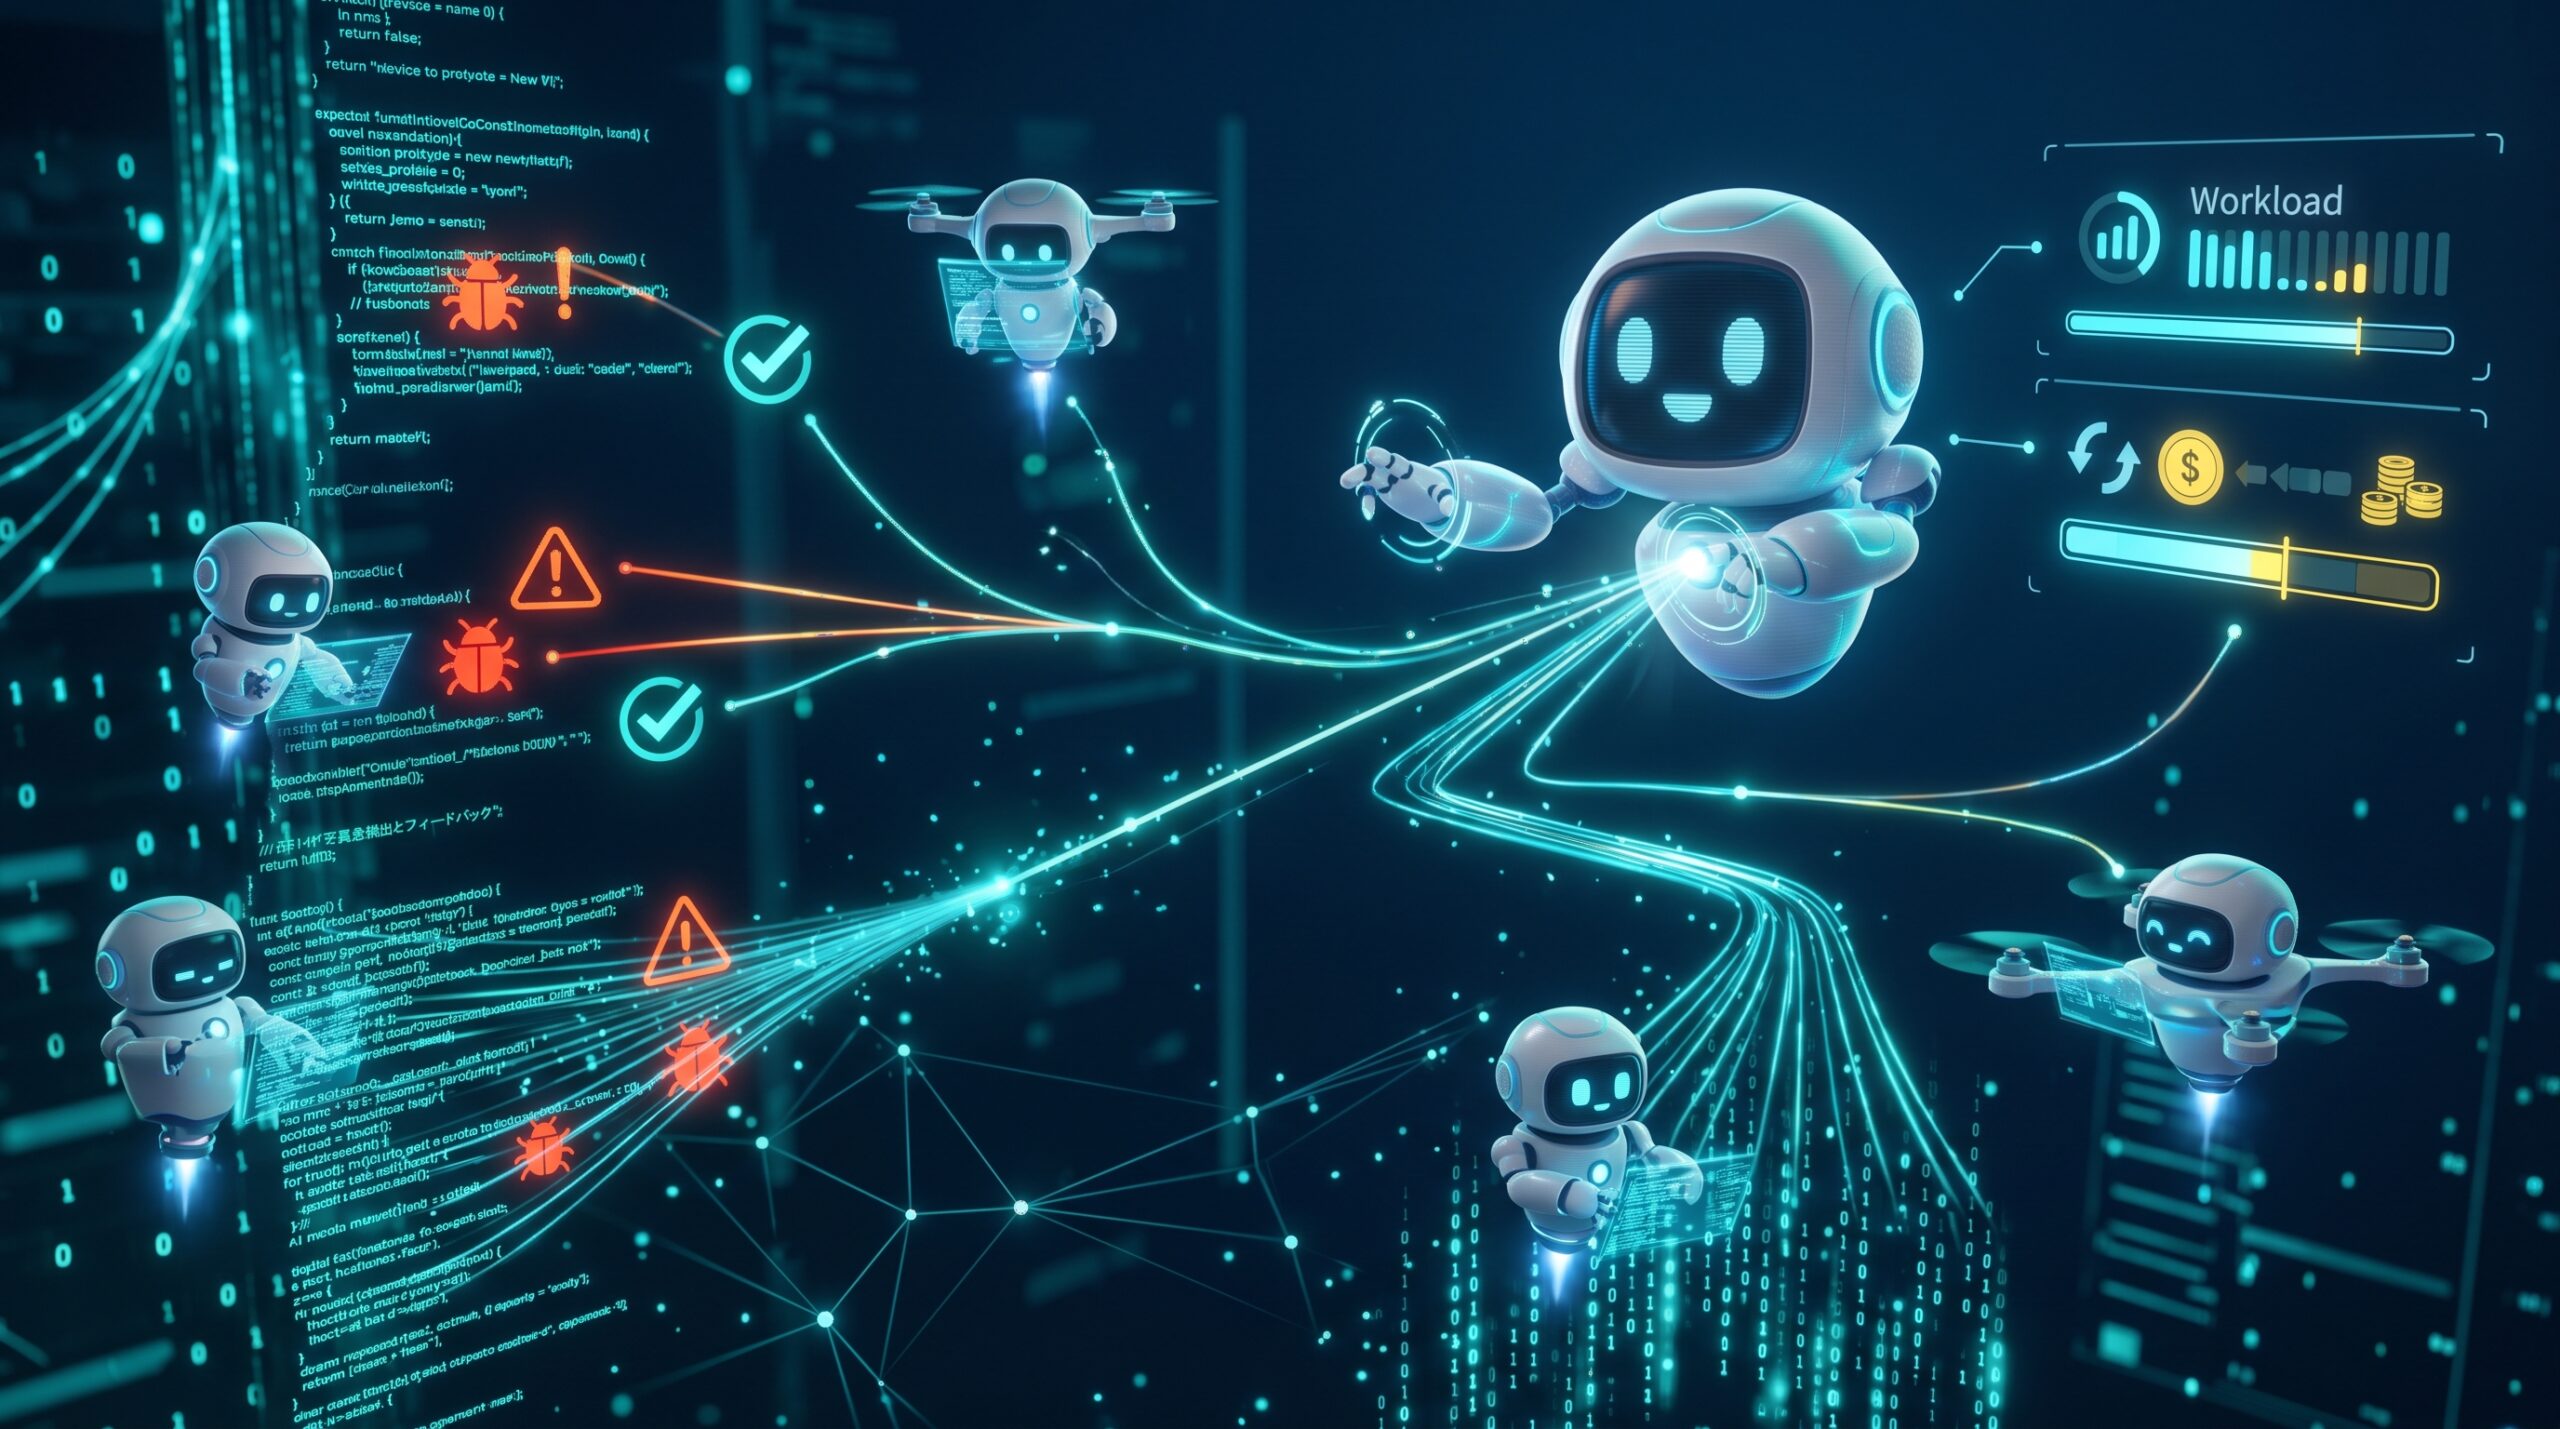
योजना बनाने से लेकर काम बाँटने तक, सब AI के जिम्मे
Anthropic ने AI एजेंटों के निष्पादन प्लेटफ़ॉर्म “Claude Managed Agents” में एक डायनामिक वर्कफ़्लो जोड़ा है, जिसमें कई एजेंटों के बीच काम बाँटा जाता है। नेतृत्व करने वाला एजेंट योजना बनाता है, सब-एजेंटों को काम सौंपता है और उनके नतीजों को एक साथ जोड़ता है। एक बार में अधिकतम 1,000 एजेंट समानांतर रूप से काम कर सकते हैं।
AI एजेंट ऐसा AI है जो दिए गए लक्ष्य को पूरा करने के लिए काम करता है। इस नई सुविधा में सारा काम एक ही एजेंट को सौंपने के बजाय, नेतृत्व करने वाले एजेंट और काम करने वाले एजेंटों की भूमिकाएँ अलग-अलग रखी गई हैं। यानी मौजूदा निष्पादन प्लेटफ़ॉर्म में कई AI को एक साथ चलाने की व्यवस्था जोड़ी गई है।
ध्यान देने वाली बात सिर्फ 1,000 एजेंटों की सीमा नहीं है। काम बाँटने और नतीजों को एकत्र करने की जिम्मेदारी AI को दी गई है। हालांकि, समानांतर रूप से चलाए जा सकने वाले एजेंटों की संख्या का मतलब यह नहीं है कि गति या नतीजे भी उसी अनुपात में बेहतर होंगे।
70 में से 66 बग का पता लगाया
Anthropic के बताए परीक्षण में 116,000 पंक्तियों के कोड में जानबूझकर 70 बग डाले गए और उनका पता लगाने के नतीजों की तुलना की गई। एक अकेले एजेंट ने एक बार के निष्पादन में 14 से 27 बग पाए, जबकि डायनामिक वर्कफ़्लो ने लगातार 66 बग का पता लगाया।
पता लगाने की दर के रूप में देखें तो एक एजेंट ने लगभग 20–39% बग खोजे, जबकि डायनामिक वर्कफ़्लो ने लगभग 94%। इस परीक्षण में कई एजेंटों के बीच काम बाँटने से पाए गए बगों की संख्या बढ़ी। हालांकि, 66 बग मिलने का मतलब यह नहीं कि तैयार किए गए सभी बगों का पता चल गया।
इसके अलावा, यह नतीजा कोड में बग खोजने के एक खास काम से जुड़ा है। यह पुष्टि नहीं की जा सकती कि शोध या दस्तावेज़ तैयार करने जैसे दूसरे कामों में भी ऐसा ही अंतर दिखेगा। उपलब्ध सामग्री में यह भी नहीं बताया गया है कि परीक्षण में वास्तव में कितने एजेंट इस्तेमाल किए गए थे, इसलिए इसे 1,000 एजेंट चलाने का नतीजा मानना जल्दबाज़ी होगी।
अपनाने का पैमाना एजेंटों की संख्या नहीं, बल्कि प्रति नतीजे की लागत
काम बाँटने की एक कीमत यह भी है कि AI को अधिक मात्रा में काम करना पड़ता है। Anthropic ने चेतावनी दी है कि इसमें बड़ी मात्रा में टोकन खर्च हो सकते हैं और छोटे पैमाने से शुरुआत करने की सलाह दी है। टोकन, AI द्वारा संसाधित किए जाने वाले पाठ या कोड की इकाई है और इस्तेमाल की लागत का आकलन करने का एक पैमाना भी।
कंपनियों के लिए अहम सवाल यह है कि कितने AI एजेंट चलाए जा सकते हैं, यह नहीं, बल्कि जरूरी गुणवत्ता का नतीजा कितनी लागत में हासिल किया जा सकता है। भले ही अधिक बग मिलें, लेकिन लागत और जाँच के काम में कितनी बढ़ोतरी होती है, उसके आधार पर इसे अपनाने का फैसला बदल सकता है। व्यावहारिक तरीका यह होगा कि एक अकेले एजेंट और कुछ एजेंटों वाले विभाजित कार्य-प्रवाह की एक ही काम पर तुलना की जाए और मिले बगों की संख्या, लगने वाला समय और लागत मापी जाए।
उपलब्ध सामग्री में इस तुलना-परीक्षण की कुल लागत, प्रक्रिया में लगा समय और टोकन की खपत नहीं बताई गई है। इससे सिर्फ बगों का पता लगाने की संख्या में अंतर की पुष्टि होती है; लागत-लाभ का प्रमाण नहीं मिलता।

コメント