
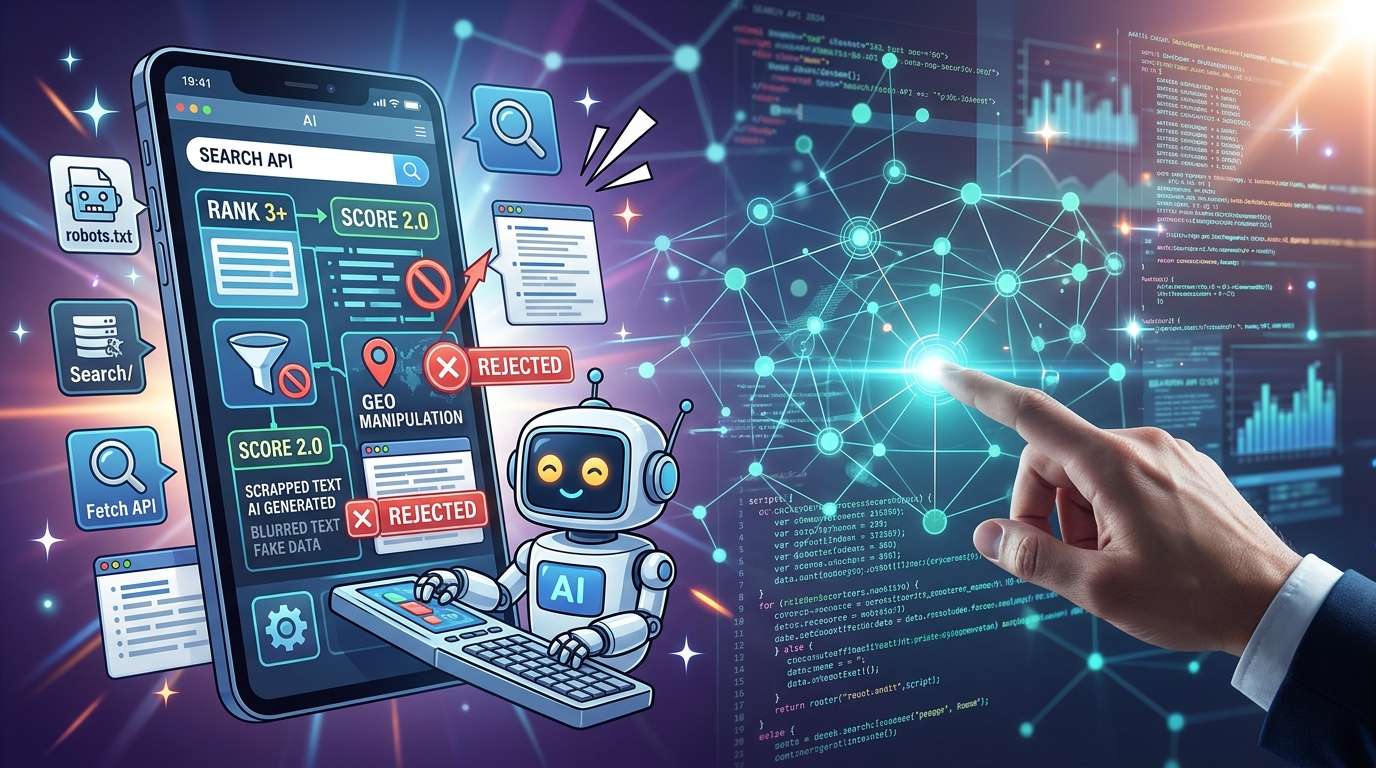
中國 AI 公司 DeepSeek 於 10 月 17 日將自家營運的搜尋引擎以 API 形式開放給開發者使用。每筆搜尋結果都會附上代表頁面權威性的等級,以及顯示與搜尋字詞相關程度的分數。DeepSeek 表示,系統會排除 SEO 垃圾內容、GEO 操弄及低品質的 AI 生成內容。
搜尋結果開始附上評分的時代
這次公開的 Search API,只要輸入關鍵字,就會傳回網頁搜尋結果;說穿了,就是把搜尋引擎的零組件提供給外界使用。DeepSeek 表示,這套引擎已支援其網站和 API 的搜尋,索引規模達數千億個頁面,每天則要處理來自全球數億筆搜尋請求。
引人注目的是搜尋結果的內容。每個頁面都會獲得 0 到 4 的權威性等級;若無法判定,則標示為「-1」。3 以上代表資訊來源具有「高權威性」。此外,頁面還會獲得 0 到 3 的相關性分數,除了搜尋字詞的吻合度,也會納入權威性和新近程度。分數達 1.5 以上,就可視為高品質的參考指標。
換句話說,搜尋結果預先附上了「可信度參考指標」,搜尋引擎等於代替 AI 承擔部分挑選資料的工作,供 AI 組織答案時使用。
以供 AI 閱讀為前提的資料設計
傳回的資料也不只是為人類在畫面上閱讀而設計。供畫面顯示的簡短摘要約為 100 至 200 字元,供模型閱讀的摘要則約為 600 至 800 字元。若提出要求,也能取得頁面內文;此外,還能使用 site: 限定網域,或依語言和發布日期篩選。
Search 和 Fetch 的費用各為每 1,000 次成功請求 0.75 美元。搜尋結果為零時不收費,無論要求 50 筆還是 1 筆,費用都相同。因此,使用 site: 搜尋每次不到 1 美分。
另外,若透過 Claude Code、Codex 或 DeepSeek Harness 使用 DeepSeek API,伺服器端的搜尋和頁面擷取目前已透過這些 API 處理,而且免費。預計自 10 月 31 日 16 時(UTC)起開始收費。
宣稱將排除GEO操弄
另一個值得關注的地方,是 DeepSeek 對排除內容的說明。DeepSeek 的更新紀錄指出,系統會過濾 SEO 垃圾內容、GEO 操弄及低品質的 AI 生成內容。GEO 指的是調整內容,讓自家內容更容易被 AI 的回答引用。簡單來說,可以把它看成是以爭取搜尋排名為目標的 SEO 的 AI 版。
搜尋引擎明確將針對 AI 的最佳化列為監控對象,具有象徵意義。Google 也在 5 月 15 日表示,垃圾內容政策同樣適用於 Google 搜尋中的生成式 AI 回答。AI 回答愈來愈成為新的「曝光管道」,針對這些管道進行操弄,以及防堵操弄的攻防,也就愈來愈浮上檯面。
不過,公開資料並未說明 GEO 操弄具體所指為何、如何偵測,也沒有交代權威性等級和相關性分數的決定方式。目前已知系統確實設有評估指標,但具體設計仍有待日後公開。
網站經營者能看到什麼?
對網站經營者而言,實際好處在於可以自行確認自家網站在 DeepSeek 搜尋中的呈現情況。使用 site: 搜尋,就能取得自家網站最多 50 個頁面,以及各頁面的權威性和相關性。費用每次不到 1 美分,也相當容易嘗試。
另一方面,如果找不到預期的結果,就無從追查原因。是頁面不在索引中、被篩選器攔下,還是因其他原因遭到排除?使用者指南和 API 參考文件都沒有提供釐清原因的方法。
爬蟲身分仍待解答
另一個令人關注的問題,是爬取資料的方式。Fetch API 可將單一頁面以 Markdown 格式傳回,指南指出會遵循目標網站的可用性和存取政策。針對 DeepSeek-V4 訓練資料的歐盟版概要文件提到,爬蟲的設計會遵循 robots.txt 等標準協定,但並未明確指出是哪一種爬蟲。
公開時的指南、API 參考文件、更新紀錄和公告,都沒有提到搜尋索引爬蟲的名稱,也未說明 Fetch 使用的使用者代理程式。整理爬蟲資訊的 Known Agents 目錄中,列有一個說明為用於 AI 訓練資料的 DeepSeekBot。若在 robots.txt 中拒絕 DeepSeekBot,是否也會影響網站列入搜尋索引,從公開頁面上無從得知。
便利與不透明之間
這次公開又多了一種以數字確認內容在 AI 搜尋中呈現情況的方法。不過,在評分依據不透明的情況下,光看數字仍難以決定該採取什麼行動。
值得關注的是,DeepSeek 的文件將如何補充 GEO 操作的定義、階段的判定方式,以及索引用爬蟲的名稱。API 的實用性與判定標準的透明度,這兩者可能是 AI 搜尋評估指標能否確立的關鍵。
コメント