
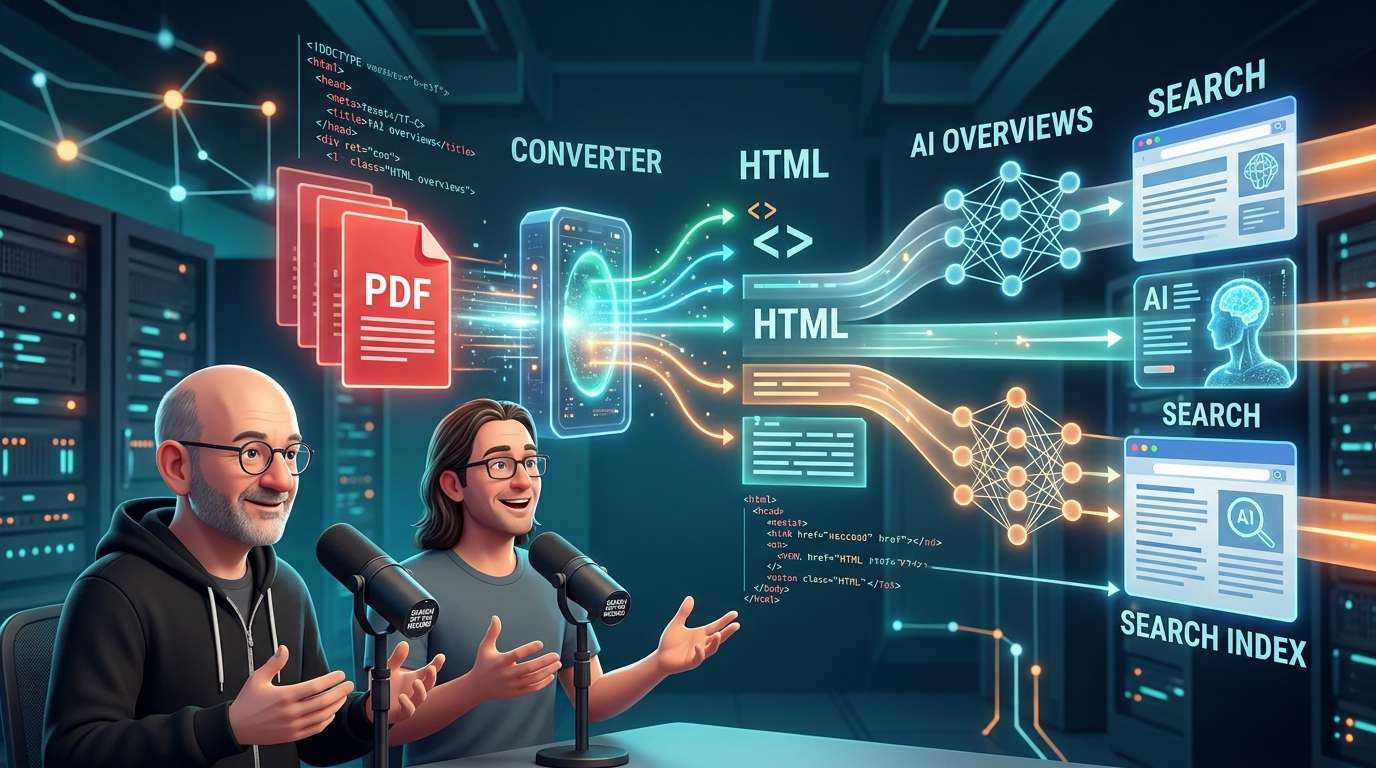
John Mueller dan Martin Splitt dari Google menjelaskan cara kerja penelusuran terhadap PDF dalam podcast perusahaan tersebut. Menurut mereka, Penelusuran mengubah PDF menjadi HTML menggunakan fitur konversi khusus, lalu memakai versi HTML itu untuk pengindeksan. Tautan di dalam PDF juga dikenali setelah dikonversi, sehingga PDF dapat muncul di hasil penelusuran biasa maupun di AI Overviews dan AI Mode.
PDF bukan file yang berada di luar jangkauan Penelusuran
Anda mungkin pernah mendengar anggapan bahwa “PDF merugikan SEO”. Namun, setelah mendengar penjelasan kali ini, kesan tersebut perlu sedikit diperbaiki.
Menurut Splitt, sistem Penelusuran memiliki komponen yang disebut konverter. Komponen ini bekerja tepat setelah proses rendering, sebelum ditentukan apakah konten akan masuk ke indeks, dan mengarahkan pemrosesan berdasarkan format file. Format yang didukung cukup beragam, termasuk rich text, dokumen, dan Excel. Fitur konversi untuk PDF adalah salah satunya.
Hasil konversinya berupa HTML, sehingga tahapan selanjutnya hampir sepenuhnya hanya menangani HTML. Google tidak membuka PDF dengan penampil PDF lalu membaca isinya; lebih tepatnya, PDF diubah agar berada di ranah yang sama dengan halaman web.
Inilah alasan tautan tetap berfungsi
Mekanisme yang sama menjelaskan mengapa tautan yang disematkan dalam PDF berfungsi seperti tautan biasa. Splitt mengatakan PDF diubah menjadi representasi HTML yang sedekat mungkin dengan format aslinya, sehingga elemen seperti tautan juga dapat dikenali. Mueller menambahkan bahwa tautan dapat digunakan karena Google mengubah PDF menjadi format yang mirip dengan halaman web yang sudah biasa ditangani Google.
Bagi perusahaan yang membagikan materi atau halaman informasi dalam bentuk PDF, ini berarti tautan dari PDF ke situs mereka mungkin tidak sia-sia.
Muncul di hasil penelusuran dan AI Mode
Mekanisme konversi tersebut juga menjelaskan mengapa PDF dapat ditampilkan di AI Mode. Seperti pada penelusuran biasa, konten yang diubah menjadi HTML akan diindeks, sehingga dapat muncul di AI Overviews maupun AI Mode. Splitt mengatakan pengindeksan dan pemeringkatannya pada dasarnya diperlakukan sama seperti dokumen lain.
Artinya, PDF tidak diperlakukan secara terpisah dalam penelusuran AI. Selama sudah masuk ke fondasi Penelusuran, PDF dapat melewati jalur yang sama.
PDF yang hanya berisi gambar memiliki kendala
Yang perlu diperhatikan, tidak semua PDF dapat dibaca sebagai teks. Ada kasus ketika dokumen tampak seperti teks, tetapi isinya berupa gambar, misalnya PDF yang hanya menyimpan halaman hasil pemindaian sebagai gambar.
Splitt memberikan cara sederhana untuk memeriksanya: pilih dan salin teks dalam PDF, lalu coba tempelkan ke editor teks. Jika teks dapat ditempelkan, berarti PDF dapat dikonversi dan digunakan untuk pemeringkatan. Mueller juga mengatakan bahwa teks yang dapat diindeks bisa digunakan dalam Penelusuran.
Splitt tidak memberikan penjelasan pasti tentang gambar di dalam PDF. Gambar biasa diproses dengan mengirimkan URL-nya ke tahap penelusuran gambar, tetapi gambar di dalam PDF tidak memiliki URL tersendiri. Karena itu, menurut perkiraan saat ini, gambar tersebut mungkin tidak dapat diproses dengan cara yang sama seperti gambar biasa dalam penelusuran gambar. Ia juga menyebutkan bahwa perlakuan ini mungkin berubah di masa mendatang. Terkait batas ukuran file, ia mengatakan bahwa kemungkinan ada batas pengambilan yang terpisah dari HTML, tetapi tidak menyebutkan angka pastinya.
Alasan memilih PDF dan kemudahan HTML
Jadi, apakah sebaiknya kita tidak membuat PDF? Jawaban Splitt adalah, “Tidak masalah jika memang dibutuhkan oleh kontennya.” Ia mengatakan PDF cocok untuk dokumen yang tampilan cetaknya harus diatur secara presisi atau yang memerlukan interaksi, seperti formulir. Sebagai contoh, ia menyebut formulir PDF untuk pemesanan akomodasi.
Menu restoran juga dibahas. Banyak restoran yang langsung mengunggah PDF buatan perusahaan percetakan, dan menurut mereka, itu jauh lebih baik daripada tidak mengunggahnya sama sekali. Mueller juga mengatakan bahwa jika pilihannya hanya mengunggah menu atau tidak, sebaiknya tetap unggah dalam bentuk PDF.
Namun, jika bisa memilih antara PDF dan halaman web biasa, Mueller lebih menyukai halaman web. Alasannya adalah kemudahan penggunaan. Jika konten yang sama bisa dibuat dalam HTML, hal itu akan membuat semuanya sedikit lebih mudah. Splitt juga menyatakan lebih menyukai HTML yang lebih fleksibel.
Gagasan untuk tidak membebani mesin telusur
Penjelasan kali ini menunjukkan bahwa persoalannya bukan sekadar apakah PDF merugikan atau menguntungkan dalam Penelusuran. Yang penting adalah seberapa pendek jalur untuk menemukan informasi.
PDF masuk ke Penelusuran setelah melalui satu tahap tambahan, yaitu konversi. Karena itu, jika konten yang sama bisa disediakan dalam HTML, pilihan yang lebih aman adalah menyajikannya dalam format yang sejak awal lebih mudah ditangani oleh mesin telusur maupun pembaca. HTML juga mudah dibaca begitu halaman dibuka dan tampilannya cenderung tidak berantakan di ponsel, sehingga lebih nyaman bagi pengguna.
Jika ingin meninjau PDF di situs perusahaan, pertama-tama pastikan apakah teksnya dapat disalin. Setelah itu, tentukan apakah konten tersebut juga bisa disajikan dalam HTML. Urutan ini bisa menjadi langkah awal yang praktis.
コメント