
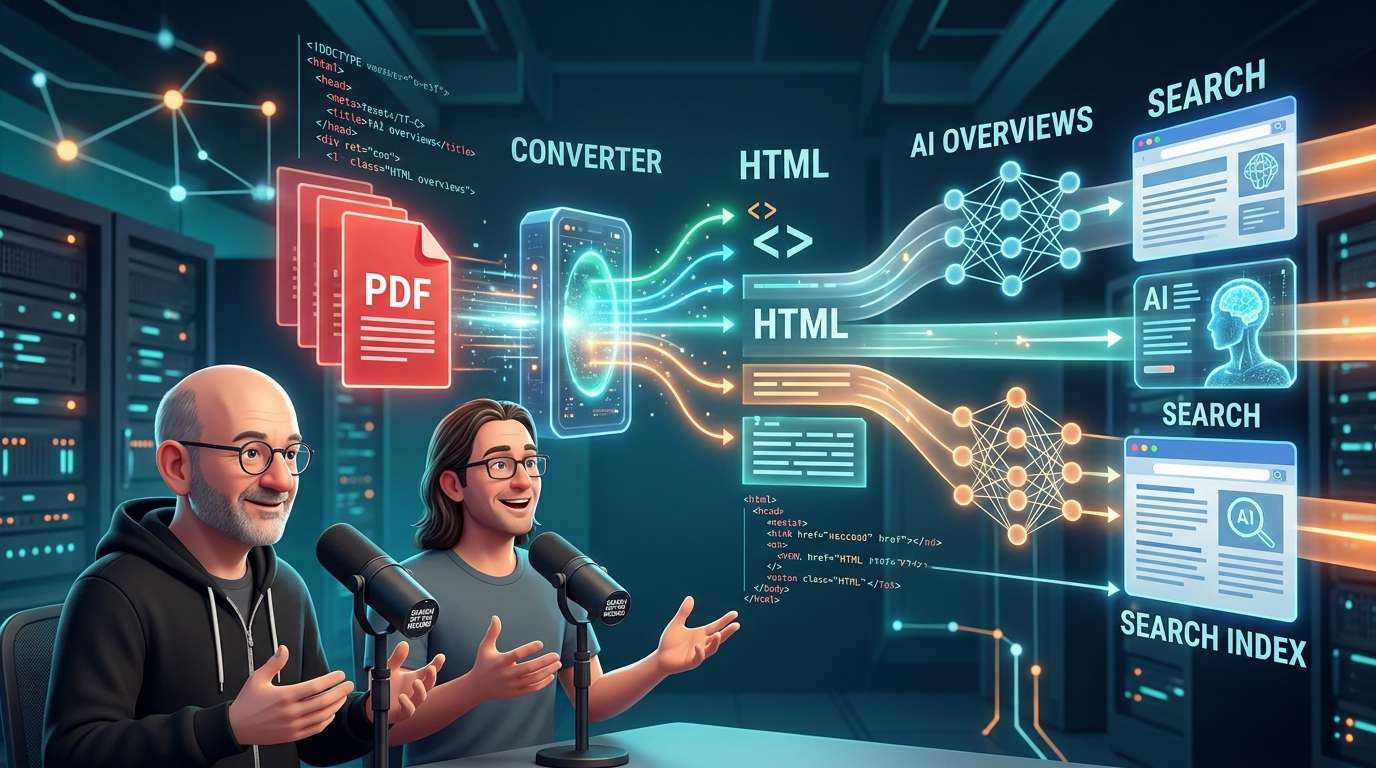
Google के John Mueller और Martin Splitt ने कंपनी के पॉडकास्ट में बताया कि PDF को Search में कैसे प्रोसेस किया जाता है। Search PDF को एक विशेष कन्वर्ज़न फ़ंक्शन के ज़रिए HTML में बदलता है और इंडेक्सिंग के लिए उसी HTML संस्करण का इस्तेमाल करता है। उन्होंने कहा कि PDF के लिंक भी रूपांतरण के बाद पहचाने जाते हैं और सामान्य Search के अलावा AI Overviews तथा AI Mode में भी दिखाई दे सकते हैं।
PDF ऐसी फ़ाइलें नहीं हैं जो Search की पहुंच से बाहर हों
आपने शायद कभी न कभी यह सुना होगा कि “PDF SEO के लिए नुकसानदेह है।” इस बार की व्याख्या सुनने के बाद इस धारणा में थोड़ा बदलाव करना ज़रूरी लगता है।
Splitt के मुताबिक, Search की व्यवस्था में एक घटक होता है जिसे कन्वर्टर कहा जाता है। यह रेंडरिंग के तुरंत बाद और इंडेक्स में शामिल करने का निर्णय होने से पहले काम करता है। यह फ़ाइल का फ़ॉर्मैट देखकर तय करता है कि उसे कैसे प्रोसेस करना है। रिच टेक्स्ट, दस्तावेज़ और Excel समेत कई फ़ॉर्मैट इसके दायरे में आते हैं, और PDF के लिए कन्वर्ज़न फ़ंक्शन भी इनमें से एक है।
रूपांतरण के बाद आउटपुट HTML होता है, इसलिए आगे की प्रक्रिया में लगभग सिर्फ़ HTML को ही संभाला जाता है। इसे PDF व्यूअर में खोलकर उसकी सामग्री को देखने के बजाय, वेब पेज के समान स्तर पर लाने की प्रक्रिया के तौर पर समझा जा सकता है।
लिंक क्यों काम करते हैं
PDF में शामिल लिंक सामान्य लिंक की तरह ही काम करते हैं—इसकी वजह भी यही प्रक्रिया है। Splitt ने बताया कि मूल फ़ॉर्मैट के प्रति यथासंभव वफ़ादार HTML रूप में रूपांतरण किया जाता है, इसलिए लिंक जैसे तत्व भी पहचाने जा सकते हैं। Mueller ने यह भी कहा कि Google इसे ऐसे रूप में बदलता है जो उन वेब पेजों से मिलता-जुलता है जिन्हें वह संभालने का आदी है, इसलिए लिंक भी काम करते हैं।
जो कंपनियां दस्तावेज़ या सूचना पेज PDF के रूप में उपलब्ध कराती हैं, उनके लिए इसका मतलब है कि उनसे अपनी वेबसाइट पर दिए गए लिंक बेकार नहीं जाते।
Search और AI Mode, दोनों में दिखाई दे सकते हैं
PDF, AI Mode में क्यों दिखाई दे सकते हैं, इसकी वजह भी रूपांतरण की प्रक्रिया से समझाई गई। सामान्य Search की तरह ही, HTML में बदली गई सामग्री इंडेक्स की जाती है, इसलिए वह AI Overviews और AI Mode में भी दिखाई दे सकती है। Splitt ने कहा कि इंडेक्सिंग और रैंकिंग में इन्हें लगभग अन्य दस्तावेज़ों की तरह ही माना जाता है।
AI Search में PDF को किसी अलग श्रेणी में नहीं रखा जाता। अगर वह Search की बुनियादी व्यवस्था में शामिल है, तो उसी रास्ते से सामने आ सकता है।
केवल छवियों वाले PDF में एक पेच है
ध्यान देने वाली बात यह है कि हर PDF को टेक्स्ट के रूप में पढ़ा नहीं जा सकता। कुछ PDF में स्कैन किए गए पेज सिर्फ़ छवियों के रूप में सहेजे जाते हैं—वे दिखने में दस्तावेज़ होते हैं, लेकिन उनकी सामग्री छवियों के रूप में होती है।
Splitt ने जांच का एक आसान तरीका बताया: PDF में मौजूद टेक्स्ट को चुनकर कॉपी करें और उसे टेक्स्ट एडिटर में पेस्ट करके देखें। अगर वह पेस्ट हो जाता है, तो इसका मतलब है कि उसे रूपांतरित करके रैंकिंग के लिए इस्तेमाल किया जा सकता है। Mueller ने भी कहा कि इंडेक्स किए जा सकने वाले टेक्स्ट का इस्तेमाल Search में किया जा सकता है।
PDF के भीतर मौजूद छवियों के बारे में Splitt ने कोई पक्का निष्कर्ष देने से परहेज़ किया। सामान्य छवियों को प्रोसेस करने के लिए इमेज सर्च की प्रक्रिया को उनका URL दिया जाता है, लेकिन PDF के भीतर की छवियों का कोई अलग URL नहीं होता। इसलिए उनका आकलन है कि शायद उन्हें सामान्य इमेज सर्च की तरह प्रोसेस नहीं किया जा सकता। उन्होंने यह भी कहा कि भविष्य में यह तरीका बदल सकता है। फ़ाइल के आकार की सीमा के बारे में भी उन्होंने कहा कि HTML से अलग, उसे प्राप्त करने की प्रक्रिया की अपनी सीमा होनी चाहिए, लेकिन कोई ठोस आंकड़ा नहीं दिया।
PDF चुनने की वजहें और HTML की सहूलियत
तो क्या PDF नहीं बनाना चाहिए? Splitt का जवाब था, “अगर सामग्री के लिए ज़रूरी हो, तो कोई समस्या नहीं।” उन्होंने कहा कि प्रिंट में सटीक रूप बनाए रखना हो या फ़ॉर्म जैसी इंटरैक्टिव सुविधाओं वाले दस्तावेज़ की ज़रूरत हो, तो PDF उपयोगी है। उन्होंने ठहरने की जगह की बुकिंग के लिए PDF फ़ॉर्म का उदाहरण भी दिया।
रेस्तरां के मेन्यू का ज़िक्र भी हुआ। कई रेस्तरां प्रिंटिंग कंपनी से बनवाए गए PDF को सीधे वेबसाइट पर डालते हैं, और ऐसा करना कुछ भी न डालने से कहीं बेहतर है। Mueller ने भी कहा कि अगर विकल्प मेन्यू डालने या न डालने के बीच हो, तो PDF के रूप में डालना बेहतर है।
दूसरी ओर, अगर PDF और सामान्य वेब पेज में से चुनना हो, तो Mueller वेब पेज को प्राथमिकता देते हैं। इसकी वजह उसका इस्तेमाल करने में आसानी है। उन्होंने कहा कि अगर उसी सामग्री को HTML में रखा जा सकता है, तो इससे काम थोड़ा आसान हो जाता है। Splitt ने भी अधिक लचीले HTML को प्राथमिकता देने की बात कही।
सर्च इंजन का काम आसान रखने की सोच
इस व्याख्या से यह समझ आता है कि सवाल यह नहीं है कि PDF Search में नुकसानदेह है या फ़ायदेमंद। अहम बात यह है कि जानकारी तक पहुंचने का रास्ता कितना छोटा है।
PDF को Search में शामिल करने से पहले रूपांतरण का एक अतिरिक्त चरण आता है। इसलिए, अगर उसी सामग्री को HTML में उपलब्ध कराया जा सकता है, तो शुरुआत से ही उसे ऐसे रूप में रखना बेहतर है जिसे सर्च इंजन और पाठक आसानी से इस्तेमाल कर सकें। पेज खोलते ही पढ़ा जा सकना और स्मार्टफ़ोन पर उसका लेआउट न बिगड़ना—HTML की ये खूबियां लोगों के लिए भी इसे सुविधाजनक बनाती हैं।
अगर आप अपनी कंपनी की वेबसाइट पर मौजूद PDF की समीक्षा करना चाहते हैं, तो पहले जांचें कि क्या उसमें से टेक्स्ट कॉपी किया जा सकता है। फिर देखें कि क्या उस सामग्री को HTML में भी उपलब्ध कराया जा सकता है। शुरुआत के लिए यह एक व्यावहारिक तरीका हो सकता है।
コメント