
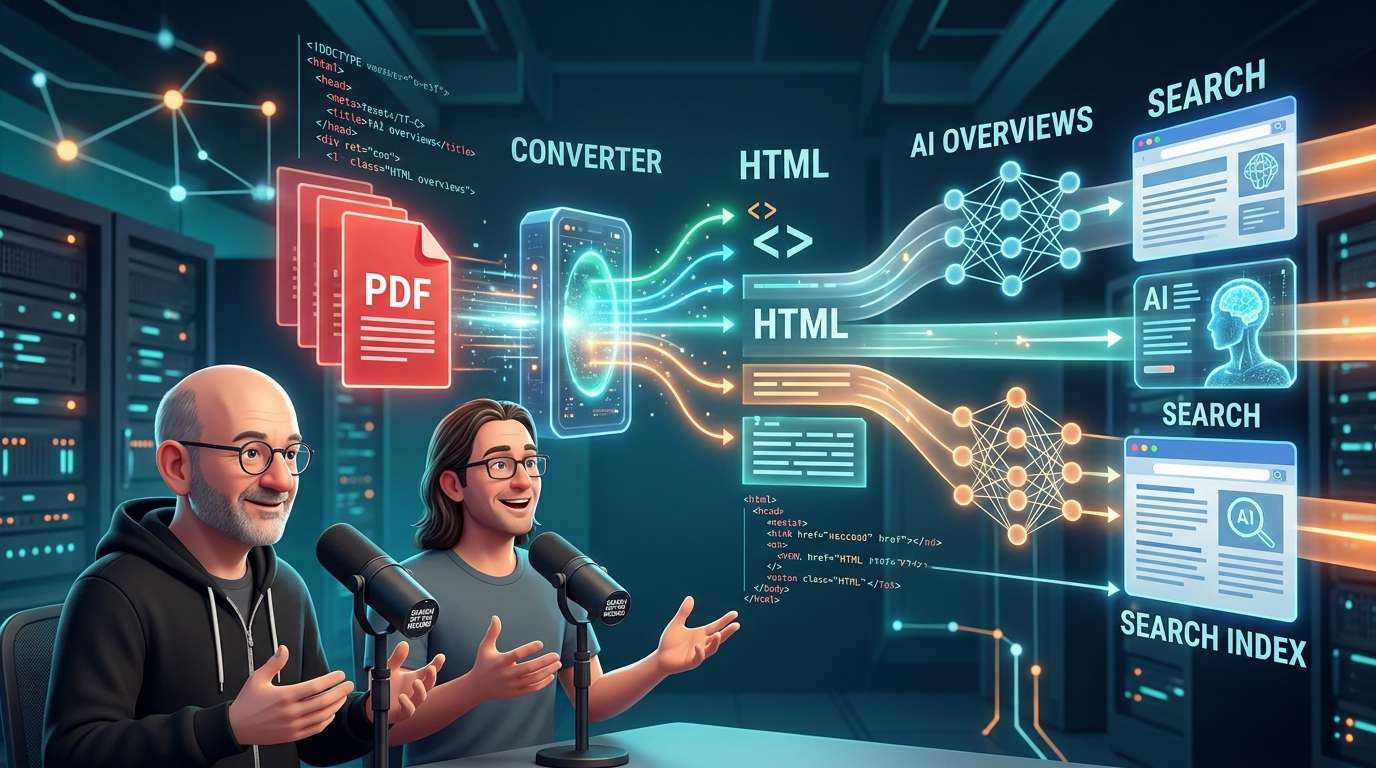
John Mueller y Martin Splitt, de Google, explicaron en el pódcast de la compañía cómo se procesan los PDF en las búsquedas. Según indicaron, la Búsqueda convierte los PDF a HTML mediante una función específica y utiliza la versión HTML para indexarlos. También reconoce los enlaces incluidos en los PDF una vez convertidos y estos pueden aparecer tanto en los resultados de búsqueda habituales como en AI Overviews y AI Mode.
Los PDF no son archivos que queden fuera de las búsquedas
¿Quién no ha oído alguna vez que «los PDF perjudican al SEO»? A la luz de las explicaciones de Google, conviene matizar un poco esa impresión.
Según Splitt, el sistema de búsqueda incluye un componente llamado conversor. Este interviene justo después del renderizado y antes de que se decida si el contenido se indexa, y se encarga de procesar los archivos según su formato. Admite una amplia variedad de formatos, como texto enriquecido, documentos y archivos de Excel. El conversor para PDF es uno de ellos.
El resultado de la conversión es HTML, por lo que las etapas posteriores trabajan casi exclusivamente con HTML. No es que Google abra el archivo con un visor de PDF y examine su contenido, sino que lo adapta para que se procese igual que una página web.
Por eso funcionan los enlaces
El mismo proceso explica por qué los enlaces insertados en un PDF funcionan como los enlaces habituales. Splitt señaló que la conversión genera una representación HTML lo más fiel posible al formato original, lo que permite detectar elementos como los enlaces. Mueller añadió que, al convertir los PDF a un formato similar al de las páginas web que Google sabe manejar, también se pueden utilizar sus enlaces.
Para las empresas que distribuyen documentos o páginas informativas en PDF, esto significa que los enlaces que dirigen a su sitio web podrían no ser en vano.
Aparecen tanto en las búsquedas como en el modo de IA
El proceso de conversión también explica por qué los PDF pueden aparecer en AI Mode. Como sucede en las búsquedas habituales, se indexan tras convertirse a HTML, por lo que pueden aparecer en AI Overviews y AI Mode. Splitt explicó que, en lo relativo a la indexación y la clasificación, se tratan prácticamente igual que otros documentos.
Los PDF no reciben un tratamiento aparte en las búsquedas con IA: si forman parte de la base de búsqueda, pueden acceder a ella por la misma vía.
Los PDF que solo contienen imágenes tienen una pega
Hay que tener en cuenta que no todos los PDF se leen como texto. Algunos, como los que solo contienen páginas escaneadas y guardadas como imágenes, parecen documentos, pero en realidad están formados por imágenes.
Splitt propuso una forma sencilla de comprobarlo: seleccionar y copiar el texto del PDF y pegarlo en un editor de texto. Si se puede pegar, está en condiciones de convertirse y utilizarse para la clasificación. Mueller añadió que el texto que se puede indexar también puede utilizarse en las búsquedas.
Splitt no dio una respuesta definitiva sobre las imágenes que contiene un PDF. Las imágenes normales se procesan enviando su URL al sistema de búsqueda de imágenes, pero las imágenes incluidas en un PDF no tienen una URL individual. Por eso, la hipótesis actual es que no se procesan igual que las imágenes de una búsqueda normal. También mencionó que este tratamiento podría cambiar en el futuro. En cuanto al límite de tamaño de los archivos, señaló que probablemente exista un límite de descarga distinto al de HTML, aunque no ofreció una cifra concreta.
Por qué elegir PDF y por qué HTML resulta más práctico
Entonces, ¿no se deberían crear PDF? La respuesta de Splitt fue: «Si el contenido lo requiere, no hay problema». Explicó que los PDF son útiles cuando se necesita controlar con precisión el aspecto al imprimir o cuando se trata de documentos interactivos, como formularios. Puso como ejemplo un formulario PDF para reservar alojamiento.
También se habló de los menús de restaurantes. Muchos establecimientos publican directamente el PDF que les ha preparado una imprenta, y eso es mucho mejor que no publicar nada. Mueller coincidió en que, si hay que elegir entre publicar el menú o no hacerlo, es preferible publicarlo en PDF.
Sin embargo, si se puede elegir entre un PDF y una página web convencional, Mueller prefiere esta última por su facilidad de uso. Añadió que, si el mismo contenido puede presentarse en HTML, todo resulta un poco más sencillo. Splitt también se mostró partidario de la flexibilidad del HTML.
La idea de facilitar el trabajo a los motores de búsqueda
De las explicaciones de Google se desprende que la cuestión no es si los PDF son mejores o peores para las búsquedas. Lo importante es lo fácil que resulte acceder a la información.
Los PDF pasan por un paso adicional de conversión antes de aparecer en las búsquedas. Por eso, si el mismo contenido puede ofrecerse en HTML, lo más sensato es prepararlo desde el principio en un formato más fácil de procesar tanto para los motores de búsqueda como para los lectores. La facilidad para abrir y leer una página de inmediato, así como la posibilidad de que se visualice correctamente en un móvil, también hacen que el HTML sea más cómodo para las personas.
Si vas a revisar los PDF de tu sitio web, empieza por comprobar si se puede copiar el texto. Después, decide qué contenidos también se pueden publicar en HTML. Ese orden parece un punto de partida práctico.
コメント