
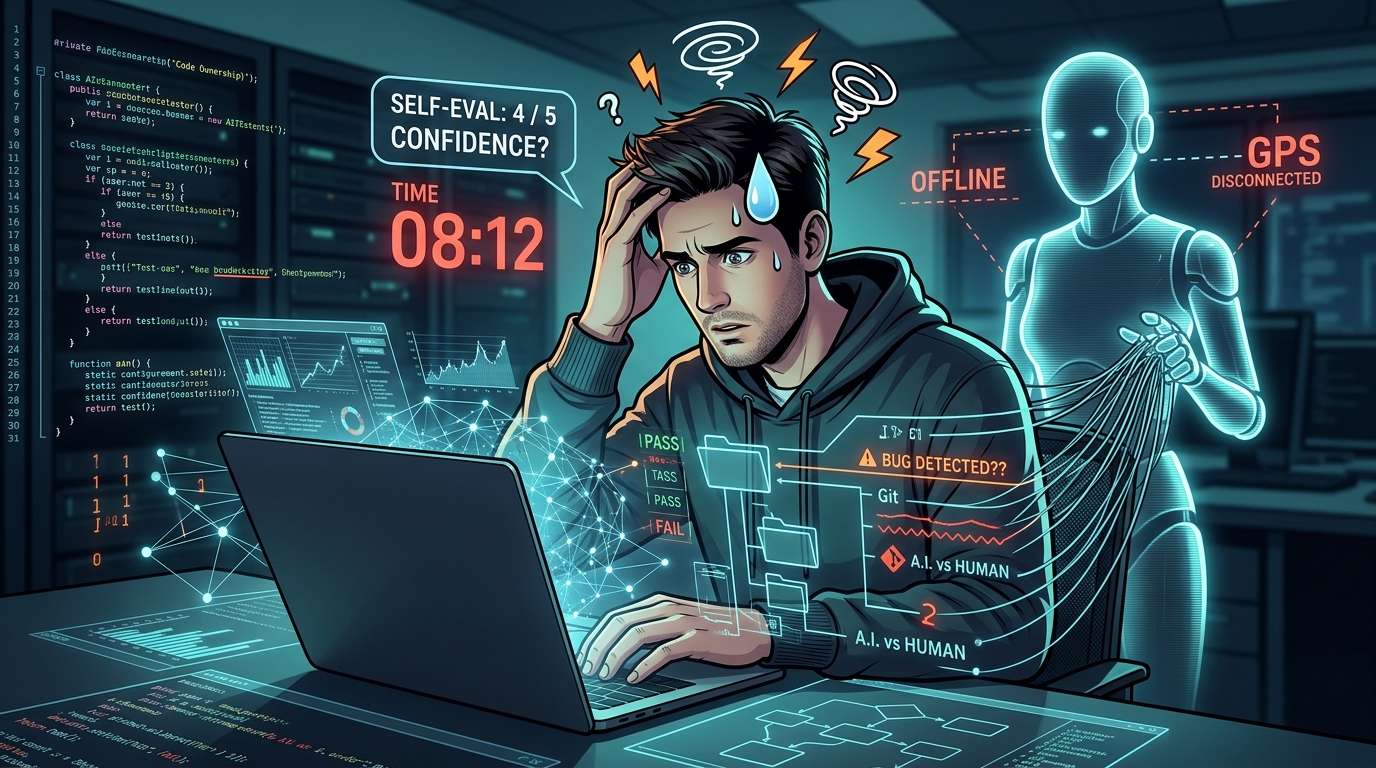
Peut-on maintenir du code implémenté par une IA sans faire appel à l’IA qui l’a écrit ? Le développeur Emmimal Alexander a publié la version V0.1 de « CodeOwnership », un outil conçu pour évaluer cette capacité.
Lors de son premier essai, il s’est attribué une note de 4 sur 5 pour son niveau de compréhension, mais a interrompu la recherche sans parvenir à trouver le bug introduit par une autre IA, alors qu’il lui restait 8 minutes et 12 secondes sur les 60 minutes imparties.
Même si votre nom figure dans le commit, ce n’est pas « votre code » si vous ne pouvez pas le corriger
Tous les tests sont au vert et la compilation passe. À cette annonce, beaucoup de personnes appuient sans crainte sur le bouton de merge (intégration dans la branche principale). Mais trois semaines plus tard, un signalement de bug arrive et l’assistant IA est indisponible : le quota d’utilisation est épuisé, ou vous êtes dans un train de banlieue sans réseau. Dans ce cas, êtes-vous capable de comprendre et de corriger vous-même le code sous vos yeux ? C’est précisément ce que CodeOwnership cherche à mesurer.
Ici, « propriété » ne désigne ni le droit d’auteur ni les licences. Il s’agit de la capacité, dans le cadre de la maintenance, à suivre la logique du code et à le modifier sans l’aide de l’IA. Le fait que les tests passent peut prouver que le logiciel fonctionne dans des conditions favorables, mais pas que l’on en comprend le contenu. C’est sur cette distinction que repose l’outil.
Le principe s’apparente à un test où l’on coupe le GPS
Le déroulement est le suivant. D’abord, un agent IA implémente une fonctionnalité. Ensuite, le développeur consigne sur une échelle de 1 à 5 son niveau de compréhension. Puis un autre agent introduit un seul bug, conformément à une spécification enregistrée au préalable. Enfin, le développeur, sans IA, cherche la cause du problème à partir du signalement.
Trois éléments sont consignés : l’autoévaluation avant le travail, le résultat du débogage sans IA (dans la limite de 60 minutes) et un questionnaire de compréhension de quatre questions, auquel il faut répondre après le travail. Ils sont rapportés séparément, et non réunis en une note unique. Une seule note masquerait l’écart entre « croire avoir compris » et le résultat obtenu lorsqu’on passe réellement à l’action.
L’auteur compare cela à un conducteur qui se fie toujours au GPS. Si on lui demande « connaissez-vous le chemin jusqu’à la maison ? », il répondra « oui ». C’est seulement lorsqu’il éteint son smartphone que la véritable réponse apparaît. On peut dire que CodeOwnership est l’outil qui éteint ce smartphone.
Des mesures pour garantir l’équité
L’auteur est à la fois le concepteur de l’outil et son sujet d’étude. De nombreux mécanismes sont donc prévus pour réduire les biais. Les fichiers de règles sont verrouillés par une empreinte de hachage — une sorte d’empreinte qui change si le contenu est modifié — et l’exécution s’arrête en cas de changement. Cette approche s’apparente à la préinscription d’un protocole de recherche.
Ce n’est pas l’auteur lui-même qui introduit le bug, mais un autre agent. L’auteur sait « ce qui ne fonctionne plus », mais ne regarde pas le diff indiquant « ce qui a été modifié ». La copie de travail utilisée pour le débogage ne contient ni l’historique Git, ni la spécification, ni les tests privés, ni les critères de notation. L’autoévaluation doit être validée avant l’introduction du bug, et le texte explicatif, avant l’affichage du score. Soixante-douze autotests vérifient que ces contraintes fonctionnent comme prévu.
Confiance : 4 ; bug introuvable
Le cas étudié est une bibliothèque de notes dotée d’une fonction de gestion des dossiers. Elle permet de créer et de récupérer des notes, de créer et de supprimer des dossiers, de déplacer des notes et d’afficher le contenu d’un dossier. Une même note peut aussi figurer dans plusieurs dossiers. La règle essentielle est que la suppression d’un dossier ne supprime pas les notes : seul le lien avec le dossier disparaît.
L’implémentation a été réalisée par ChatGPT (compte gratuit, modèle Auto, chat temporaire). Les 11 tests publics et les 13 tests d’acceptation privés ont tous réussi, et la vérification des critères a été validée. Après avoir lu le code, l’auteur a évalué sa compréhension à 4 sur 5 et l’a consignée dans Git avant l’introduction du bug. Ensuite, une autre session Claude a apporté des modifications en s’appuyant uniquement sur la spécification, et les vérifications du comportement ont également réussi.
Huit minutes et 12 secondes après le début du débogage, l’auteur a abandonné sans avoir trouvé la cause. Il explique qu’il était fatigué et agacé par des problèmes survenus lors des préparatifs la veille. L’outil ne proposait que deux choix : « corrigé » ou « délai écoulé ». Pour pouvoir avancer, l’auteur a sélectionné « corrigé ». Il n’a toutefois pas modifié le code, et la vérification objective a conclu à un résultat « non corrigé ». Les 11 tests publics ont tous réussi, tandis que 10 des 13 tests privés ont passé et que 3 ont échoué. Les quatre questions de compréhension n’ayant pas non plus été traitées, le rapport indique « incomplet ».
Le bug se résumait à deux lignes
La modification révélée par la suite consistait en deux lignes ajoutées au traitement de suppression des dossiers. Lorsque la liste des dossiers associés à une note devenait vide, la note était supprimée de son emplacement de stockage. C’était tout. Les notes présentes dans plusieurs dossiers conservaient au moins un lien et restaient intactes, mais celles qui n’étaient associées qu’à un seul dossier disparaissaient avec celui-ci.
À première vue, le raisonnement semble cohérent : la liste est vide, donc on supprime. Mais l’absence d’appartenance à un groupe ne signifie pas que la note est inutile. L’auteur explique qu’il aurait pu trouver un indice s’il s’était demandé : « À qui incombe la suppression des notes dans cette application ? » L’enjeu était de savoir s’il parvenait à se représenter la répartition des rôles, au lieu de se contenter de suivre le texte du code.
Ce qu’un seul essai permet de dire
Les résultats sont à interpréter avec prudence. L’essai n’a impliqué qu’un seul développeur, sur un seul sujet, et le débogage n’a été interrompu qu’une seule fois, en cours de route. L’auteur lui-même estime que cette expérience ne permet pas de dire si l’utilisation de l’IA affaiblit la compréhension du code. Le délai imparti était de 60 minutes : impossible de savoir, sur la base de cet essai, si le bug aurait été découvert en poursuivant le travail.
L’auteur indique avoir trouvé la cause quelques jours plus tard, après environ 30 minutes. Mais il s’agit de son propre témoignage : le temps n’a pas été mesuré et la correction n’a pas été vérifiée. Ce résultat n’a donc pas été comptabilisé. L’auteur signale également qu’en tant que concepteur de l’outil, il savait « ce qui pouvait casser » ; qu’il est impossible de distinguer l’effet de la fatigue et des problèmes de préparation ; que l’essai s’est écarté du plan initial, qui prévoyait d’utiliser un agent opérant dans le dossier de travail ; et que la combinaison d’outils a changé en cours de route. Enfin, les tests cachés et les critères de notation sont publiés dans le dépôt pour permettre la reproductibilité : quiconque voudrait refaire l’essai ne pourrait donc pas préserver les conditions de l’aveugle.
Cette expérience unique reste néanmoins utile à un égard : « confiance : 4, tests tous au vert » et « capacité à corriger seul » ne désignent pas nécessairement la même chose. C’est la manière la plus honnête de la considérer : comme un exemple concret de cet écart.
Les indices apportés par les recherches connexes
Pour contextualiser la question, l’auteur cite plusieurs études. Aucune ne valide toutefois l’outil utilisé ici : elles servent plutôt à éclairer les préoccupations qui sous-tendent la démarche.
Dans une étude publiée en juillet 2025 par METR, 16 développeurs expérimentés de logiciels open source ont utilisé des outils d’IA pour traiter 246 problèmes réels dans leurs propres dépôts. Résultat : le temps nécessaire à leur résolution a augmenté de 19 %. Avant l’expérience, les développeurs s’attendaient à aller 24 % plus vite ; après, ils estimaient malgré tout avoir gagné 20 % en rapidité. L’étude mesure le temps de travail, et non la compréhension du code. METR considère par ailleurs ces résultats comme dépassés et a annoncé, en février 2026, revoir le protocole expérimental.
Une étude publiée par Anthropic en janvier 2026 a porté sur 52 ingénieurs apprenant la bibliothèque Python Trio, dont la plupart étaient des développeurs peu expérimentés. Lors du quiz final, le groupe assisté par l’IA a obtenu une moyenne de 50 %, contre 67 % pour le groupe ayant écrit le code à la main ; l’écart est jugé statistiquement significatif. Le groupe utilisant l’IA a terminé environ deux minutes plus tôt, mais cette différence de durée n’est pas significative. En revanche, demander des explications ou poser des questions complémentaires était associé à de meilleurs résultats d’apprentissage. Ce serait donc moins l’utilisation de l’IA en elle-même que la manière de s’en servir qui ferait la différence. À noter également : l’auteur précise qu’il utilise habituellement Claude et qu’il s’en est aussi servi pour rédiger cet article.
L’automatisation, au détriment de la « pratique »
L’article s’appuie aussi sur des travaux classiques. En 1983, Lisanne Bainbridge soutenait dans son article « Ironies of Automation » que plus l’automatisation progresse, moins les humains ont l’occasion de s’exercer, ce qui se fait sentir lorsqu’ils doivent reprendre la main en cas d’anomalie. Le rapport entre le pilote automatique d’un avion et les compétences du pilote en est l’exemple typique.
En 1985, Peter Naur avançait dans « Programming as Theory Building » que programmer ne se résume pas à écrire du code : c’est aussi construire une compréhension — une théorie — du fonctionnement du logiciel. Quand un agent écrit et qu’un humain se contente d’approuver, quelle part de cette compréhension reste-t-il à ce dernier ? La question rejoint celle du « vibe coding », expression employée par Andrej Karpathy en février 2025 pour désigner une pratique consistant à accepter les résultats sans trop les lire. Cette approche peut sembler légère pour un projet de week-end destiné à être jeté, mais qu’en est-il des logiciels qui doivent être maintenus ?
Un petit exercice à faire dès aujourd’hui
Il est possible de s’exercer selon le même principe sans installer la version complète. Choisissez un petit morceau de code généré par l’IA et commencez par noter sur une échelle de 1 à 5 : « Si ce code tombe en panne ce soir, saurais-je le réparer ? » Demandez ensuite à une IA, lors d’une autre session, de modifier un seul comportement, sans consulter le diff. Lancez un chronomètre, fermez la session d’IA et tentez de réparer le code en vous appuyant uniquement sur la description du problème. Avant de vérifier la réponse, formulez la cause avec vos propres mots, puis comparez votre résultat à votre évaluation initiale.
Il se peut que vous ne trouviez pas le bug malgré votre confiance, ou que vous le corrigiez plus vite que prévu. Dans les deux cas, vous aurez appris quelque chose qu’une batterie de tests réussis ne pouvait pas vous révéler. Pour essayer la version complète, la procédure consiste à exécuter l’auto-test du dépôt, puis les commandes freeze et pilot, dans cet ordre.
L’auteur en tire quatre leçons : s’évaluer avant de commencer ; comprendre que réussir les tests et savoir corriger le code sont deux choses différentes ; s’entraîner avant qu’un problème ne survienne réellement ; et demander à l’IA d’expliquer le code. Une étude d’Anthropic indique également que les participants qui demandaient des explications ou posaient des questions complémentaires obtenaient de meilleurs résultats. Les auteurs précisent toutefois qu’il s’agit d’une corrélation, et non d’un lien de causalité.
Les changements prévus pour la V0.2
Pour la prochaine version, l’auteur prévoit quatre changements. Premièrement, ajouter une option permettant d’enregistrer correctement le fait d’avoir « abandonné ». Les réponses de l’utilisateur et les résultats des vérifications objectives seront affichés côte à côte, afin de ne pas imposer le choix entre « corrigé » et « temps écoulé ». Deuxièmement, faire une pause avant le débogage, pour éviter que la fatigue liée aux préparatifs n’influe sur les résultats. Troisièmement, revenir au projet initial : utiliser un agent capable de fonctionner dans le dossier du projet et d’exécuter lui-même les tests. Quatrièmement, demander à d’autres développeurs de suivre la même procédure. Les résultats d’une seule personne ne permettent pas de déterminer dans quelle mesure l’outil sera utile à d’autres.
コメント