
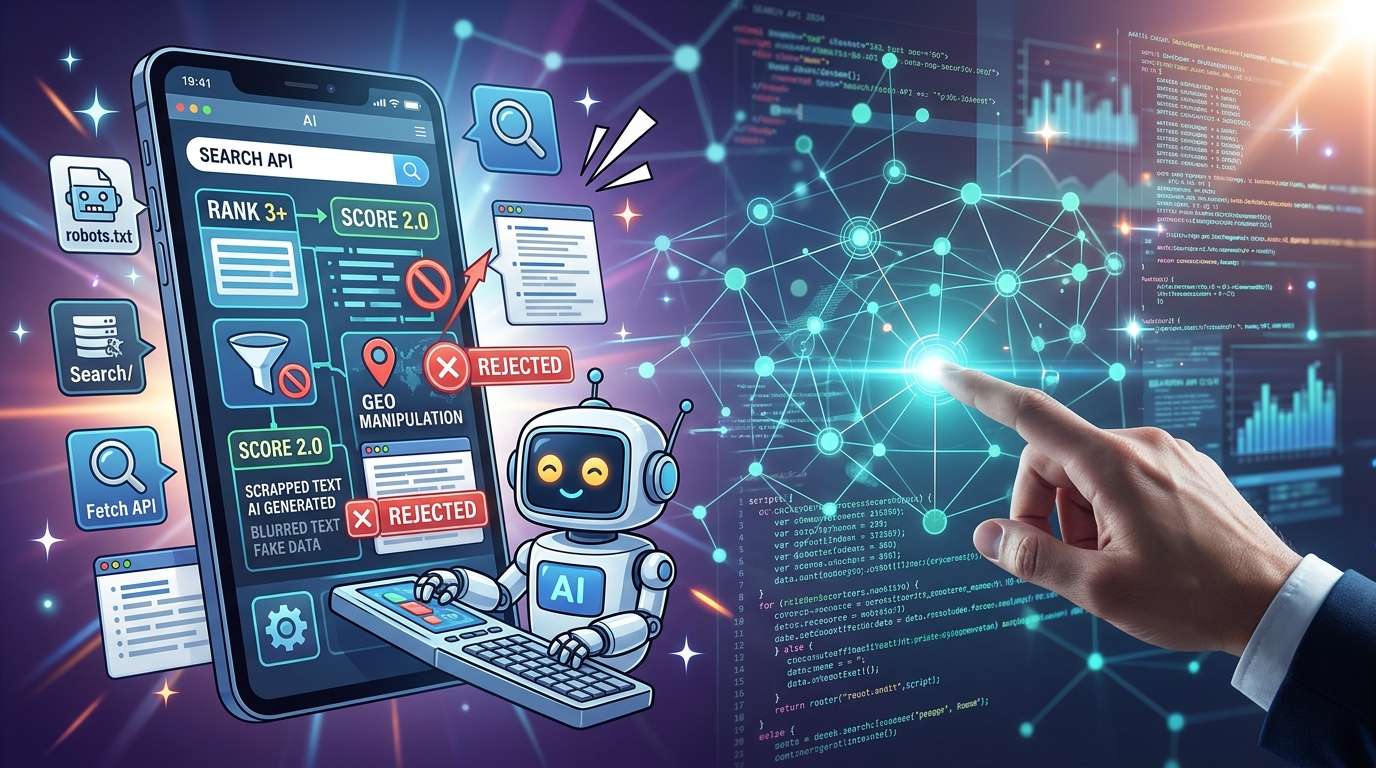
中国AI企业DeepSeek于10月17日面向开发者公开了自营搜索引擎的API。每条搜索结果都会附上一个表示页面权威性的等级,以及一个表示其与搜索词相关程度的评分。DeepSeek表示,该服务会过滤SEO垃圾信息、GEO操纵和低质量AI生成内容。
搜索结果开始打分的时代,已拉开序幕
此次公开的Search API可以说是把搜索引擎拆分成组件出售:输入关键词,就会返回网页搜索结果。DeepSeek称,这套引擎已经为其网站和API提供搜索支持,索引规模达数千亿个页面,每天处理来自全球数亿次的搜索请求。
引人注目的是搜索结果的内容。每个页面都会获得0到4级的权威性评级;无法判定时则标为“-1”。3级及以上的信息源会被视为“权威性较高”。此外,页面还会获得0到3分的相关度评分,评分除了考虑与搜索词的匹配程度,也会纳入权威性和新鲜度。1.5分及以上可作为高质量的参考标准。
换言之,搜索结果预先附带了“可信度参考指标”。这可以说是一种由搜索引擎分担部分工作、帮助AI在生成回答时挑选素材的设计。
面向AI读取的数据设计
返回的数据也并非只考虑人类在屏幕上查看。用于展示的简短摘录约为100至200字,供模型读取的摘要则约为600至800字。用户还可以请求获取网页正文,并使用site:限定域名,或按语言和发布日期筛选。
Search和Fetch的收费标准均为每成功处理1,000次请求0.75美元。没有返回结果的搜索不收费;无论请求50条还是1条,费用都相同。因此,使用site:搜索每次的成本不到1美分。
此外,如果通过Claude Code、Codex或DeepSeek Harness使用DeepSeek API,服务器端的搜索和页面抓取目前已经通过这些API处理,且暂时免费。预计将从10月31日16时(UTC)开始收费。
宣称将过滤GEO操纵
另一个值得关注的地方,是对过滤对象的说明。DeepSeek的更新日志称,会过滤SEO垃圾信息、GEO操纵和低质量AI生成内容。GEO指的是通过调整内容,让自家内容更容易被AI回答引用的做法。简单来说,可以把它理解为针对AI的SEO。
搜索引擎明确将面向AI的优化行为本身列为监控对象,颇具象征意义。Google也在5月15日表示,其垃圾信息政策同样适用于Google搜索中由生成式AI提供的回答。AI回答越是成为新的“曝光渠道”,针对这一渠道的操纵以及防范操纵的攻防,就越会浮出水面。
不过,公开资料并未说明GEO操纵具体指什么、如何检测,也没有披露权威性等级和相关度评分是如何确定的。评估指标的存在已经明确,但具体设计仍有待后续公开。
网站运营者能看到什么
对网站运营者而言,实际好处是可以自行查看自家网站在DeepSeek搜索中的呈现情况。使用site:搜索,最多可获取自家网站的50个页面,并查看每个页面的权威性和相关度。费用每次不到1美分,也很容易上手尝试。
另一方面,如果没有得到预期结果,就无法进一步追查原因:页面是没有被编入索引、触发了过滤器,还是因其他原因被排除?用户指南和API参考文档都没有提供区分这些情况的方法。
爬虫身份仍是待解问题
另一个令人关注的问题是爬取机制。Fetch API可以将单个页面以Markdown格式返回,指南称其会遵循目标网站的可用性和访问政策。DeepSeek-V4训练数据的欧盟版概要提到,爬虫的设计会尊重robots.txt等标准协议,但没有明确说明指的是哪个爬虫。
搜索索引爬虫的名称,以及Fetch使用的用户代理名称,在发布时的指南、API参考文档、更新日志和公告中都没有提及。汇总爬虫信息的Known Agents目录中,列有一个被描述为用于AI训练数据的DeepSeekBot。若在robots.txt中拒绝DeepSeekBot,是否也会影响页面进入搜索索引,单凭公开页面无法判断。
便利与不透明之间
此次公开让人们多了一种用数字确认内容在AI搜索中呈现情况的方式。不过,如果评分依据仍不透明,那么即便看到了数字,也很难据此决定该采取什么行动。
值得关注的是,DeepSeek将如何在文档中补充GEO操纵的定义、等级的划分方式,以及用于索引的爬虫名称。API在实际使用中的便利性,以及判定标准的透明度,这两点或将成为AI搜索评价标准能否确立的分水岭。
コメント