
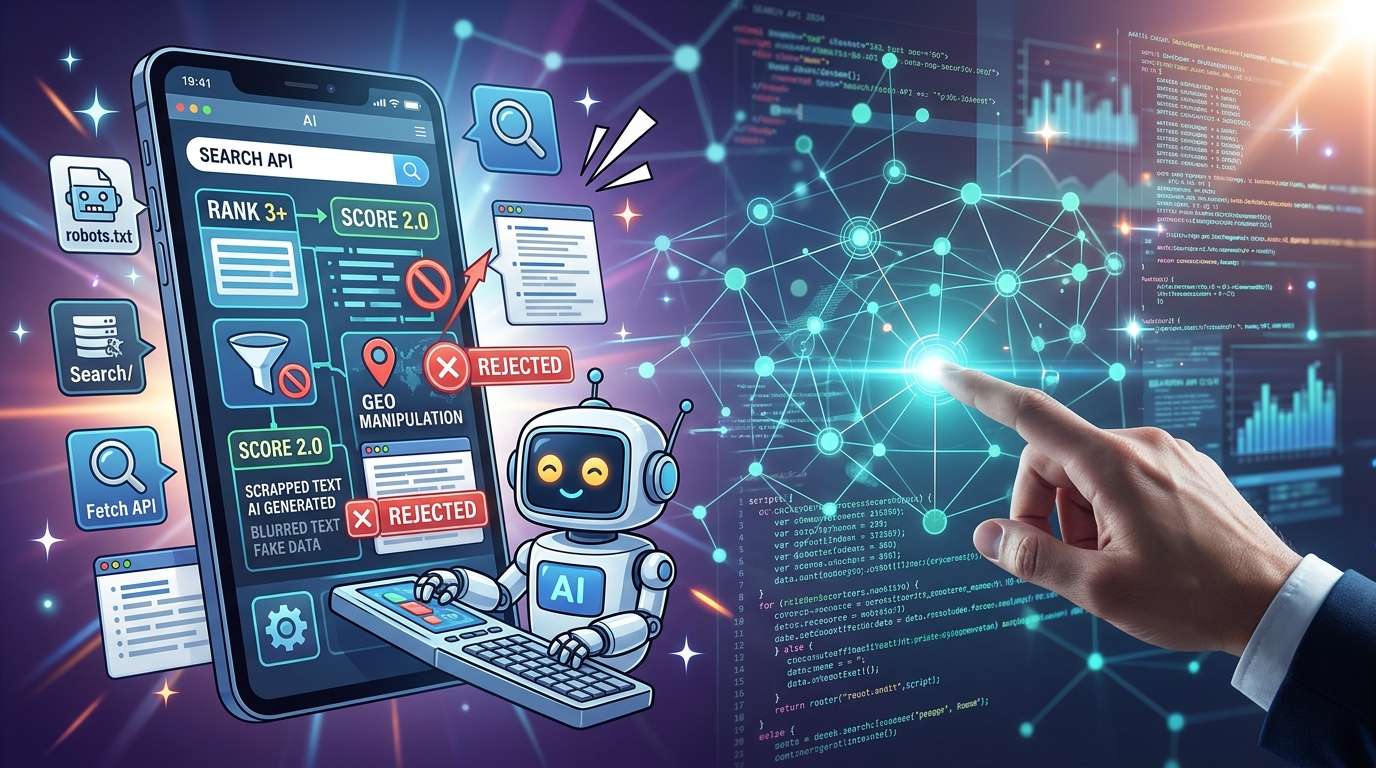
चीनी AI कंपनी DeepSeek ने 17 अक्टूबर को अपना सर्च इंजन डेवलपर्स के लिए API के रूप में जारी किया। हर खोज परिणाम के साथ पेज की प्रामाणिकता का स्तर और खोज शब्द से उसकी प्रासंगिकता का स्कोर दिया जाता है। कंपनी का कहना है कि इसमें SEO स्पैम, GEO हेरफेर और कम गुणवत्ता वाली AI-जनित सामग्री को फ़िल्टर किया जाएगा।
खोज परिणामों को स्कोर मिलने के युग की शुरुआत
अब जारी Search API में कीवर्ड डालने पर वेब खोज के परिणाम मिलते हैं—यानी इसे सर्च इंजन के हिस्से बेचने जैसा कहा जा सकता है। DeepSeek के मुताबिक, यह इंजन पहले से ही कंपनी की वेबसाइट और API पर खोज को संचालित करता है। यह कई सौ अरब पेजों के इंडेक्स और दुनिया भर से रोज़ आने वाले कई सौ मिलियन खोज अनुरोधों को संभालता है।
खोज परिणामों में क्या मिलता है, यह खास तौर पर ध्यान खींचता है। हर पेज को 0 से 4 तक का प्रामाणिकता स्तर दिया जाता है। अगर इसका निर्धारण न हो सके, तो स्कोर “-1” होता है। 3 या इससे अधिक स्कोर वाले स्रोतों को “उच्च प्रामाणिकता” वाला माना जाता है। इसके अलावा, 0 से 3 के बीच प्रासंगिकता स्कोर दिया जाता है, जिसमें खोज शब्द से मेल के साथ-साथ प्रामाणिकता और नवीनता भी शामिल होती है। कंपनी के मुताबिक, 1.5 या इससे अधिक स्कोर उच्च गुणवत्ता का संकेत है।
इस तरह खोज परिणामों के साथ पहले से ही “विश्वसनीयता का एक संकेत” दिया जाता है। कहा जा सकता है कि यह डिज़ाइन AI के जवाब तैयार करते समय सामग्री चुनने का कुछ काम खोज इंजन को सौंप देता है।
AI के पढ़ने को ध्यान में रखकर डेटा का डिज़ाइन
वापस मिलने वाला डेटा सिर्फ़ इंसानों की स्क्रीन पर दिखाने के लिए तैयार नहीं किया गया है। प्रदर्शन के लिए छोटा अंश लगभग 100–200 अक्षरों का और मॉडल को पढ़ाने के लिए सारांश लगभग 600–800 अक्षरों का होता है। अनुरोध करने पर पेज का पूरा मुख्य पाठ भी लिया जा सकता है। site: के ज़रिए डोमेन सीमित करने और भाषा या प्रकाशन तिथि के आधार पर नतीजे छाँटने की सुविधा भी है।
Search और Fetch, दोनों की कीमत हर 1,000 सफल अनुरोधों के लिए 0.75 डॉलर है। कोई परिणाम न देने वाली खोजों का शुल्क नहीं लिया जाता। 50 नतीजे माँगने और सिर्फ़ 1 माँगने पर भी कीमत समान है। इसलिए site: खोज की लागत प्रति बार 1 सेंट से कम बैठती है।
अगर Claude Code, Codex या DeepSeek Harness से DeepSeek API का इस्तेमाल किया जा रहा है, तो सर्वर-साइड खोज और पेज फ़ेच पहले से ही इन API के ज़रिए संसाधित होते हैं और फिलहाल मुफ़्त हैं। शुल्क 31 अक्टूबर को 16 बजे (UTC) से शुरू होने की योजना है।
GEO हेरफेर को बाहर रखने का ऐलान
एक और अहम बात यह है कि क्या-क्या फ़िल्टर किया जाएगा। DeepSeek के अपडेट लॉग में कहा गया है कि SEO स्पैम, GEO हेरफेर और कम गुणवत्ता वाली AI-जनित सामग्री को फ़िल्टर किया जाएगा। GEO का मतलब है, सामग्री को इस तरह तैयार करना कि AI के जवाबों में किसी कंपनी की सामग्री उद्धृत होने की संभावना बढ़ जाए। इसे खोज नतीजों में ऊँची रैंक पाने की कोशिश वाले SEO का AI संस्करण कहा जा सकता है।
यह प्रतीकात्मक है कि कोई सर्च इंजन AI के लिए किए जाने वाले अनुकूलन को भी स्पष्ट रूप से निगरानी के दायरे में रख रहा है। Google ने भी 15 मई को कहा था कि उसकी स्पैम नीतियाँ Google Search के जनरेटिव AI वाले जवाबों पर भी लागू होती हैं। AI के जवाब जितने अधिक नए “दृश्यता मंच” बनेंगे, उन्हें निशाना बनाने की कोशिशें और उन्हें रोकने के प्रयास भी उतने ही खुलकर सामने आएँगे।
हालाँकि, सार्वजनिक दस्तावेज़ों में यह नहीं बताया गया है कि GEO हेरफेर से ठोस तौर पर क्या आशय है, उसे कैसे पहचाना जाएगा या प्रामाणिकता के स्तर और प्रासंगिकता स्कोर कैसे तय होंगे। मूल्यांकन के मानदंड मौजूद हैं, यह स्पष्ट हो गया है; लेकिन उनके डिज़ाइन की बारीकियों के लिए आगे की जानकारी का इंतज़ार करना होगा।
वेबसाइट संचालक क्या देख सकते हैं
वेबसाइट संचालकों के लिए इसका व्यावहारिक फ़ायदा यह है कि वे अपने स्तर पर जाँच सकते हैं कि DeepSeek की खोज में उनकी साइट कैसी दिखती है। site: खोज से अपनी साइट के अधिकतम 50 पेज हासिल किए जा सकते हैं और हर पेज की प्रामाणिकता तथा प्रासंगिकता देखी जा सकती है। प्रति बार 1 सेंट से कम लागत होने के कारण इसे आज़माना भी आसान है।
दूसरी ओर, अगर अपेक्षित नतीजे नहीं दिखते, तो इसकी वजह का पता नहीं चल सकता। क्या पेज इंडेक्स से बाहर है, फ़िल्टर में फँस गया है या किसी और कारण से हटाया गया है? यूज़र गाइड और API संदर्भ, दोनों में इन वजहों को अलग-अलग पहचानने का कोई तरीका नहीं दिया गया है।
क्रॉलर की पहचान का सवाल बाकी
एक और सवाल क्रॉलिंग को लेकर है। Fetch API एक पेज को Markdown फ़ॉर्मैट में लौटाता है और गाइड के अनुसार, यह संबंधित साइट की उपलब्धता और पहुँच संबंधी नीतियों का पालन करता है। DeepSeek-V4 के प्रशिक्षण डेटा पर EU के लिए तैयार किए गए सारांश में कहा गया है कि क्रॉलर को robots.txt जैसे मानक प्रोटोकॉल का सम्मान करने के लिए डिज़ाइन किया गया है, लेकिन यह स्पष्ट नहीं किया गया है कि किस क्रॉलर की बात हो रही है।
जारी किए गए गाइड, API संदर्भ, अपडेट लॉग और घोषणा—इनमें से किसी में भी खोज इंडेक्स के क्रॉलर का नाम या Fetch किस यूज़र एजेंट के नाम से अपनी पहचान बताता है, इसका उल्लेख नहीं है। क्रॉलर संबंधी जानकारी जुटाने वाली Known Agents निर्देशिका में DeepSeekBot सूचीबद्ध है, जिसे AI प्रशिक्षण डेटा के लिए इस्तेमाल होने वाला बताया गया है। सार्वजनिक पेजों से यह पता नहीं चलता कि robots.txt में DeepSeekBot को रोकने से खोज इंडेक्स में शामिल होने पर भी असर पड़ेगा या नहीं।
सुविधा और अस्पष्टता के बीच
इस रिलीज़ के साथ AI खोज में अपनी दृश्यता को संख्याओं के ज़रिए जाँचने का एक नया तरीका मिला है। लेकिन जब तक स्कोर का आधार स्पष्ट नहीं होता, सिर्फ़ आँकड़े देखने से यह तय करना मुश्किल रहेगा कि आगे क्या कदम उठाए जाएँ।
ध्यान देने वाली बात यह है कि DeepSeek के दस्तावेज़ों में GEO हेरफेर की परिभाषा, स्तर तय करने का तरीका और इंडेक्सिंग क्रॉलर का नाम किस तरह स्पष्ट किए जाते हैं। API की व्यावहारिक उपयोगिता और मूल्यांकन मानदंडों की पारदर्शिता—ये दोनों बातें तय करेंगी कि AI सर्च के मूल्यांकन के पैमाने के रूप में ये कितने स्थापित होते हैं।
コメント