
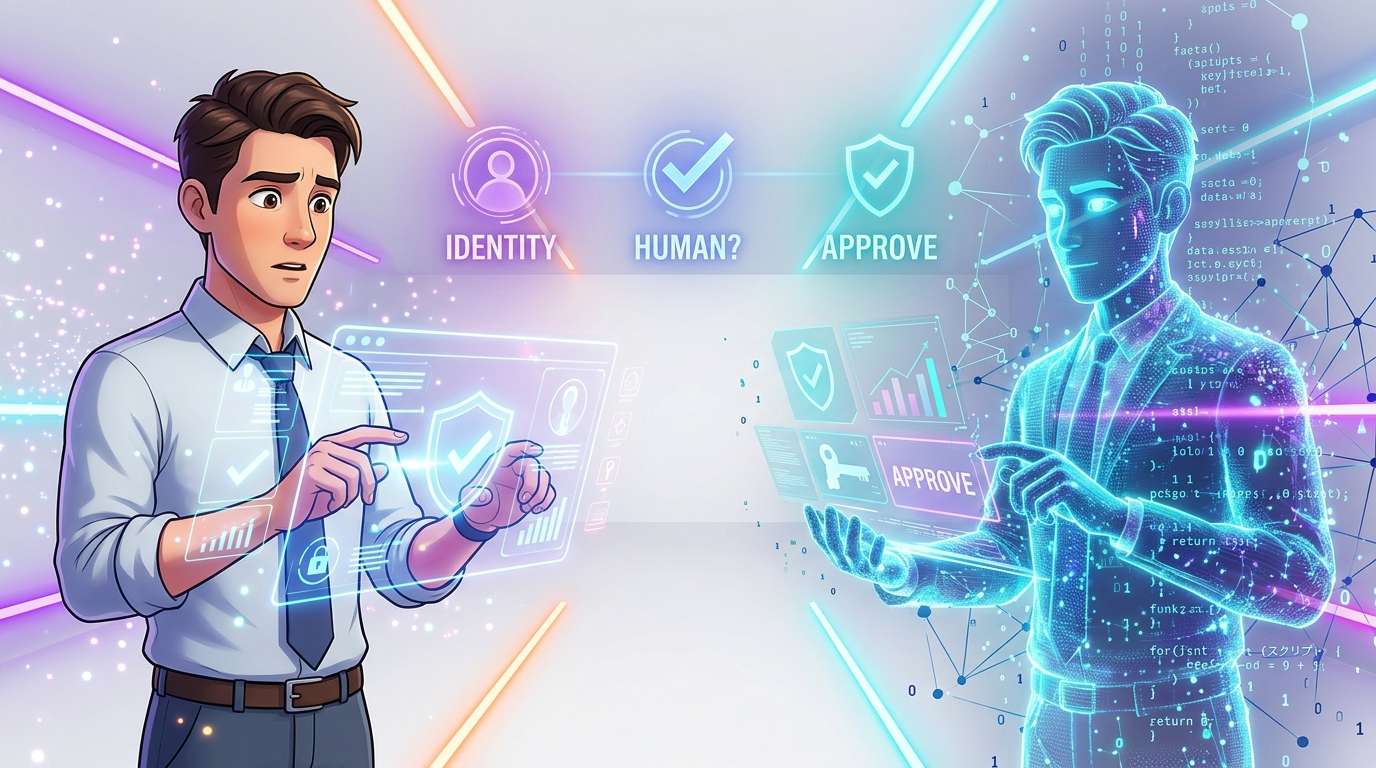
بات الذكاء الاصطناعي التوليدي ووكلاء الذكاء الاصطناعي قادرين على إنشاء النصوص والأصوات والصور، بل وتنفيذ عمليات عبر خدمات متعددة. وأصبح من الصعب على الخدمات الإلكترونية تمييز ما إذا كان الطرف المقابل إنسانًا حقيقيًا، أم برنامجًا مؤتمتًا، أم ذكاءً اصطناعيًا منحه إنسان صلاحية.
يشير مقال نشرته ZDNET Japan إلى ضرورة إعادة تنظيم مفهوم «التحقق (المصادقة)» الذي تحتاجه الشركات، وفقًا للشيء المراد التحقق منه.
الأتمتة الشبيهة بالبشر تهزّ أسس المصادقة
ظل الإنترنت يعمل طويلًا على افتراض ضمني بأن هناك إنسانًا في الطرف الآخر من الشاشة. وبالطبع، وُجدت الروبوتات وعمليات الدخول غير المصرح بها منذ زمن، لكن مواصلة محادثة تبدو بشرية، أو إنشاء صوت وصورة طبيعيين، أو تنفيذ عمليات عبر خدمات متعددة، كان يتطلب تكلفة وخبرة تقنية كبيرتين. وقد خفّض الذكاء الاصطناعي التوليدي ووكلاء الذكاء الاصطناعي هذه العتبة بدرجة كبيرة.
وتعكس الأرقام هذا التغيير أيضًا. فبحسب بيانات Cloudflare، تشكّل حركة مرور الروبوتات المؤتمتة نحو 57% من طلبات الويب، وقد تجاوزت النشاط البشري للمرة الأولى. ويشير المعيار المرجعي لعام 2026 الصادر عن HUMAN Security إلى أن حركة المرور الناشئة عن وكلاء الذكاء الاصطناعي ارتفعت في 2025 بنسبة 7851% على أساس سنوي. وفي اليابان، أعلنت وكالة الشرطة الوطنية أن عدد حالات الاحتيال الاستثماري والرومانسي عبر وسائل التواصل الاجتماعي التي أُبلغ عنها في 2024 بلغ 10,237 حالة، فيما وصلت الخسائر إلى نحو 127.2 مليار ين.
لكن هذه الأرقام لا تحصي حالات الاحتيال التي تستخدم الذكاء الاصطناعي وحدها. ما ينبغي الانتباه إليه هو أن التحقق من «وجود الطرف المقابل فعلًا» و«جدارة الثقة به» في التفاعلات عبر الإنترنت بات يتحول إلى تحدٍّ يواجه المجتمع بأسره. فالمسألة لا تقتصر على زيادة عدد الروبوتات؛ إذ تتزايد أعدادها، وفي الوقت نفسه تتحسن قدرتها على الظهور بمظهر بشري. وأرى أن تزامن هذين التطورين هو جوهر النقاش المطروح.
مواقف لا تكفي فيها كلمات المرور والمصادقة متعددة العوامل للحماية
تطور أمن الشركات حتى الآن حول حماية الحسابات. وتشمل أدواته معرّف المستخدم وكلمة المرور، والمصادقة متعددة العوامل، وإدارة الأجهزة، وتسجيل الدخول الأحادي، وانعدام الثقة، وإدارة صلاحيات الوصول. ولا تفقد أي منها قيمتها في عصر الذكاء الاصطناعي.
مع ذلك، فإن ما تتحقق منه هذه الأدوات أساسًا هو مشروعية «ما يملكه» المستخدم أو «ما يحق له»، مثل بيانات الاعتماد والأجهزة وصلاحيات الوصول. وإذا سُرقت بيانات المصادقة، أمكن للمهاجم التصرف كما لو كان مستخدمًا شرعيًا. وفي مؤتمرات الفيديو، بات انتحال الصوت والصورة باستخدام الذكاء الاصطناعي التوليدي خطرًا حقيقيًا؛ أما في التجارة الإلكترونية ودعم العملاء، فأصبح بوسع الروبوتات مواصلة محادثات طبيعية، ونشر التقييمات، وإرسال الاستفسارات، وإجراء عمليات الشراء والإلغاء، والحصول على القسائم.
ويزيد وكلاء الذكاء الاصطناعي المسألة تعقيدًا. فتركزت الأساليب التقليدية لمكافحة الروبوتات على استبعاد عمليات الوصول غير البشرية. لكن من المتوقع أن يزداد تفويض المستخدمين وكلاء الذكاء الاصطناعي بتنفيذ العمليات نيابة عنهم. وقد يؤدي رفض كل ما يصدر عن «روبوت» إلى إيقاف عمليات تفويض مشروعة أيضًا. لذلك يتعين على الشركات وضع حدود واضحة: ما العمليات التي يجوز تفويضها إلى الذكاء الاصطناعي، وما العمليات التي تتطلب موافقة بشرية؟
هل الطرف هو صاحب الهوية؟ وهل هو إنسان؟ وهل العملية معتمدة؟
ومن المفيد هنا تقسيم ما نريد التحقق منه إلى ثلاثة أمور.
أولًا: التحقق القانوني من الهوية
يتعلق الأمر بالتحقق من «من هو هذا الشخص»، وهو إطار قائم منذ زمن. ففي المعاملات المالية والإجراءات الإدارية وعقود الهاتف المحمول والتوقيعات الإلكترونية وغيرها من الحالات التي تنطوي على مسؤوليات قانونية أو تعاقدية، لا غنى عن التحقق من هوية الشخص، مثل اسمه وعنوانه وتاريخ ميلاده.
ثانيًا: التحقق من كون الشخص إنسانًا
ويُعرف هذا المفهوم باسم “Proof of Human”، ويتمحور حول سؤال: «هل الطرف إنسان حقيقي، لا روبوت؟». وليس من الضروري أن تعرف الخدمة الاسم الحقيقي للشخص. ويمكن أن يفيد هذا التحقق في الحالات التي لا تتطلب كشف الاسم الحقيقي، مثل ضمان مشاركة كل شخص مرة واحدة، والحد من تعدد الحسابات، وإظهار أن الطرف المقابل إنسان حقيقي.
ثالثًا: التحقق من النية البشرية والموافقة
ويعني التحقق مما إذا كانت العمليات التي نفذها وكيل الذكاء الاصطناعي تستند إلى نية إنسان أو موافقته. فقد يكون من الممكن تفويض الذكاء الاصطناعي بجمع المعلومات أو إعداد المسودات، لكن العمليات عالية المخاطر، مثل تحويل الأموال أو إبرام العقود أو الوصول إلى البيانات الشخصية أو إرسال البيانات إلى جهات خارجية أو تغيير صلاحيات المسؤول، قد تتطلب سجلًا يثبت موافقة الإنسان.
تبدو هذه الأمور الثلاثة متشابهة، لكن لكل منها غرضًا مختلفًا. ففي الحالات التي تتطلب تحققًا قانونيًا من الهوية، قد لا يكفي إثبات أن الطرف إنسان. وعلى العكس، فإن طلب تحقق مفرط من الهوية في مواقف لا تتطلب كشف الاسم الحقيقي يزيد الأعباء على المستخدمين ومخاطر انتهاك الخصوصية. وينبغي أيضًا التعامل مع التحقق من الموافقة على عمليات الذكاء الاصطناعي بوصفه مسألة منفصلة عن التحقق من الهوية أو تحديد ما إذا كان الطرف روبوتًا. فالفكرة الشاملة القائلة إن «التحقق من الهوية يعني الأمان» بات يصعب الاعتماد عليها في عصر الذكاء الاصطناعي.
لا توقفوا الذكاء الاصطناعي، وأبقوا الإنسان حاضرًا في العمليات الخطرة فقط
تكمن قيمة وكلاء الذكاء الاصطناعي في قدرتهم على رفع كفاءة مهام مثل الأعمال الروتينية، وجمع المعلومات، والمقارنة والتقييم، والتحضير للحجوزات، وصياغة رسائل الاستفسار. وإذا فُرض تحقق بشري صارم على كل عملية، فسيُفرغ ذلك الأتمتة إلى حد كبير من معناها.
لكن السماح بتنفيذ العمليات عالية المخاطر من دون تحقق يترك مشكلات مثل تحديد المسؤولية، وسوء الاستخدام، والتدقيق، والمساءلة قائمة. وهنا تبرز أهمية التدرج بحسب مستوى المخاطر: تُنفذ عمليات القراءة منخفضة المخاطر وإعداد المسودات بأقل قدر ممكن من العوائق، بينما تُطلب موافقة بشرية صريحة على العمليات المهمة أو التي تتطلب مستوى عالياً من الثقة أو تنطوي على تكلفة كبيرة. ويُعتقد أن هذه الفلسفة في التصميم ستحدد موثوقية الخدمات الرقمية في المستقبل.
وثمة نقطة أخرى لا ينبغي إغفالها، وهي كيفية التعامل مع البيانات. فحتى في الحالات التي تتطلب ضمانات أقوى، من المهم تصميم الأنظمة بحيث تتحقق من المعلومات اللازمة لاتخاذ القرار فقط، من دون حفظ بيانات شخصية إضافية. ومن الطبيعي أن تدفعنا الرغبة في تعزيز التحقق إلى جمع مزيد من المعلومات، لكن جمع البيانات يفرض أيضاً مسؤولية حمايتها. وإثبات وجود تدخل بشري، من دون الاحتفاظ ببيانات زائدة: يبدو أن تحقيق هذين الأمرين معاً هو التحدي الذي تواجهه الشركات في مجال المصادقة في عصر وكلاء الذكاء الاصطناعي.
コメント