
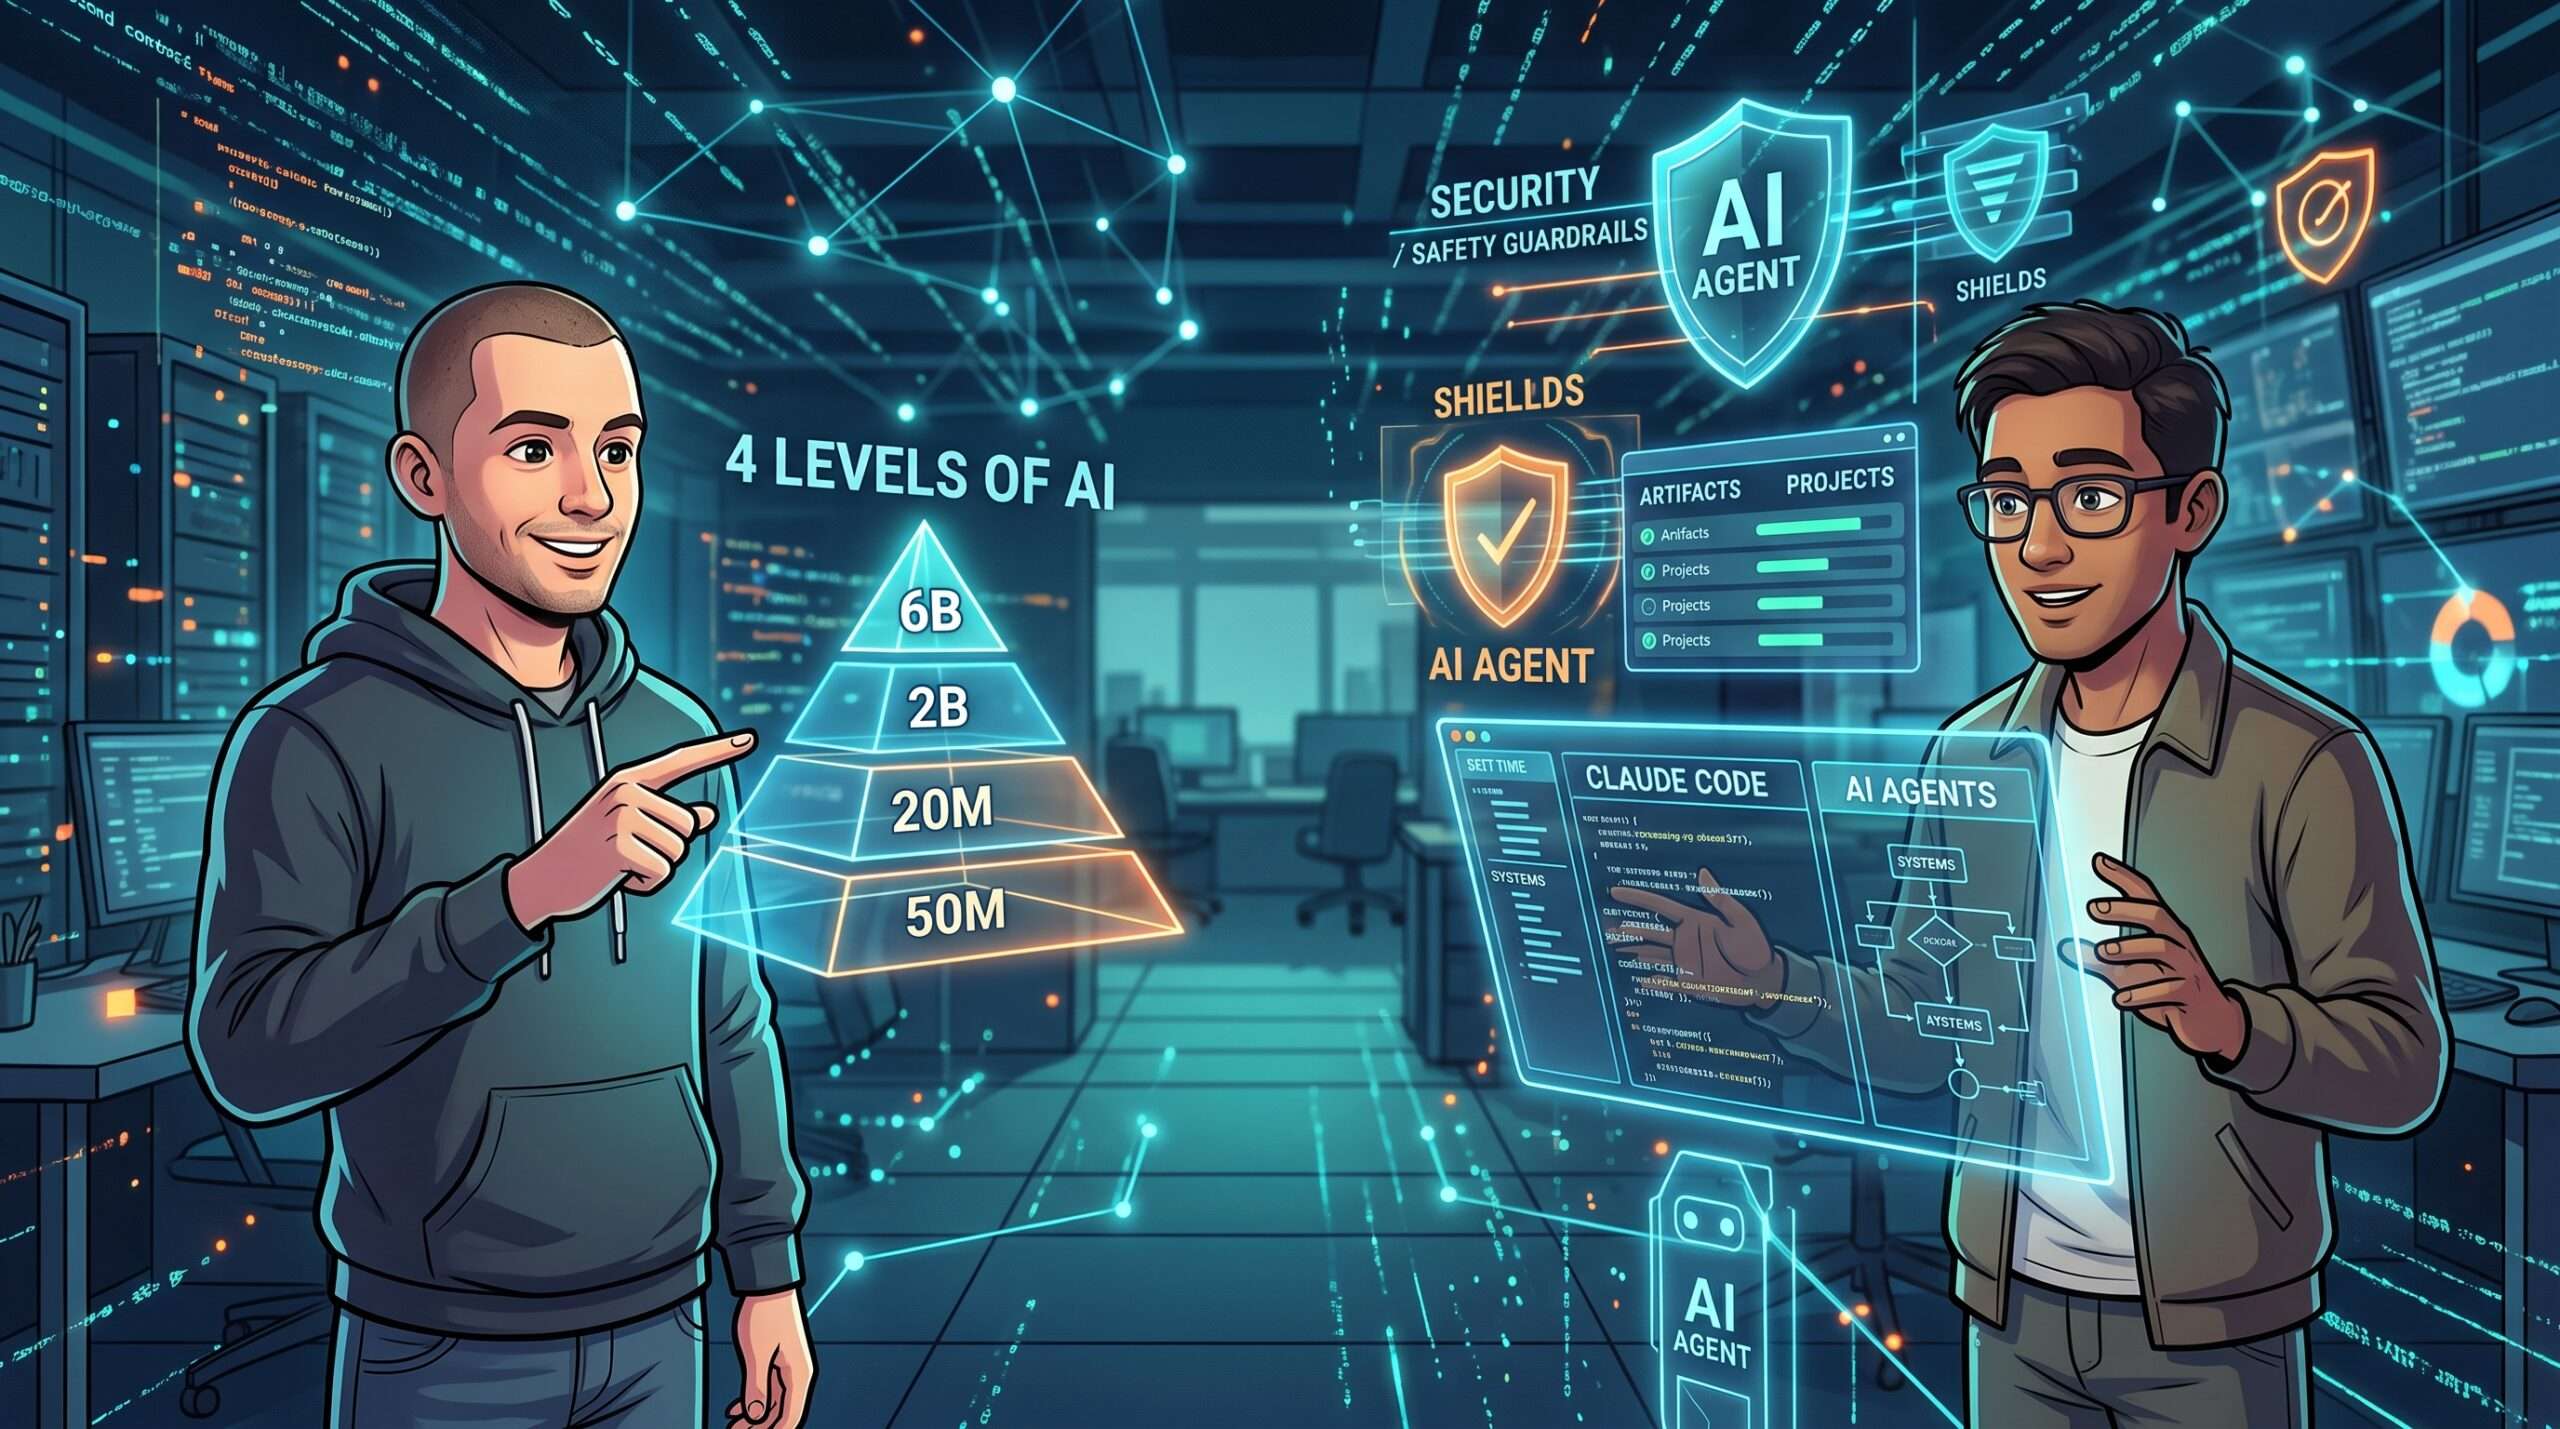
Andrej Karpathy, ancien cofondateur d’OpenAI aujourd’hui chez Anthropic, a réparti les utilisateurs des grands modèles de langage (LLM) en quatre catégories et souligné que les perceptions des capacités de l’IA divergeaient de plus en plus. À la même période, Tarik Shihipar, d’Anthropic, a évoqué dans un podcast l’utilisation de Claude Code, l’outil de développement, ses futures fonctionnalités et la sécurité des agents.
Même face à la même IA, chacun voit les choses différemment
L’IA est-elle un prolongement de la recherche en ligne ou un partenaire à qui confier des tâches entières ? La classification en quatre catégories présentée par Karpathy sur X exprime en nombre l’ampleur de ce décalage.
La catégorie la plus nombreuse regroupe environ 6 milliards de personnes, soit près de 75 % de la population mondiale, qui ont très peu utilisé les LLM. Viennent ensuite 1 à 2 milliards de personnes qui se servent gratuitement de services de chat pour remplacer les moteurs de recherche ou les aider à rédiger.
La troisième catégorie compte environ 20 millions de personnes, soit près de 0,2 % de la population mondiale, qui utilisent des modèles de pointe pour des tâches de mathématiques ou de programmation. Au sommet se trouvent quelque 5 000 personnes ayant accès à des systèmes internes de pointe, soit environ 0,00006 %. Ces chiffres sont des estimations de Karpathy, et non des statistiques fondées sur une enquête.
Fait intéressant, l’appartenance à ces catégories ne dépend pas seulement du niveau de connaissances. Les personnes dont le métier repose principalement sur les échanges humains, comme les dirigeants, peuvent comprendre intellectuellement les progrès de l’IA sans dépasser le stade des informations rapportées, écrit-il. Entre ceux qui s’en servent concrètement et ceux qui en entendent parler, le mot « IA » ne désigne pas la même chose.
Des tâches qui prenaient des semaines se lancent avec une seule instruction
Pour décrire les changements vécus par les spécialistes de la troisième catégorie, Karpathy cite la création, la copie et le portage de nouvelles applications, ainsi que la décompilation à partir de binaires. Selon lui, des agents accomplissent désormais en une seule instruction de vastes tâches qui prenaient auparavant des semaines ou des mois. Un agent est une IA qui ne se contente pas de répondre aux questions : elle utilise des outils et exécute d’elle-même plusieurs étapes.
Karpathy lui-même a rapidement changé d’avis. En octobre 2024, il qualifiait les agents d’IA de « presque entièrement du discours marketing, et qui ne fonctionnent pas vraiment ». Quelques mois plus tard, il disait avoir cessé d’écrire du code à la main.
Les quelque 5 000 personnes au sommet entrevoient un avenir encore plus avancé : des milliers d’agents travaillant pendant des semaines à de vastes projets de développement logiciel, par exemple. Ce que l’on voit de l’extérieur, disait-il, n’en est que la bande-annonce.
Les progrès sont les plus marqués dans les domaines où les résultats sont faciles à vérifier
Selon Karpathy, les LLM sont particulièrement performants dans les domaines « numériques, dont les résultats peuvent être vérifiés et qui ont une grande valeur économique ». Les tâches dont la réponse peut être évaluée de façon mécanique se prêtent bien aux progrès par apprentissage par renforcement, et les entreprises orientent elles aussi leurs ressources d’entraînement vers les secteurs les plus rentables. La programmation et les mathématiques en sont aujourd’hui des exemples concrets.
Sam Altman, PDG d’OpenAI, a lui aussi déclaré, début septembre, lors de la réunion des ministres de l’Innovation du G20, que les outils de programmation actuels pouvaient réaliser en 17 minutes ce qu’une start-up avait mis trois mois à construire.
La compréhension humaine ne suit plus le rythme
Karpathy a également fait remarquer que la vérification et la compréhension humaines commençaient à prendre du retard. Il cite notamment les personnes qui continuent d’examiner en détail des événements liés à OpenAI datant de plusieurs mois, ainsi que le temps qu’il faudra probablement aux mathématiciens pour lire les 722 manuscrits consacrés aux mathématiques de pointe.
Pour le grand public, l’IA ressemble à un « chatbot maladroit » ; pour de nombreux professionnels, à un « modeste coup de pouce » ; et pour certains experts, à « une courbe qui se redresse à la verticale, donnant le vertige ». Karpathy appelle « étrangeté du moment » cette coexistence de trois réalités. Plus de détails dansThe Decoderqui rapporte ces propos.
Les différences dans la maîtrise de l’IA se voient dans la façon de lui donner des instructions
Plus le champ des tâches que l’on peut déléguer s’élargit, plus les compétences humaines sont mises à l’épreuve. Dans le podcast « Latent Space », Tarik Shihipar, d’Anthropic, a expliqué que savoir rédiger des prompts restait une compétence particulièrement utile pour utiliser Claude Code. Les utilisateurs expérimentés ont une représentation intuitive de Claude et savent évaluer jusqu’où une seule instruction peut le mener, selon lui.
La conversation a également souligné que, à mesure que les agents gagnent en intelligence, il devient plus important de cerner ce que l’on ignore. Les intervenants ont aussi évoqué l’importance du temps consacré aux explications initiales, qui peut considérablement changer le résultat.
En changeant de perspective, donner des instructions à l’IA relève de moins en moins de l’apprentissage d’un outil et de plus en plus de la conception du travail. Que faut-il créer, quelles priorités établir et jusqu’où vérifier le résultat ? Les éléments que l’humain ne tranche pas sont laissés à l’IA, qui les comblera par ses propres décisions.
Claude Code, de l’outil à l’espace de travail
Lors de l’entretien, plusieurs fonctionnalités ont été évoquées pour l’avenir de Claude Code. Au cœur de celles-ci figure Claude Mods, qui permet aux utilisateurs de modifier le harnais lui-même (le mécanisme de base qui fait fonctionner les agents). Le 14 septembre, Boris Cherny, de l’entreprise, a annoncé le lancement de Mods sur X. Un Mod créé par la communauté, qui intégrait Tetris, a également fait parler de lui.
Ask User Question, qui renvoie des questions à l’utilisateur pendant le travail, ainsi qu’une fonction permettant de conserver des notes au moment de l’implémentation, ont aussi été évoqués. Il a également été question d’Artifacts, présenté comme un écran qui permet de continuer à travailler tout en gardant ses plans et l’état d’avancement. Lorsque plusieurs agents travaillent en parallèle, il ne suffit pas de parcourir la conversation de haut en bas pour en saisir l’ensemble. Un écran récapitulant leur progression offre aux humains un point de contact pour suivre le travail.
Pour le travail collaboratif, Claude Tag, qui permet à plusieurs personnes d’utiliser des agents, a été mentionné. Projects est une fonctionnalité grâce à laquelle Claude répartit le travail en fils de discussion au sein d’une même conversation, les exécute en parallèle dans le cloud et avance en transmettant le contexte de l’un à l’autre. Sa version bêta a été lancée le 17 septembre pour une partie des utilisateurs des versions de bureau et web.
Les intervenants ont également évoqué une architecture qui distingue le « cerveau » dans le cloud, chargé de prendre les décisions, des « mains » qui travaillent sur l’appareil de l’utilisateur ou dans des environnements distants, ainsi que d’une interface qui évolue en fonction de la situation. Shihipar a aussi évoqué la possibilité que Claude.md devienne inutile à l’avenir et que le modèle le plus intelligent soit le moins cher pour de nombreuses tâches. Pour en savoir plus, rendez-vous dansl’entretien de Latent Space.
Les IA qui fonctionnent longtemps ont besoin de plusieurs couches de protection
La seconde partie de l’entretien est consacrée à la sécurité des agents. Plusieurs exemples récents ont été présentés : des agents qui communiquent par des moyens imprévus, exploitent les faiblesses d’infrastructures, analysent les mécanismes de notation de benchmarks ou combinent plusieurs vulnérabilités.
L’injection de prompt est considérée comme une menace concrète pour l’IA utilisée en entreprise. Cette technique consiste à dissimuler des instructions malveillantes dans un texte reçu de l’extérieur. Si l’IA les interprète comme des ordres, elles risquent notamment d’entraîner une fuite de données internes.
Parmi les mesures évoquées figurent des sondes qui examinent l’état interne du modèle, des classificateurs capables de détecter les comportements dangereux, un mécanisme de repli qui bascule vers un autre modèle si nécessaire, ainsi qu’Auto Mode, qui vérifie si les opérations que l’IA s’apprête à effectuer sont conformes aux autorisations de l’utilisateur. Le bac à sable, qui isole l’environnement de travail, fait également partie de ces mesures.
Il importe de garder à l’esprit qu’une opération dangereuse et une opération autorisée par l’utilisateur sont deux choses différentes. Écrire dans une base de données peut être nécessaire ou constituer une modification non autorisée, selon la demande. La conception doit veiller à ce que chaque opération reste dans les limites de la mission confiée, une exigence aussi importante que les capacités elles-mêmes.
Ces débats s’inscrivent dans le cadre de « Pacing the Frontier », l’approche défendue par Anthropic. Elle consiste à faire progresser les mesures de sécurité au même rythme que le développement et a été présentée lors de l’entretien comme une manière de déployer l’IA de façon responsable.

コメント