
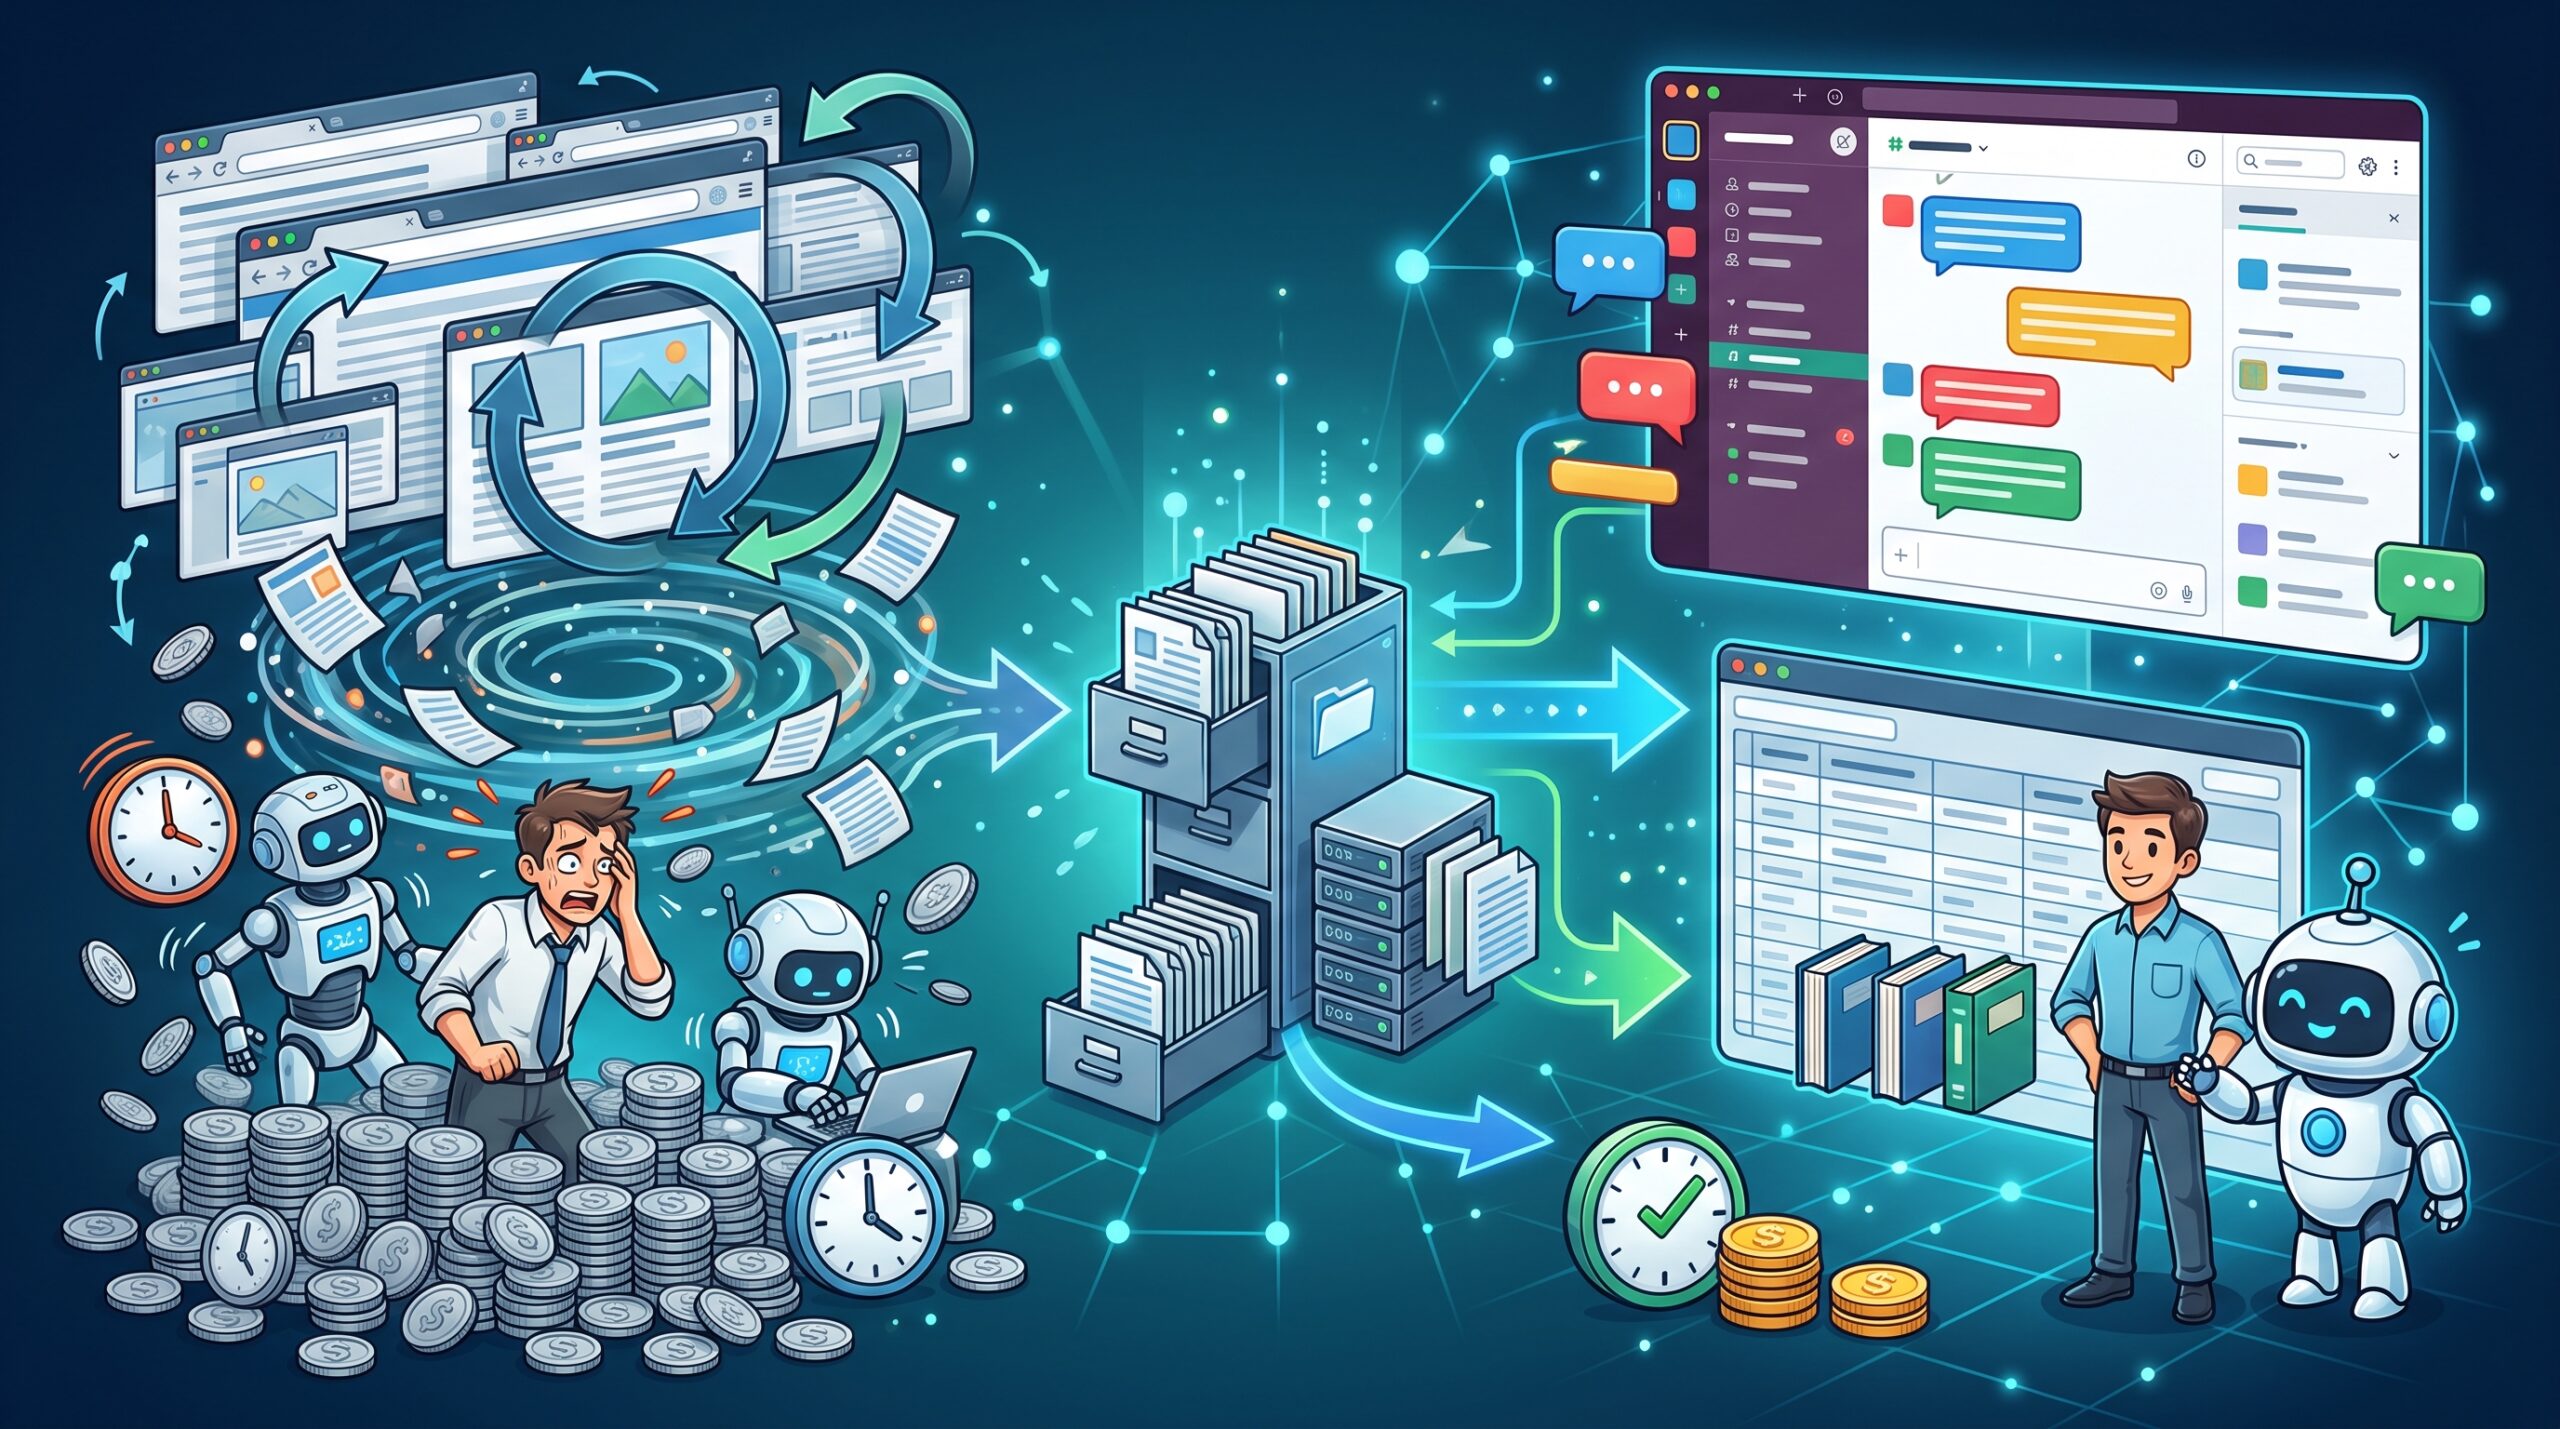
A Asana anunciou que, num teste de otimização da IA de operações no browser da StackAI, a configuração com GPT‑6.1 Sol registou um custo estimado de modelo médio de 0,47 dólares por execução e um tempo de execução de cerca de 4 minutos. Em comparação com a configuração inicial de produção, os custos foram reduzidos para cerca de 1/76 e a velocidade de processamento aumentou cerca de cinco vezes.
A redução para 1/76 não se deveu apenas à mudança de modelo
Abrir páginas Web, procurar as informações necessárias e preencher formulários. Ao contrário de uma IA que gera uma resposta de uma só vez, os agentes de browser que executam este tipo de operações recorrem repetidamente ao modelo durante o trabalho. Na StackAI, adquirida pela Asana, os clientes podem criar, sem escrever código, fluxos de automatização que abrangem várias aplicações empresariais.
Um aspeto importante destes números é que a redução para cerca de 1/76 inclui tanto melhorias no processo como a mudança de modelo. Mesmo com o modelo B usado inicialmente, a otimização reduziu o custo estimado do modelo por execução de mais de 36,21 dólares para 1,24 dólares. Depois, com o GPT‑6.1 Sol, o valor baixou para 0,47 dólares. Uma parte significativa da redução foi alcançada antes da mudança de modelo.
Além disso, o custo referido é uma estimativa das despesas de utilização do modelo. Não significa que o custo total, incluindo despesas de servidor e mão de obra de desenvolvimento e operação, tenha diminuído na mesma proporção.
Se o histórico for reduzido em excesso, a IA volta a ler as mesmas páginas
Frank Hidalgo, CTO da StackAI e responsável pela investigação, pediu ao GPT‑6 Astra do Codex que analisasse o código e testasse propostas de melhoria. Um dos problemas identificados foi o reenvio do conteúdo das páginas e do histórico de capturas de ecrã sempre que se consultava o modelo. As instruções fixas, por exemplo, podiam ser reutilizadas, mas o mesmo mecanismo não era aplicado ao histórico de navegação, que continuava a crescer.
Além disso, as imagens antigas eram eliminadas e o texto truncado em quase todas as etapas. Alterar o histórico com frequência dificulta o funcionamento da cache, que reduz os custos reutilizando dados de entrada já processados. Se forem eliminadas demasiadas informações, a IA pode voltar a visitar páginas que já leu. Assim, uma estratégia destinada a encurtar os dados de entrada podia, na prática, aumentar o trabalho.
Em vez de eliminar as imagens a cada passo, acumulam-se 20 antes de as organizar
No teste, foram definidos limites de retenção do histórico de 120 mil e 480 mil caracteres e alteradas as políticas de cache e gestão de imagens. Foram realizadas 144 execuções com quatro modelos. A tarefa era a mesma em todos os casos: recolher seis informações sobre cada um de 32 livros, a partir de um catálogo público de demonstração.
Na configuração otimizada com GPT‑6.1 Sol, as capturas de ecrã eram acumuladas até 20 e, depois, ficava apenas a mais recente. Em vez de eliminar imagens a cada passo, organizá-las em conjunto prolongou o período em que o histórico podia ser reutilizado sem alterações.
Mesmo comparando apenas o GPT‑6.1 Sol, a revisão da cache e da gestão de imagens, com um limite de retenção do histórico mais elevado, reduziu o custo estimado do modelo de 1,97 dólares para 0,47 dólares. Após a otimização, 89% dos dados de entrada foram processados através da cache, sendo o custo dessa parcela equivalente a 5% do custo normal dos dados de entrada. O que fez a diferença foi não apenas reduzir a informação, mas conceber o sistema para facilitar a reutilização da informação retida.
Mudou também a taxa de conclusão, não apenas o custo
A gestão do histórico também influenciou a capacidade de concluir as tarefas. Com o GPT‑6.1 Sol e um limite de retenção reduzido, foi possível gerar uma resposta em apenas três das 18 execuções. Com um limite mais elevado, foram geradas respostas nas 18 execuções, todas com resultados corretos, segundo a empresa.
Ainda assim, é preciso interpretar com cautela a comparação de cerca de 1/76 nos custos e de uma velocidade cerca de cinco vezes superior. A configuração inicial inclui execuções que atingiram o limite de etapas antes de concluir a tarefa; por isso, os valores de mais de 36,21 dólares e mais de 22,5 minutos representam limites mínimos. Os principais valores comparativos são também médias de três execuções por configuração e resultam da tarefa de recolha de informações realizada neste teste. Não é possível concluir que a mesma redução se aplique a outros sites ou processos de trabalho.
Cada modelo também tem os seus pontos fortes. Após a otimização, o modelo C custou 0,66 dólares e demorou 3,5 minutos: foi mais caro do que o GPT‑6.1 Sol, que custou 0,47 dólares e demorou cerca de 4 minutos, mas concluiu a tarefa mais depressa. Na implementação, é necessário comparar separadamente o custo e a velocidade.
A IA executa as experiências e as pessoas confirmam as alterações
Neste caso, o GPT‑6 Astra não se limitou a sugerir melhorias: também fez alterações ao código e executou testes para uniformizar as condições experimentais. Outra sessão do modelo reviu o trabalho, e os pedidos e resultados foram registados no Command, a plataforma de desenvolvimento da Asana. Hidalgo afirma que uma investigação que, se fosse feita manualmente, estimava que demoraria um a dois meses ficou concluída em cerca de uma semana. Esta diferença de duração corresponde a uma estimativa do responsável e não resulta de uma experiência comparativa realizada por pessoas.
Este caso mostra que, ao avaliar os custos operacionais da IA, vale a pena analisar a forma como se fazem as chamadas ao modelo e como se gere o histórico, tanto quanto o preço por utilização do modelo. A Asana aplicou estas alterações à funcionalidade de operações no browser da StackAI. No futuro, pretende integrar testes nas funcionalidades de avaliação, para que os clientes e as equipas internas possam comparar, em cada configuração, os custos, o tempo de execução e a qualidade das respostas.

コメント