
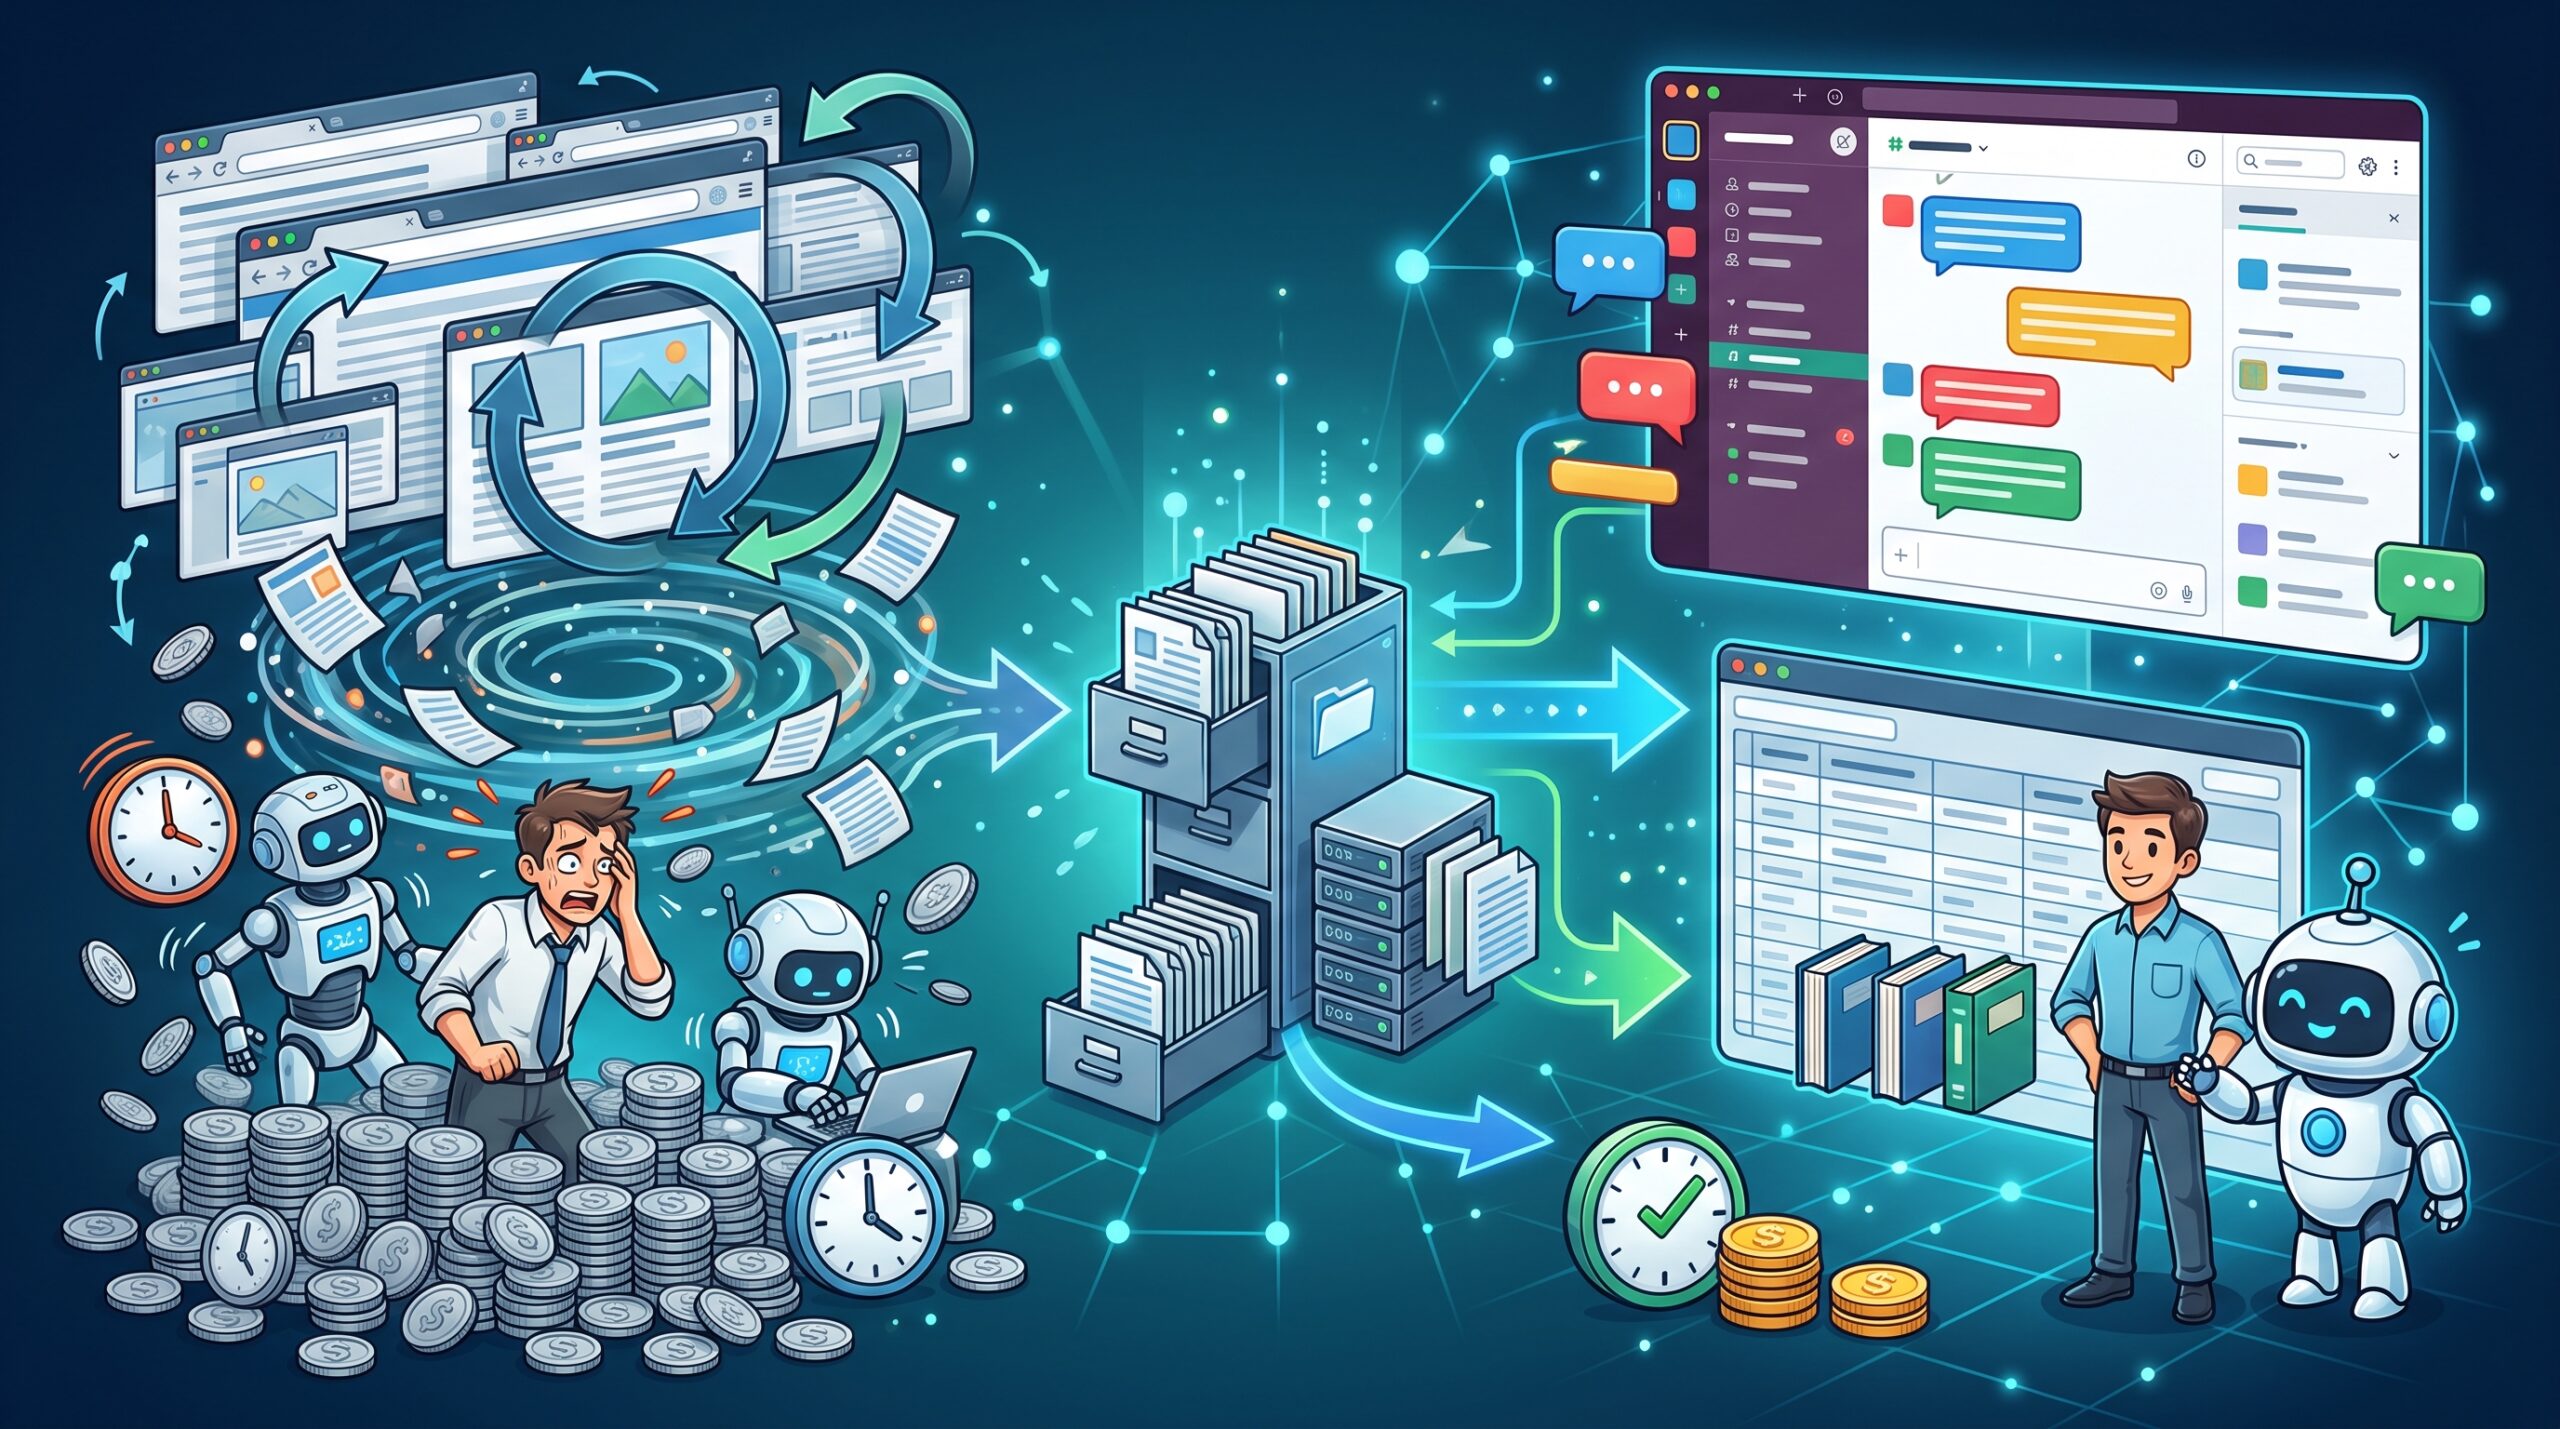
Asana mengumumkan bahwa dalam uji optimalisasi AI pengoperasi browser StackAI, konfigurasi yang menggunakan GPT‑6.1 Sol mencatat estimasi biaya model rata-rata sebesar 0,47 dolar per eksekusi, dengan waktu eksekusi sekitar 4 menit. Dibandingkan konfigurasi produksi awal, biayanya turun menjadi sekitar 1/76 dan prosesnya sekitar 5 kali lebih cepat.
Pemangkasan hingga 1/76 bukan semata-mata hasil dari mengganti model
Membuka halaman web, mencari informasi yang dibutuhkan, lalu mengisi formulir. Agen browser yang menjalankan tugas-tugas seperti ini berbeda dari AI yang hanya menghasilkan satu jawaban: agen tersebut memanggil model berkali-kali selama bekerja. Di StackAI, yang diakuisisi Asana, pelanggan dapat menyusun alur otomatisasi yang melibatkan beberapa aplikasi bisnis tanpa menulis kode.
Hal yang perlu dicermati dari angka-angka ini adalah bahwa pemangkasan sekitar 1/76 mencakup perbaikan alur kerja sekaligus perubahan model. Bahkan dengan model B yang digunakan pada awalnya, optimalisasi menurunkan estimasi biaya model per eksekusi dari lebih dari 36,21 dolar menjadi 1,24 dolar. Setelah itu, penggunaan GPT‑6.1 Sol menurunkannya lagi menjadi 0,47 dolar. Sebagian besar penghematan sudah dicapai sebelum model diganti.
Selain itu, biaya yang dimaksud di sini adalah estimasi biaya penggunaan model. Ini bukan berarti total biaya, termasuk biaya server serta tenaga kerja untuk pengembangan dan operasional, turun dengan persentase yang sama.
Jika riwayat dipangkas terlalu banyak, AI akan membaca ulang halaman yang sama
Frank Hidalgo, CTO StackAI yang memimpin penelitian ini, meminta GPT‑6 Astra dari Codex untuk menganalisis kode dan menguji usulan perbaikan. Salah satu masalah yang ditemukan adalah isi halaman dan riwayat tangkapan layar dikirim ulang setiap kali model dimintai respons. Instruksi tetap dan informasi sejenis memang dapat digunakan kembali, tetapi mekanisme yang sama tidak diterapkan pada riwayat penelusuran yang terus bertambah.
Selain itu, gambar lama dihapus dan teks dipangkas hampir di setiap langkah. Jika riwayat sering diubah, cache yang menggunakan kembali masukan yang telah diproses sebelumnya untuk menekan biaya akan sulit bekerja secara efektif. Jika terlalu banyak informasi dihapus, AI juga bisa kembali mengunjungi halaman yang sudah dibacanya. Upaya mempersingkat masukan justru berpotensi menambah pekerjaan.
Gambar tidak dihapus setiap kali; rapikan setelah terkumpul 20 gambar
Dalam pengujian, batas penyimpanan riwayat ditetapkan pada 120.000 dan 480.000 karakter, kebijakan cache dan pengelolaan gambar diubah, lalu dilakukan total 144 eksekusi dengan empat model. Tugasnya sama untuk semua pengujian: mengumpulkan enam informasi untuk masing-masing dari 32 buku dari katalog demo publik.
Konfigurasi GPT‑6.1 Sol yang dioptimalkan menggunakan metode menampung hingga 20 tangkapan layar, lalu hanya menyisakan gambar terbaru. Alih-alih menghapus gambar setiap kali, semuanya dirapikan sekaligus sehingga masa penggunaan ulang riwayat tanpa perubahan menjadi lebih panjang.
Bahkan jika hanya membandingkan GPT‑6.1 Sol, peninjauan ulang cache dan pengelolaan gambar dalam kondisi dengan batas penyimpanan riwayat yang lebih besar menurunkan estimasi biaya model dari 1,97 dolar menjadi 0,47 dolar. Setelah optimalisasi, 89% masukan diproses melalui cache, dengan biaya untuk bagian tersebut sebesar 5% dari biaya masukan biasa. Yang efektif bukan sekadar mengurangi informasi, melainkan merancang agar informasi yang dipertahankan lebih mudah digunakan kembali.
Bukan hanya biaya, tingkat penyelesaian pun berubah
Pengelolaan riwayat juga memengaruhi kemampuan menyelesaikan tugas. Dengan GPT‑6.1 Sol dan batas penyimpanan yang kecil, jawaban berhasil dihasilkan hanya dalam 3 dari 18 eksekusi. Dalam kondisi dengan batas yang lebih besar, jawaban dihasilkan dalam seluruh 18 eksekusi, dan semuanya dinyatakan benar.
Namun, perbandingan sekitar 1/76 dan sekitar 5 kali lebih cepat perlu dicermati. Dalam konfigurasi awal, ada eksekusi yang mencapai batas jumlah langkah sebelum selesai, sehingga angka biaya lebih dari 36,21 dolar dan waktu lebih dari 22,5 menit menunjukkan nilai minimum. Angka utama pembanding juga merupakan rata-rata dari tiga eksekusi untuk setiap konfigurasi, dan berasal dari tugas pengumpulan informasi ini. Belum dapat dipastikan bahwa persentase penghematan yang sama akan tercapai di situs atau pekerjaan lain.
Setiap model juga memiliki keunggulan yang berbeda. Setelah optimalisasi, Model C membutuhkan biaya 0,66 dolar dan waktu 3,5 menit. Biayanya lebih tinggi daripada GPT‑6.1 Sol yang membutuhkan 0,47 dolar dan sekitar 4 menit, tetapi waktu eksekusinya lebih singkat. Saat menerapkan model, biaya dan kecepatan perlu dibandingkan secara terpisah.
AI menjalankan eksperimen, manusia memeriksa perubahannya
Kali ini, GPT‑6 Astra tidak hanya mengusulkan perbaikan, tetapi juga melakukan perubahan kode dan menjalankan pengujian untuk menyamakan kondisi eksperimen. Sesi model lain meninjau pekerjaan tersebut, sementara permintaan dan hasilnya dicatat di Command, platform pengembangan Asana. Hidalgo mengatakan bahwa penelitian yang diperkirakan akan memakan waktu 1–2 bulan jika dilakukan secara manual selesai dalam sekitar satu minggu. Perbedaan durasi ini merupakan perkiraan Hidalgo, bukan hasil eksperimen perbandingan dengan pekerjaan manusia.
Pelajaran dari kasus ini adalah bahwa saat memperhitungkan biaya operasional AI, cara pemanggilan model dan pengelolaan riwayat layak diteliti sama seriusnya dengan harga model. Asana telah menerapkan perubahan ini pada fitur pengoperasi browser StackAI. Ke depannya, Asana berencana menyertakan pengujian dalam fitur evaluasi agar pelanggan dan tim internal dapat membandingkan biaya, waktu eksekusi, dan kualitas jawaban untuk setiap konfigurasi.

コメント