
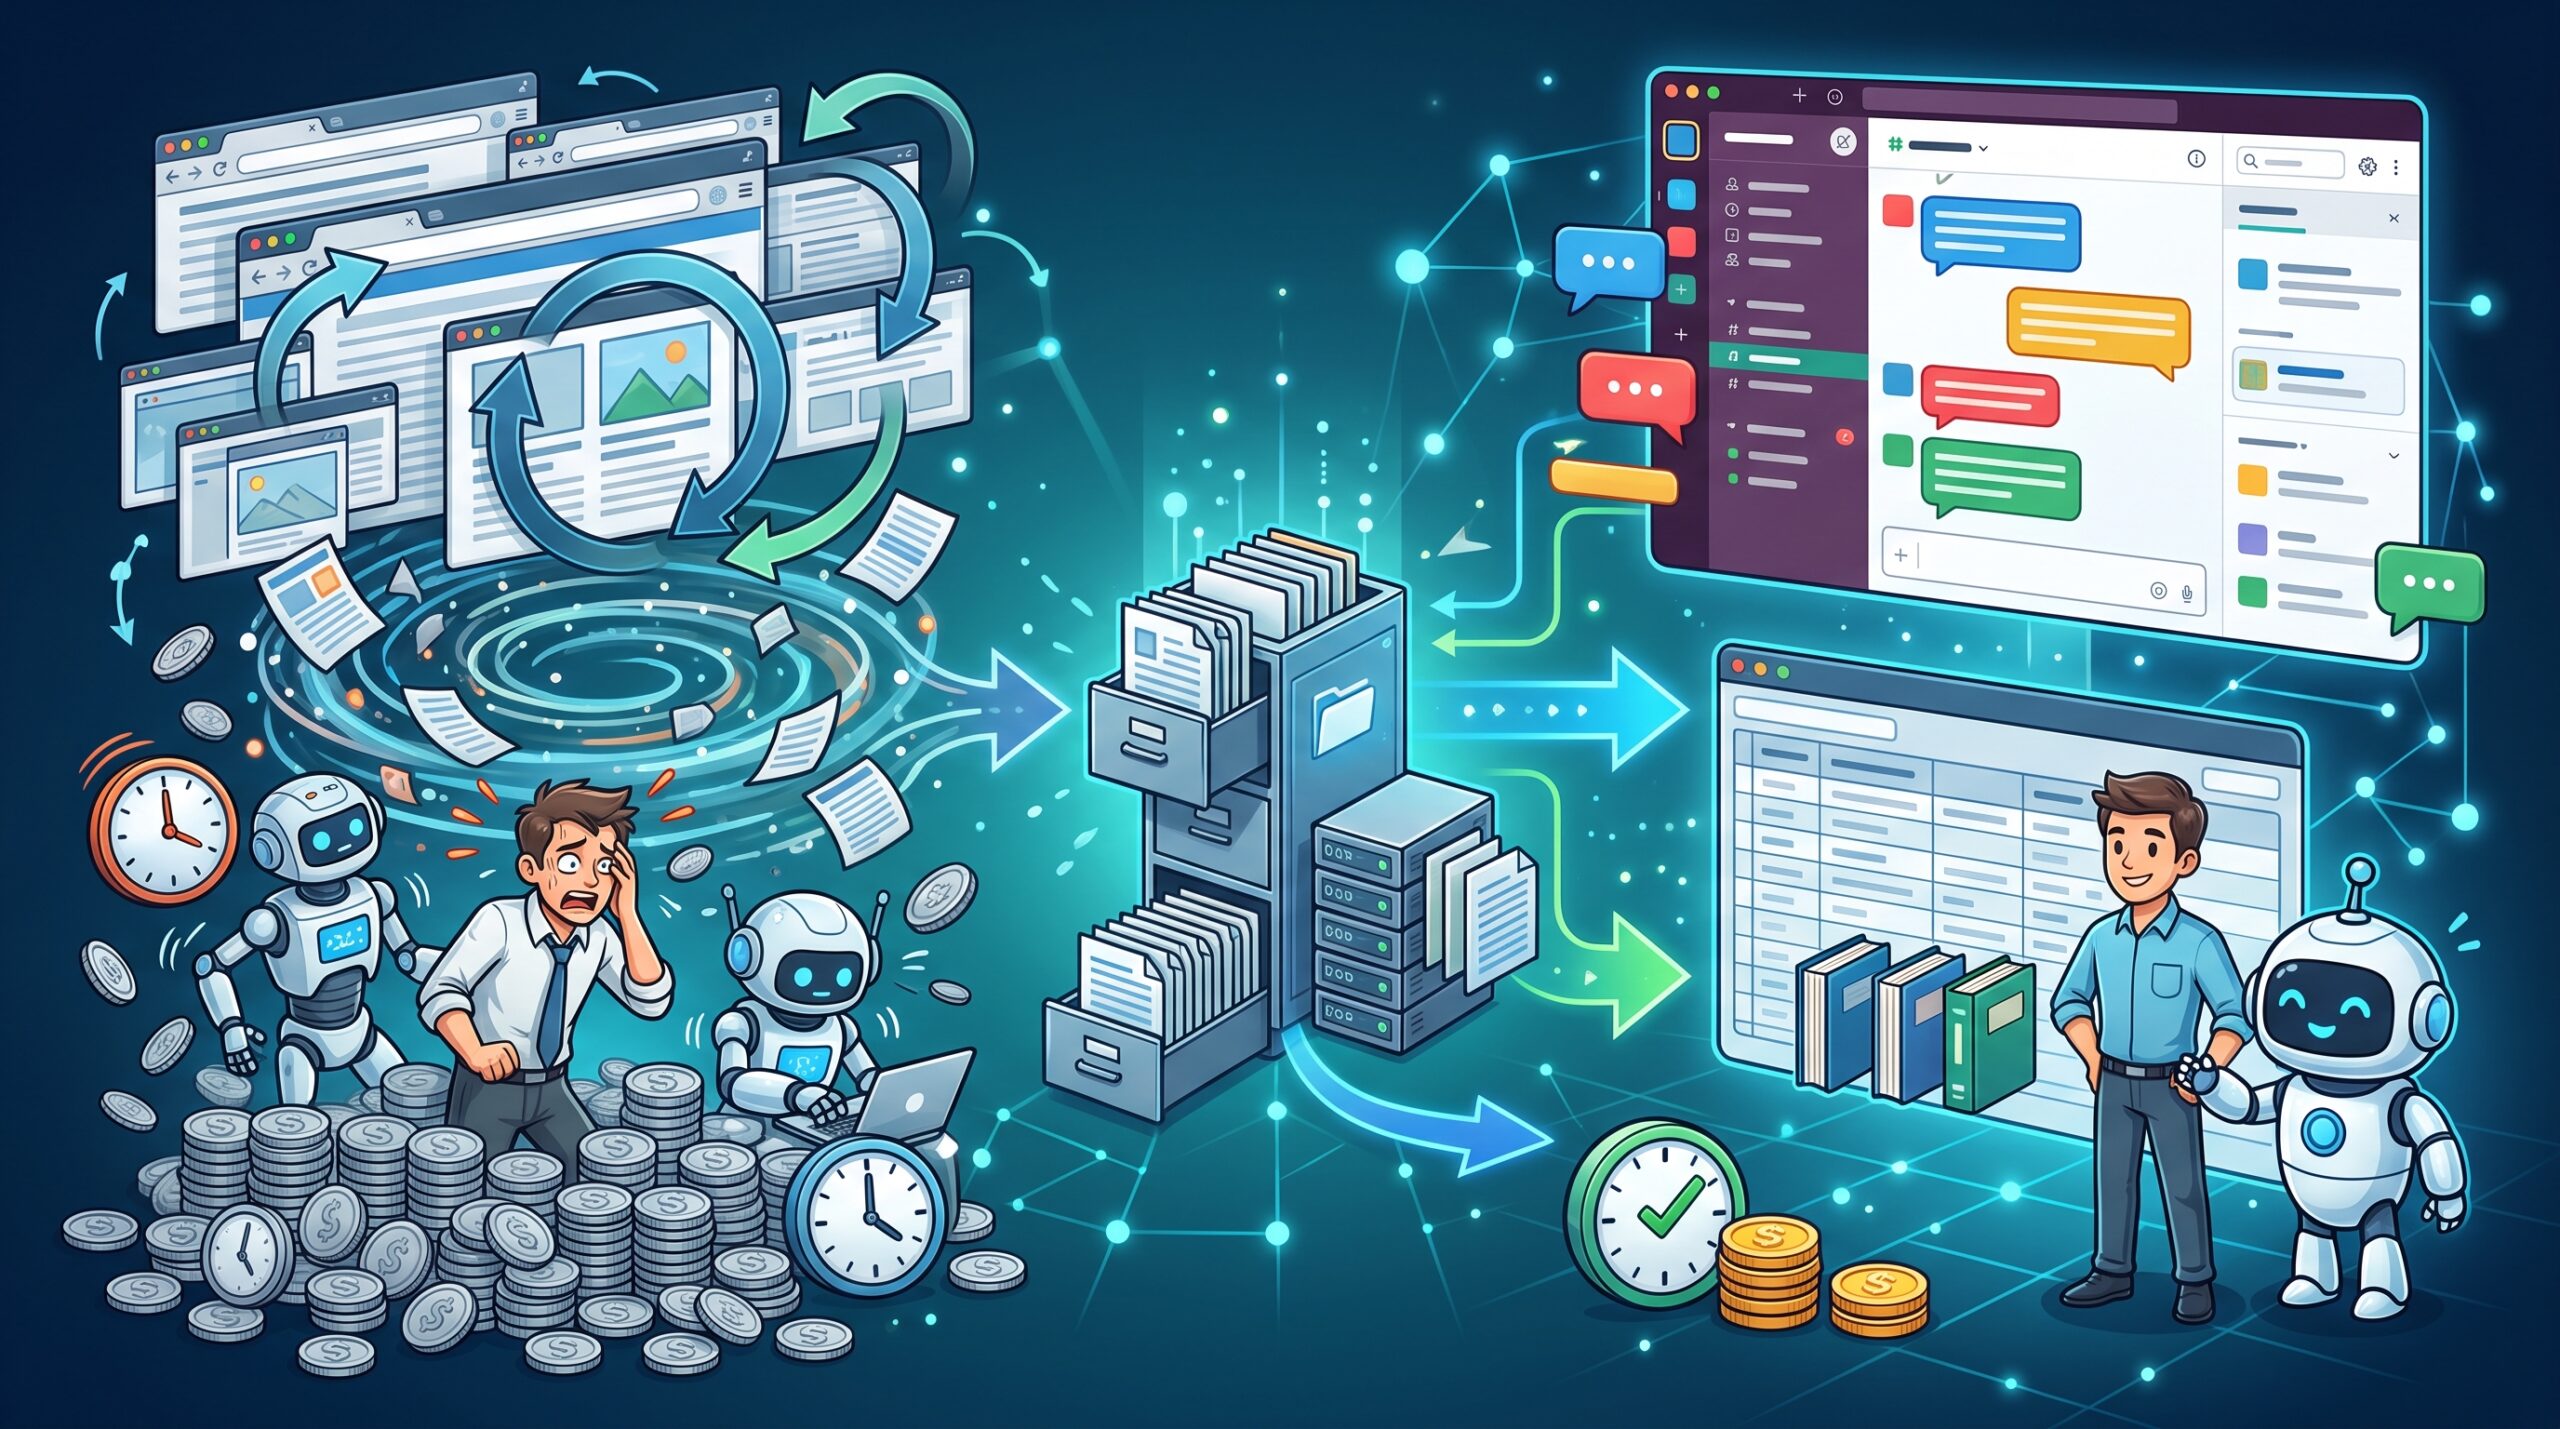
Asana anunció que, en una evaluación para optimizar la IA de navegación web de StackAI, la configuración con GPT‑6.1 Sol alcanzó un coste estimado del modelo de 0,47 dólares por ejecución y un tiempo de ejecución de unos 4 minutos. Frente a la configuración inicial en producción, el coste se redujo a aproximadamente una 76.ª parte y la velocidad de procesamiento se multiplicó por unas cinco.
La reducción a una 76.ª parte no se debe únicamente a cambiar de modelo
Abrir una página web, buscar la información necesaria y rellenar un formulario. A diferencia de una IA que genera una respuesta de una sola vez, los agentes de navegación web que realizan este tipo de tareas invocan el modelo repetidamente durante el proceso. StackAI, adquirida por Asana, permite a los clientes diseñar flujos de automatización que conectan varias aplicaciones empresariales sin escribir código.
Lo importante de estas cifras es que la reducción de aproximadamente una 76.ª parte incluye tanto mejoras en el proceso como un cambio de modelo. Incluso con el modelo B utilizado inicialmente, la optimización redujo el coste estimado del modelo por ejecución de más de 36,21 dólares a 1,24 dólares. Después, al usar GPT‑6.1 Sol, el coste bajó a 0,47 dólares. Una parte importante del ahorro se consiguió antes de cambiar de modelo.
Además, el coste al que se hace referencia aquí es una estimación de las tarifas por uso del modelo. No significa que el coste total, incluidos los gastos de servidor y los costes de personal de desarrollo y operaciones, se haya reducido en la misma proporción.
Si se recorta demasiado el historial, la IA vuelve a leer las mismas páginas
Frank Hidalgo, director de tecnología de StackAI y responsable de la investigación, pidió a GPT‑6 Astra de Codex que analizara el código y comprobara propuestas de mejora. Uno de los problemas detectados era que, cada vez que se consultaba al modelo, se volvían a enviar el texto de las páginas y el historial de capturas de pantalla. Las instrucciones fijas y otros elementos sí se podían reutilizar, pero no se aplicaba el mismo mecanismo al historial de navegación, que no dejaba de crecer.
Además, casi en cada paso se borraban las imágenes antiguas y se recortaba el texto. Cuando el historial se modifica con frecuencia, resulta más difícil aprovechar la caché, que permite reutilizar entradas procesadas previamente para reducir los costes. Si se elimina demasiada información, la IA también puede volver a visitar páginas que ya ha leído. Así, una medida para acortar las entradas podía acabar aumentando el trabajo.
En lugar de borrar las imágenes cada vez, se acumulan 20 y luego se organizan
En las pruebas se fijaron límites de historial de 120.000 y 480.000 caracteres, y se modificaron las políticas de caché y gestión de imágenes. Se realizaron 144 ejecuciones en total con cuatro modelos. La tarea era la misma en todos los casos: recopilar seis datos de cada uno de los 32 libros de un catálogo de demostración público.
La configuración optimizada con GPT‑6.1 Sol acumulaba hasta 20 capturas de pantalla y, después, conservaba solo la más reciente. En vez de borrar imágenes en cada paso, las organizaba en bloque, lo que prolongaba el periodo en que el historial podía reutilizarse sin cambios.
Incluso comparando únicamente GPT‑6.1 Sol, al revisar la caché y la gestión de imágenes con un límite de historial más amplio, el coste estimado del modelo bajó de 1,97 a 0,47 dólares. Tras la optimización, el 89 % de las entradas se procesó mediante la caché, y esa parte costó un 5 % de lo que habría costado como entrada normal. El resultado demuestra la eficacia de diseñar el sistema no solo para reducir la información, sino también para facilitar la reutilización de la que se conserva.
No solo cambió el coste: también mejoró la tasa de finalización
La gestión del historial también influyó en la capacidad de completar las tareas. Con GPT‑6.1 Sol, en las condiciones con un límite de historial reducido solo se generaron respuestas en 3 de 18 ejecuciones. Con un límite más amplio, se generaron respuestas en las 18, y, según se indica, todas fueron correctas.
Sin embargo, conviene matizar la comparación de una reducción a aproximadamente una 76.ª parte y una velocidad unas cinco veces mayor. En la configuración inicial se incluyen ejecuciones que alcanzaron el límite de pasos antes de completar la tarea, por lo que los valores de más de 36,21 dólares y más de 22,5 minutos son mínimos. Además, las principales cifras comparativas son promedios de tres ejecuciones por configuración y corresponden a esta tarea de recopilación de información. No permiten concluir que se obtendría la misma reducción en otras webs o tareas.
Cada modelo tiene también sus puntos fuertes. Tras la optimización, el modelo C costó 0,66 dólares y tardó 3,5 minutos: fue más caro que GPT‑6.1 Sol, con un coste de 0,47 dólares y un tiempo de unos 4 minutos, pero terminó antes. Al implantarlos, es necesario comparar el coste y la velocidad por separado.
La IA ejecuta los experimentos y las personas revisan los cambios
En esta ocasión, GPT‑6 Astra no solo propuso mejoras, sino que también modificó el código y ejecutó las pruebas para mantener constantes las condiciones experimentales. Otra sesión del modelo revisó el trabajo, y las solicitudes y los resultados se registraron en Command, la plataforma de desarrollo de Asana. Hidalgo afirma que una investigación que, si se hubiera realizado manualmente, habría llevado entre uno y dos meses se completó en aproximadamente una semana. Esta diferencia de tiempo es una estimación del responsable, no el resultado de un experimento comparativo realizado por personas.
Este caso muestra que, al analizar los costes operativos de la IA, merece la pena examinar cómo se realizan las llamadas y cómo se gestiona el historial, tanto como el precio unitario del modelo. Asana ha incorporado estos cambios a las funciones de navegación web de StackAI. En el futuro, prevé integrar pruebas en sus funciones de evaluación para que los clientes y los equipos internos puedan comparar el coste, el tiempo de ejecución y la calidad de las respuestas según cada configuración.

コメント