
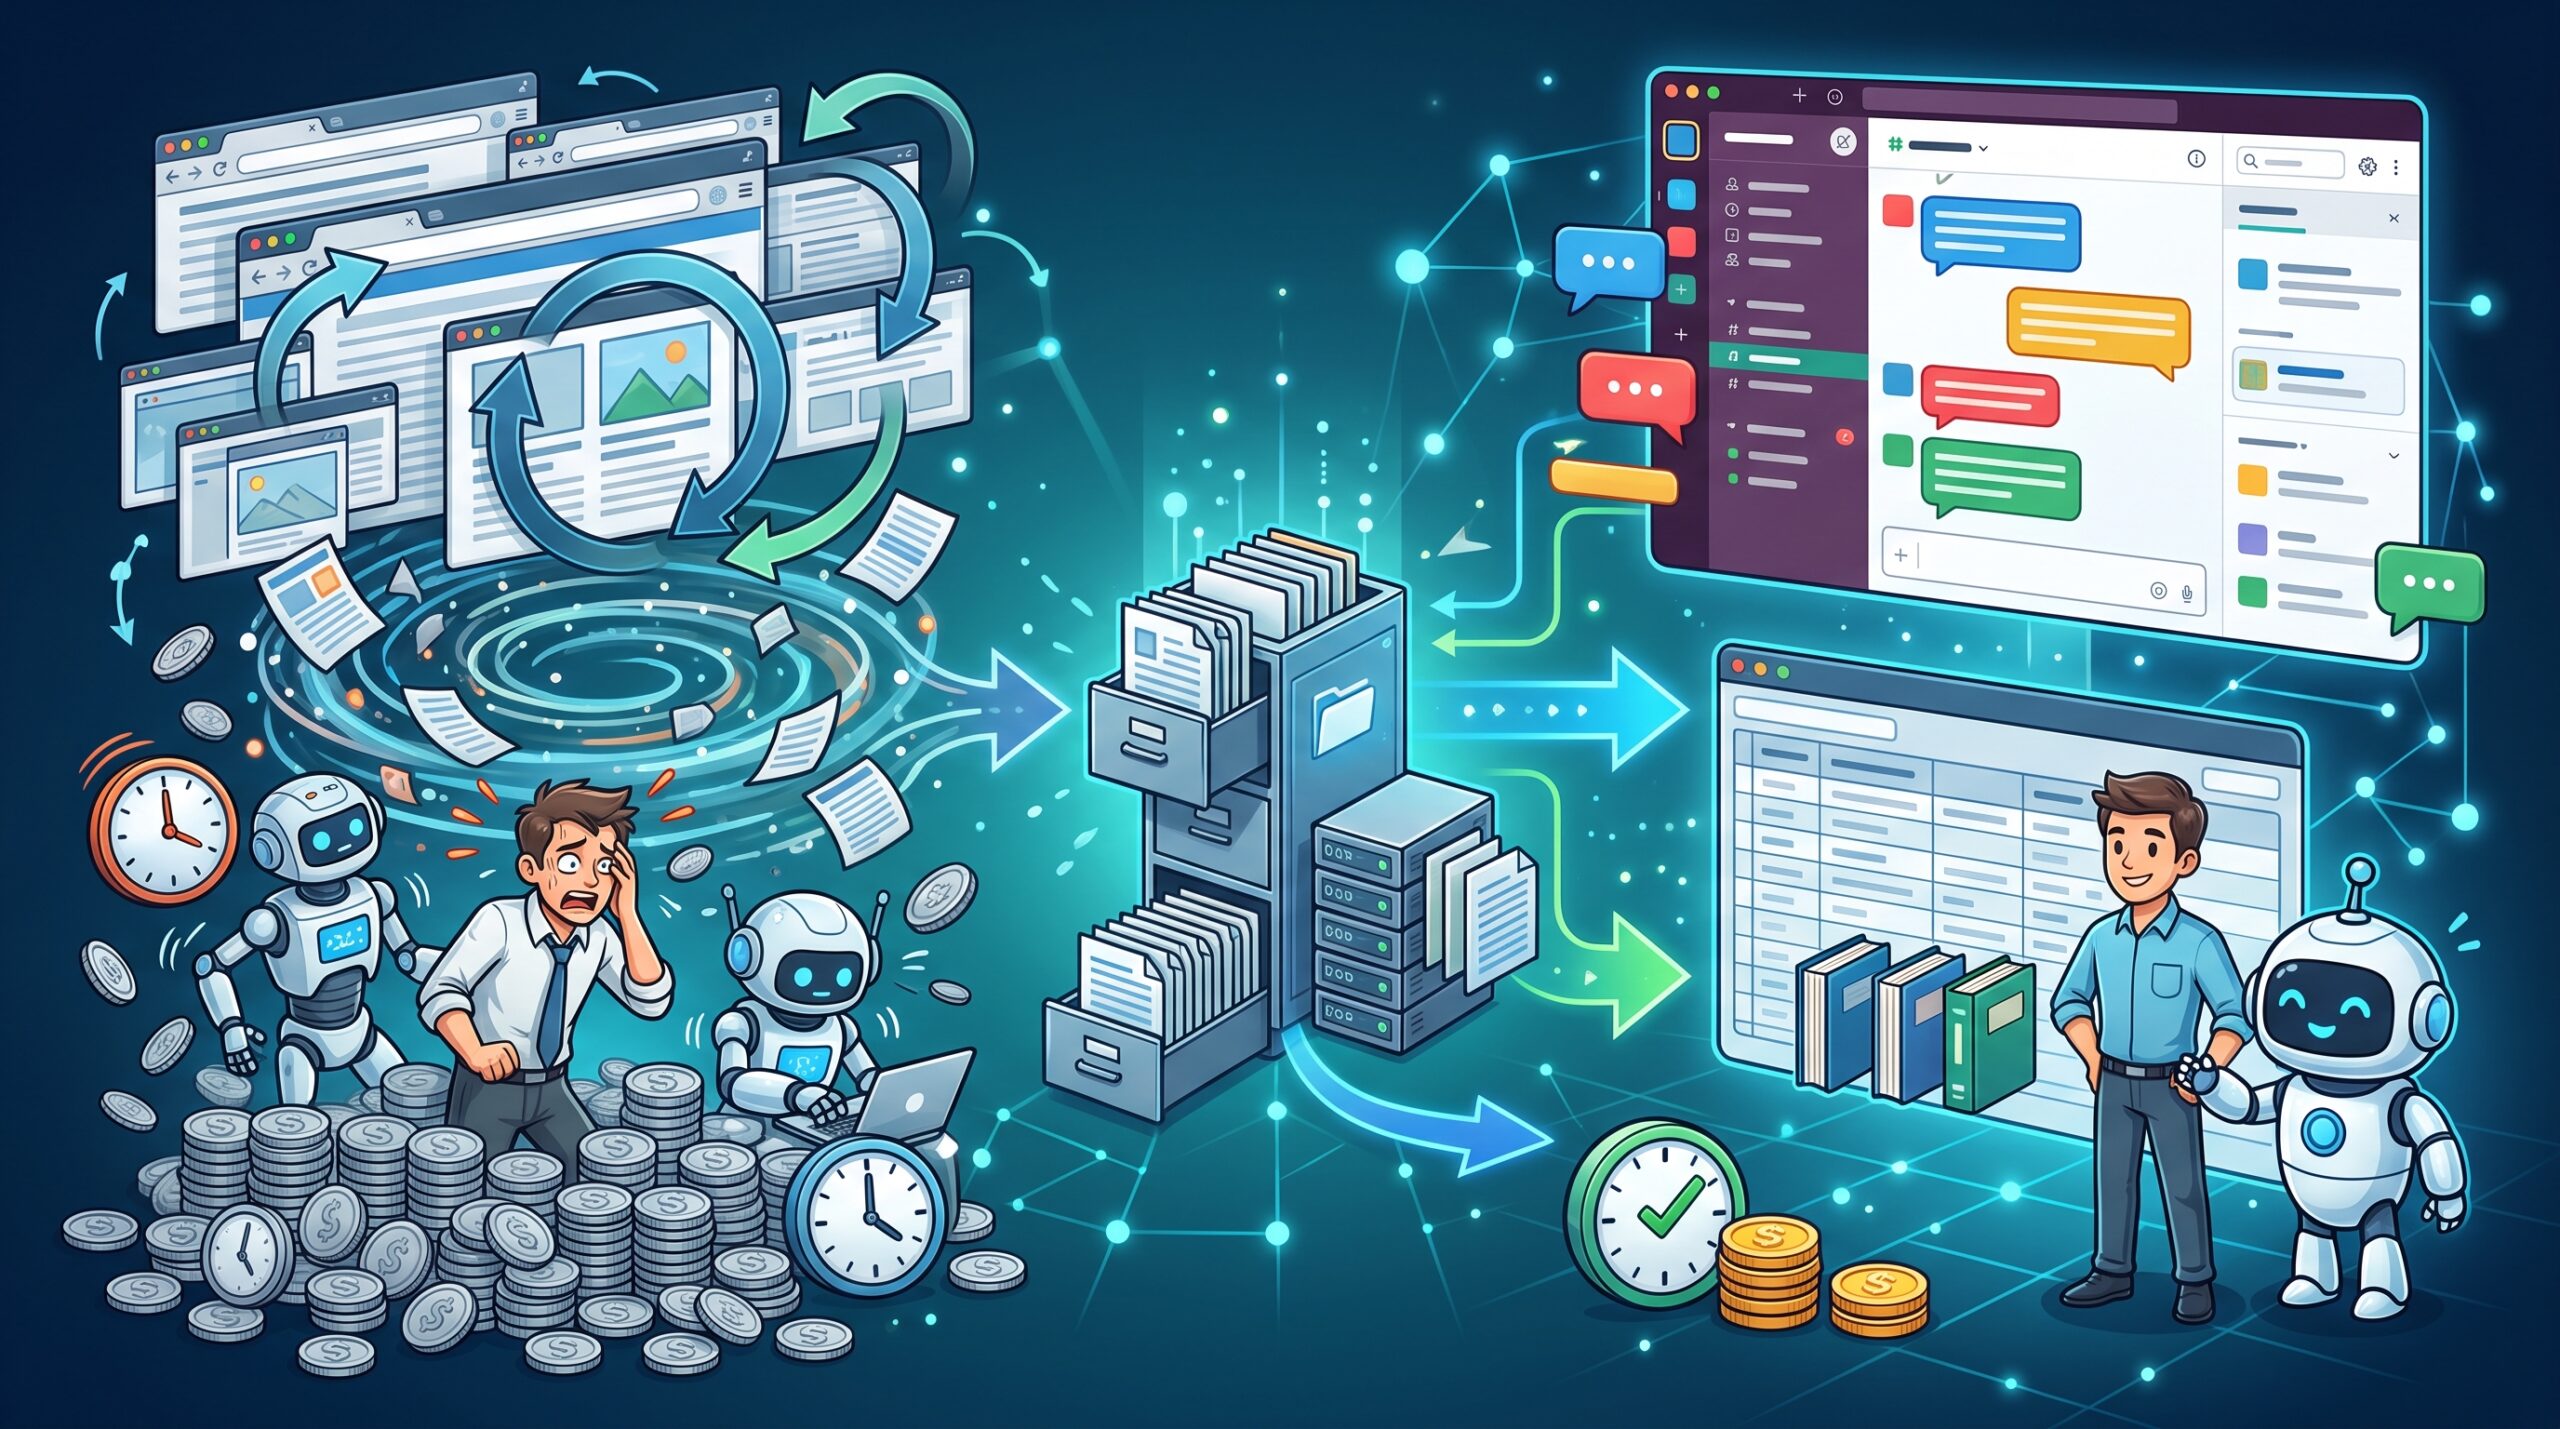
Asana gab bekannt, dass bei einem Test zur Optimierung der Browser-KI von StackAI eine Konfiguration mit GPT‑6.1 Sol geschätzte Modellkosten von durchschnittlich 0,47 US-Dollar pro Durchlauf und eine Ausführungszeit von rund 4 Minuten erreichte. Gegenüber der ursprünglichen Produktivkonfiguration sanken die Kosten auf etwa ein Sechsundsiebzigstel, während die Verarbeitung rund fünfmal schneller wurde.
Die Kostensenkung auf ein Sechsundsiebzigstel ist nicht allein dem Modellwechsel zu verdanken
Eine Webseite öffnen, die benötigten Informationen suchen und ein Formular ausfüllen: Browser-Agenten, die solche Aufgaben übernehmen, rufen während der Arbeit wiederholt ein Modell auf – anders als eine KI, die eine Antwort in einem Schritt generiert. Bei StackAI, das von Asana übernommen wurde, können Kunden Automatisierungsabläufe über mehrere Geschäftsanwendungen hinweg erstellen, ohne selbst Code zu schreiben.
Wichtig bei den vorgelegten Zahlen ist, dass die Senkung auf etwa ein Sechsundsiebzigstel sowohl Verbesserungen des Ablaufs als auch einen Modellwechsel umfasst. Bereits mit dem ursprünglich verwendeten Modell B sanken die geschätzten Modellkosten dank Optimierungen von mindestens 36,21 US-Dollar auf 1,24 US-Dollar pro Durchlauf. Mit GPT‑6.1 Sol gingen sie anschließend auf 0,47 US-Dollar zurück. Ein großer Teil der Einsparungen wurde also schon vor dem Modellwechsel erzielt.
Bei den hier genannten Kosten handelt es sich zudem um Schätzwerte für die Modellnutzung. Das bedeutet nicht, dass die Gesamtkosten einschließlich Serverkosten sowie Personalaufwand für Entwicklung und Betrieb im gleichen Verhältnis gesunken sind.
Wer den Verlauf zu stark kürzt, zwingt die KI dazu, dieselbe Seite erneut zu lesen
Frank Hidalgo, CTO von StackAI und Leiter der Untersuchung, bat GPT‑6 Astra in Codex, den Code zu analysieren und Verbesserungsvorschläge zu überprüfen. Eines der gefundenen Probleme: Der Seiteninhalt und der Verlauf mit Screenshots wurden bei jeder Anfrage an das Modell erneut mitgesendet. Feste Anweisungen und Ähnliches ließen sich zwar wiederverwenden, doch für den ständig wachsenden Browserverlauf galt das nicht.
Außerdem wurden bei fast jedem Schritt alte Bilder gelöscht und Text gekürzt. Wird der Verlauf häufig umgeschrieben, kann der Cache, der bereits verarbeitete Eingaben wiederverwendet und so Kosten spart, weniger effektiv arbeiten. Werden zu viele Informationen gelöscht, kann es auch passieren, dass die KI bereits gelesene Seiten erneut aufruft. Der Versuch, Eingaben zu verkürzen, konnte so paradoxerweise zusätzliche Arbeit verursachen.
Bilder nicht jedes Mal löschen, sondern erst nach 20 Screenshots aufräumen
Im Test wurden die Obergrenzen für den Verlauf auf 120.000 beziehungsweise 480.000 Zeichen festgelegt; außerdem änderte man die Richtlinien für Cache und Bildverwaltung. Mit vier Modellen gab es insgesamt 144 Durchläufe. Die Aufgabe war jeweils dieselbe: Für 32 Bücher aus einem öffentlichen Demokatalog sollten jeweils sechs Informationen gesammelt werden.
In der optimierten Konfiguration mit GPT‑6.1 Sol wurden zunächst bis zu 20 Screenshots gesammelt; anschließend blieb nur der neueste erhalten. Statt die Bilder jedes Mal zu löschen, wurden sie gebündelt bereinigt. So ließ sich der Zeitraum verlängern, in dem der Verlauf unverändert wiederverwendet werden konnte.
Auch beim alleinigen Vergleich von GPT‑6.1 Sol sanken die geschätzten Modellkosten von 1,97 auf 0,47 US-Dollar, wenn bei erweitertem Verlaufslimit Cache und Bildverwaltung angepasst wurden. Nach der Optimierung liefen 89 Prozent der Eingaben über den Cache; für diesen Anteil fielen nur fünf Prozent der Kosten regulärer Eingaben an. Entscheidend war nicht, einfach Informationen zu reduzieren, sondern sie so zu verwalten, dass sie sich leichter wiederverwenden ließen.
Nicht nur die Kosten, auch die Erfolgsquote änderte sich
Das Verlaufsmanagement beeinflusste auch, ob die Aufgabe abgeschlossen werden konnte. Bei GPT‑6.1 Sol wurde unter der Bedingung mit niedrigerem Verlaufslimit nur in drei von 18 Fällen eine Antwort generiert. Bei höherem Limit gab es in allen 18 Fällen eine Antwort, und den Angaben zufolge waren sämtliche Ergebnisse korrekt.
Der Vergleich von etwa einem Sechsundsiebzigstel der Kosten und einer rund fünffachen Geschwindigkeit ist jedoch mit Vorsicht zu betrachten. In der ursprünglichen Konfiguration erreichten manche Durchläufe die Höchstzahl an Schritten, bevor sie abgeschlossen waren. Die Angaben von mindestens 36,21 US-Dollar und mindestens 22,5 Minuten markieren daher Untergrenzen. Auch die zentralen Vergleichswerte sind Durchschnittswerte aus jeweils drei Durchläufen pro Konfiguration und beziehen sich auf die Informationsbeschaffungsaufgabe in diesem Test. Daraus lässt sich nicht ableiten, dass sich bei anderen Webseiten oder Arbeitsabläufen dieselbe Einsparungsquote erzielen lässt.
Auch die Stärken der einzelnen Modelle unterscheiden sich. Das optimierte Modell C kam auf 0,66 US-Dollar und 3,5 Minuten. Es war damit teurer als GPT‑6.1 Sol mit 0,47 US-Dollar und rund 4 Minuten, führte die Aufgabe aber schneller aus. Bei der Einführung sollten Kosten und Geschwindigkeit daher getrennt verglichen werden.
Die KI führt Experimente durch, Menschen prüfen die Änderungen
GPT‑6 Astra lieferte nicht nur Verbesserungsvorschläge, sondern änderte auch den Code, um die Versuchsbedingungen zu vereinheitlichen, und führte die Tests aus. Eine separate Modellsitzung überprüfte die Arbeit; Anfragen und Ergebnisse wurden in Asanas Entwicklungsplattform Command protokolliert. Hidalgo zufolge dauerte die Untersuchung rund eine Woche – bei manueller Durchführung hätte er sie auf ein bis zwei Monate geschätzt. Dieser Zeitvergleich beruht auf seiner Einschätzung und nicht auf einem Vergleichsexperiment mit menschlicher Arbeit.
Der Fall zeigt, dass sich bei den Betriebskosten von KI neben den Modellpreisen auch die Aufrufweise und der Umgang mit dem Verlauf näher untersuchen lassen. Asana hat die Änderungen in die Browsersteuerungsfunktion von StackAI übernommen. Künftig sollen Tests in die Evaluierungsfunktion integriert werden, damit Kunden und interne Teams die Kosten, Ausführungszeit und Antwortqualität verschiedener Konfigurationen vergleichen können.

コメント