
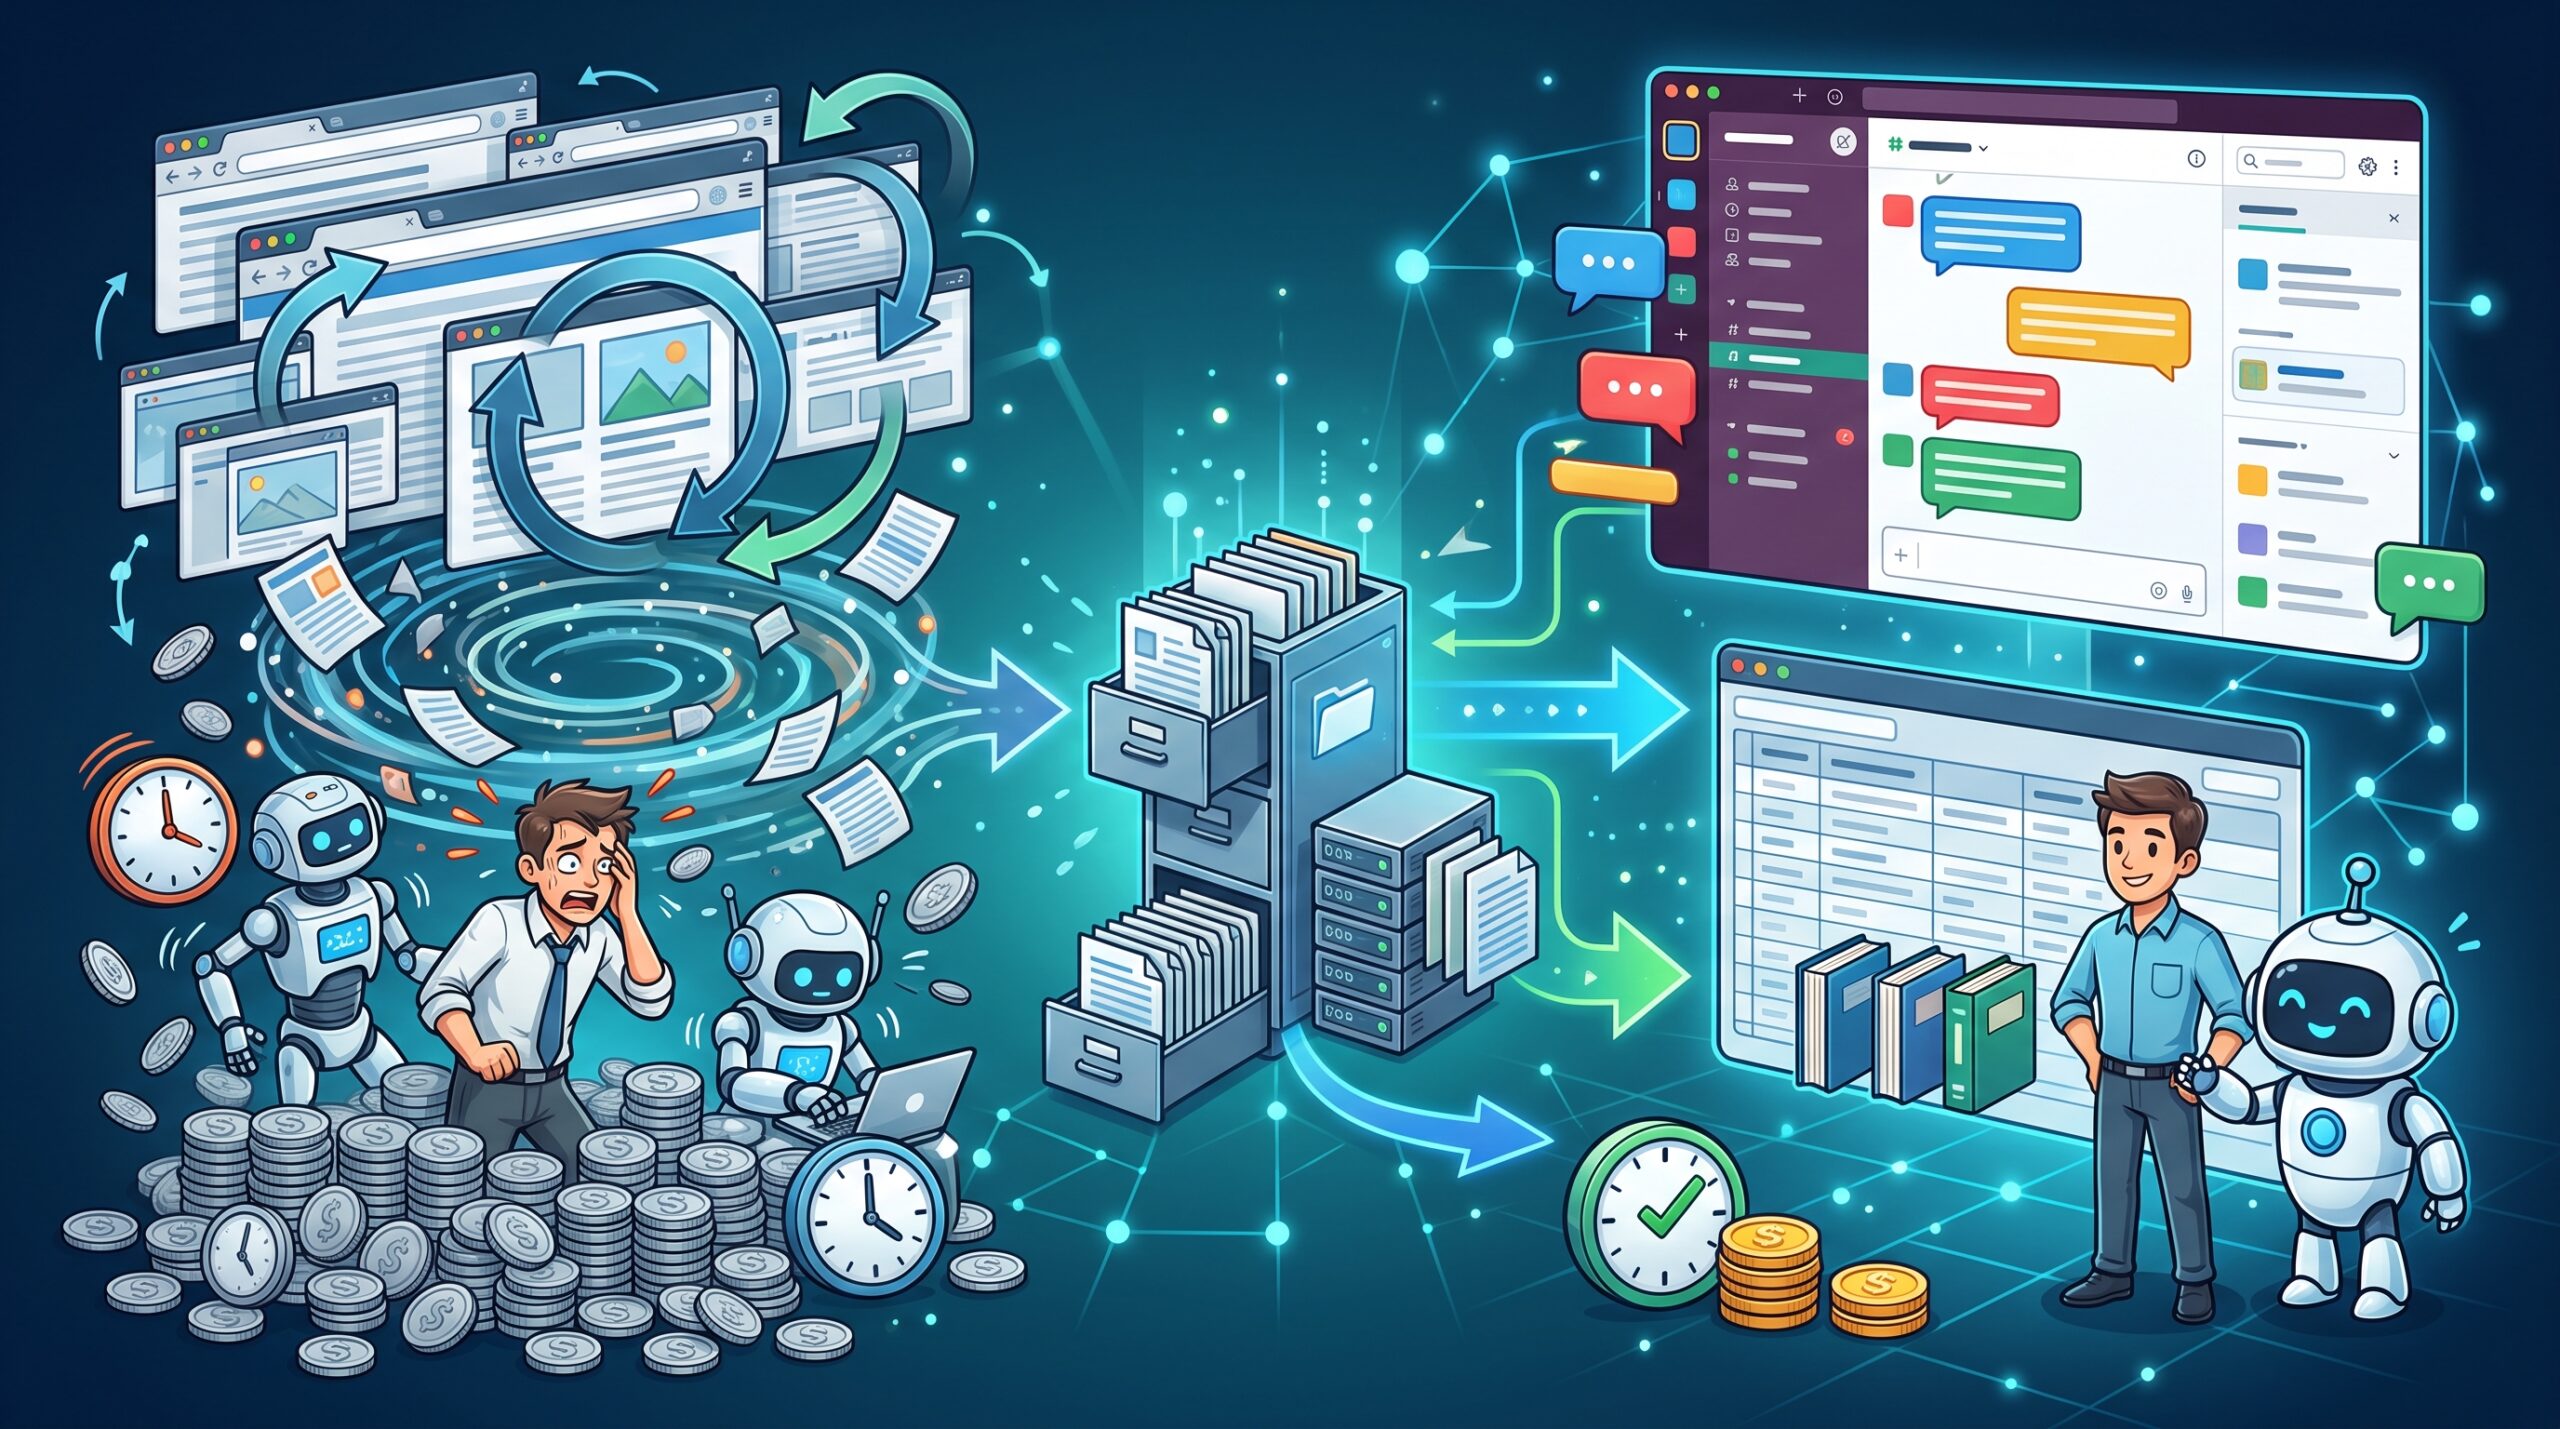
Asana ने घोषणा की कि StackAI के ब्राउज़र-ऑपरेशन AI को बेहतर बनाने के परीक्षण में GPT‑6.1 Sol वाले सेटअप की अनुमानित मॉडल लागत औसतन 0.47 डॉलर प्रति रन रही और इसे पूरा होने में करीब 4 मिनट लगे। शुरुआती उत्पादन सेटअप की तुलना में लागत लगभग 76 गुना कम हुई और प्रक्रिया करीब 5 गुना तेज़ हुई।
लागत 76 गुना घटने का श्रेय सिर्फ़ मॉडल बदलने को नहीं
वेबपेज खोलना, ज़रूरी जानकारी ढूँढ़ना और फ़ॉर्म भरना—ऐसे काम करने वाले ब्राउज़र एजेंट एक बार जवाब तैयार करने वाले AI से अलग होते हैं: काम के दौरान वे मॉडल को बार-बार कॉल करते हैं। Asana द्वारा अधिग्रहित StackAI में ग्राहक बिना कोड लिखे, कई व्यावसायिक ऐप्स में फैले स्वचालन के चरण तैयार कर सकते हैं।
इस आँकड़े में ध्यान देने वाली बात यह है कि लगभग 76 गुना की कटौती में प्रक्रिया के सुधार और मॉडल में बदलाव, दोनों शामिल हैं। शुरुआत में इस्तेमाल किए गए मॉडल B के साथ भी, अनुकूलन से अनुमानित मॉडल लागत प्रति रन 36.21 डॉलर से अधिक से घटकर 1.24 डॉलर हो गई। इसके बाद GPT‑6.1 Sol इस्तेमाल करने पर यह 0.47 डॉलर रह गई। लागत में बड़ी कटौती मॉडल बदलने से पहले ही हासिल हो चुकी थी।
यहाँ बताई गई लागत मॉडल के इस्तेमाल की अनुमानित फ़ीस है। इसका मतलब यह नहीं है कि सर्वर खर्च या विकास और संचालन के कर्मचारियों की लागत सहित कुल खर्च भी इसी अनुपात में घटा।
इतिहास बहुत ज़्यादा हटाने पर AI उसी पेज को दोबारा पढ़ सकता है
जाँच का नेतृत्व करने वाले StackAI के CTO Frank Hidalgo ने Codex के GPT‑6 Astra से कोड का विश्लेषण और सुधार प्रस्तावों की जाँच करने को कहा। सामने आई समस्याओं में से एक यह थी कि हर बार मॉडल से संपर्क करने पर पेज का पाठ और स्क्रीनशॉट का इतिहास फिर से भेजा जा रहा था। स्थिर निर्देशों जैसी चीज़ों का दोबारा इस्तेमाल हो रहा था, लेकिन लगातार बढ़ते ब्राउज़िंग इतिहास पर वही तरीका लागू नहीं था।
इसके अलावा, लगभग हर चरण पर पुरानी छवियाँ हटाई जा रही थीं और पाठ को छोटा किया जा रहा था। इतिहास को बार-बार बदलने से कैश का असर घटता है—कैश पहले से संसाधित इनपुट का दोबारा इस्तेमाल करके लागत कम करता है। बहुत अधिक जानकारी मिटाने पर AI उस पेज पर फिर जा सकता है जिसे वह पहले ही पढ़ चुका हो। इस तरह इनपुट छोटा करने की कोशिश उलटे काम बढ़ा सकती थी।
हर बार छवियाँ हटाने के बजाय, 20 जमा होने पर उन्हें व्यवस्थित करना
परीक्षण में इतिहास की अधिकतम सीमा 1,20,000 और 4,80,000 अक्षरों पर तय की गई और कैश तथा छवि प्रबंधन की नीतियाँ बदली गईं। चार मॉडलों पर कुल 144 रन किए गए। सभी में एक ही काम था: सार्वजनिक डेमो कैटलॉग से 32 पुस्तकों की जानकारी जुटाना, हर पुस्तक के लिए छह बिंदुओं पर।
अनुकूलित GPT‑6.1 Sol सेटअप में स्क्रीनशॉट 20 तक जमा किए गए और फिर केवल नवीनतम एक को रखा गया। हर बार छवियाँ हटाने के बजाय उन्हें एक साथ व्यवस्थित करने से इतिहास को बदले बिना दोबारा इस्तेमाल करने की अवधि बढ़ी।
सिर्फ़ GPT‑6.1 Sol की तुलना करने पर भी, इतिहास की बड़ी सीमा वाले सेटअप में कैश और छवि प्रबंधन की समीक्षा करने से अनुमानित मॉडल लागत 1.97 डॉलर से घटकर 0.47 डॉलर हो गई। अनुकूलन के बाद 89% इनपुट कैश के ज़रिए आया और उस हिस्से की फ़ीस सामान्य इनपुट लागत का 5% थी। केवल जानकारी घटाना नहीं, बल्कि बची हुई जानकारी को आसानी से दोबारा इस्तेमाल करने लायक बनाना प्रभावी रहा।
सिर्फ़ कम लागत नहीं, काम पूरा होने की दर भी बदली
इतिहास प्रबंधन का असर इस बात पर भी पड़ा कि काम पूरा हो पाता है या नहीं। GPT‑6.1 Sol में, कम सीमा वाले सेटअप में 18 में से केवल 3 बार जवाब तैयार हुआ। बड़ी सीमा वाले सेटअप में सभी 18 बार जवाब तैयार हुआ और बताया गया कि हर बार परिणाम सही था।
हालाँकि, लगभग 76 गुना कम लागत और लगभग 5 गुना तेज़ी की तुलना को सावधानी से देखना चाहिए। शुरुआती सेटअप में कुछ रन अधिकतम चरण सीमा तक पहुँच गए, इससे पहले कि काम पूरा होता; इसलिए 36.21 डॉलर से अधिक की लागत और 22.5 मिनट से अधिक का समय न्यूनतम आँकड़े हैं। मुख्य तुलनात्मक आँकड़े भी हर सेटअप के तीन रनों का औसत हैं और इस जानकारी-संग्रह कार्य में मिले नतीजे हैं। इससे यह निष्कर्ष नहीं निकाला जा सकता कि दूसरी साइटों या कामों में भी कटौती की दर समान होगी।
हर मॉडल की खूबियाँ भी अलग हैं। अनुकूलन के बाद मॉडल C ने 0.66 डॉलर और 3.5 मिनट लिए। GPT‑6.1 Sol के 0.47 डॉलर और करीब 4 मिनट की तुलना में इसकी लागत अधिक थी, लेकिन इसे चलने में कम समय लगा। लागू करते समय लागत और गति की अलग-अलग तुलना करना ज़रूरी है।
AI प्रयोग चलाए और इंसानों ने बदलावों की समीक्षा की
इस मामले में GPT‑6 Astra ने सुधार प्रस्ताव देने के साथ-साथ, प्रयोग की परिस्थितियाँ समान रखने के लिए कोड में बदलाव और सत्यापन भी किया। एक अलग मॉडल सत्र ने काम की समीक्षा की और अनुरोधों तथा नतीजों को Asana के विकास प्लेटफ़ॉर्म Command में दर्ज किया गया। Hidalgo के अनुसार, जिस जाँच में हाथ से काम करने पर 1–2 महीने लगने का अनुमान था, वह करीब एक हफ़्ते में पूरी हो गई। समय का यह अंतर संबंधित व्यक्ति का अनुमान है, न कि हाथ से किए गए तुलनात्मक प्रयोग का नतीजा।
इस उदाहरण से पता चलता है कि AI की संचालन लागत पर विचार करते समय, मॉडल की प्रति-इकाई कीमत जितनी ही अहम गुंजाइश इस बात की जाँच में भी है कि मॉडल को कैसे कॉल किया जाता है और उसका इतिहास कैसे रखा जाता है। Asana ने ये बदलाव StackAI के ब्राउज़र-ऑपरेशन फ़ीचर में लागू किए हैं। आगे, कंपनी मूल्यांकन फ़ीचर में परीक्षण शामिल करने की योजना बना रही है, ताकि ग्राहक और आंतरिक टीमें अलग-अलग सेटिंग के हिसाब से लागत, रन का समय और जवाबों की गुणवत्ता की तुलना कर सकें।

コメント