
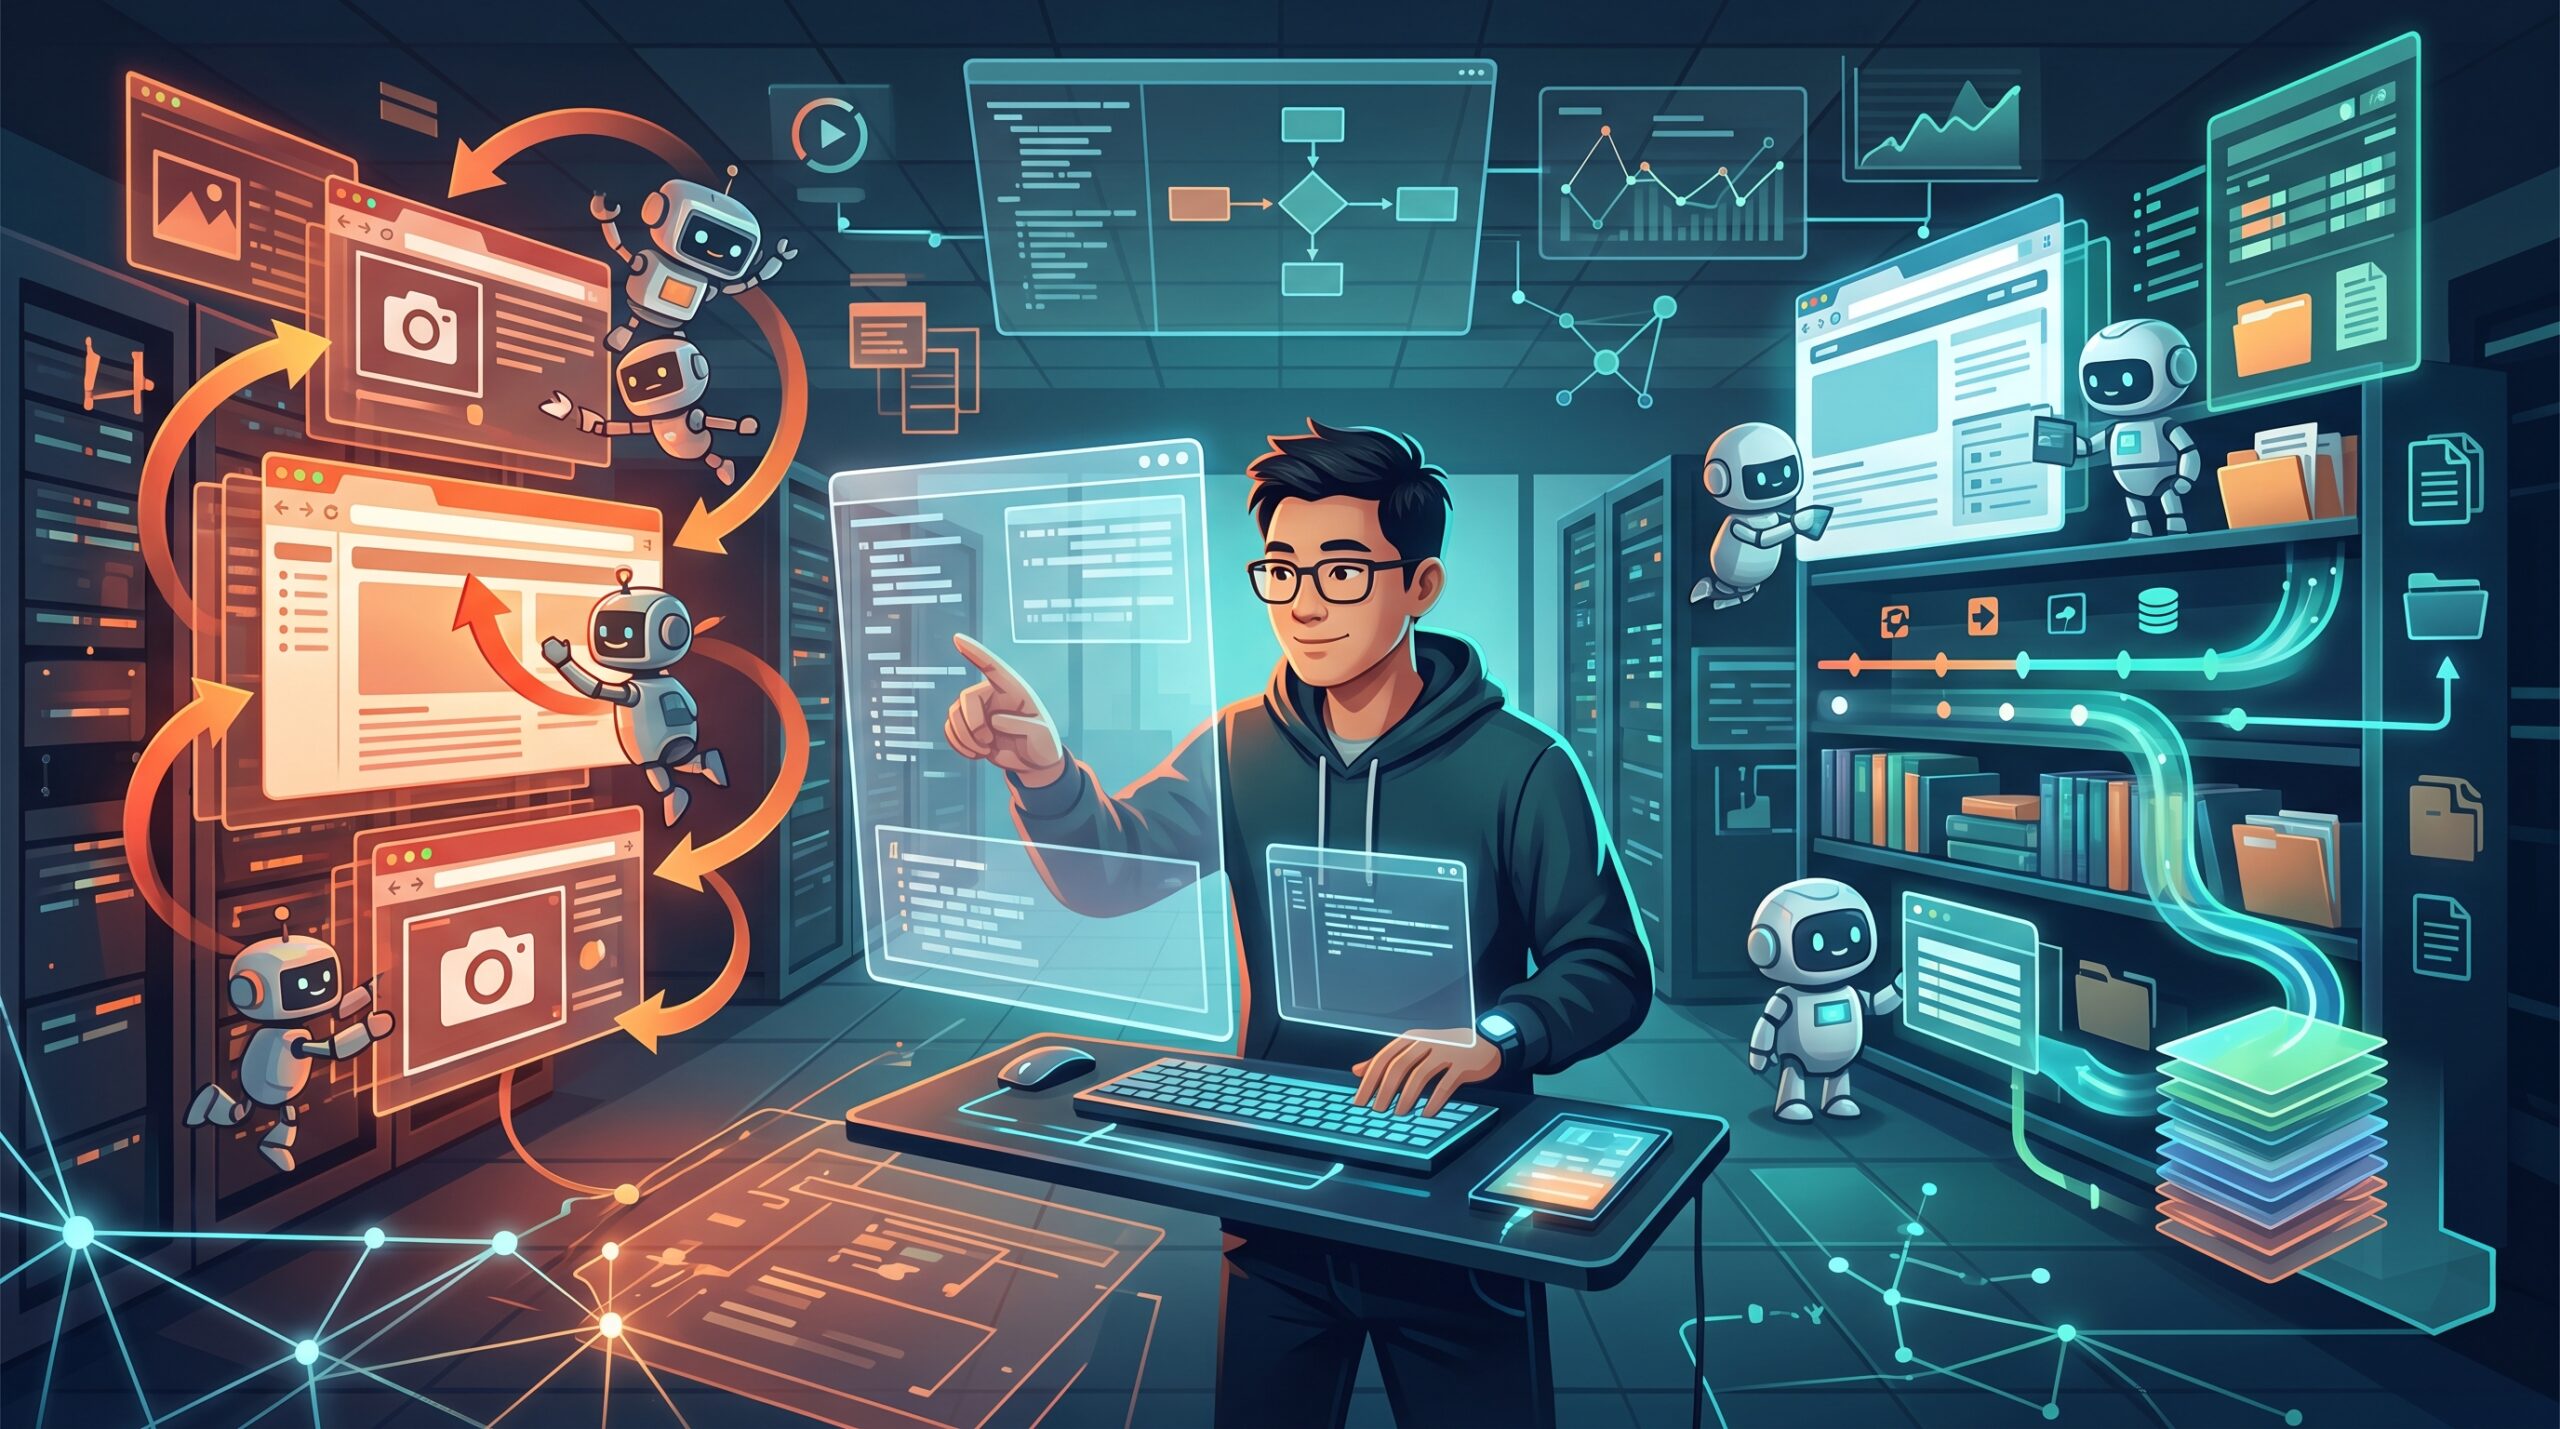
Asana 表示,在驗證 StackAI 的瀏覽器操作自動化 AI 時,與原有的正式環境配置相比,預估模型成本降至 1/76,處理速度則提升 5 倍。在採用 GPT‑6.1 Sol 並最佳化瀏覽紀錄管理的配置下,每次處理平均花費 0.47 美元,約需 4 分鐘。
成本降至 1/76,不只是更換模型的成果
這組數據值得注意之處,在於比較的不是單一模型的效能,而是模型與處理機制搭配後的整體成果。瀏覽器代理是能讀取網頁,並執行蒐集資訊、填寫表單等工作的 AI。Asana 透過收購的 StackAI,提供這類工作的自動化服務。
這次驗證從公開的示範目錄中挑選 32 本書籍,分別蒐集 6 項資訊。研究團隊以 4 種模型和多種設定進行了共 144 次測試。最初使用的模型 B,每次處理的預估模型成本至少為 36.21 美元;但光是重新檢視處理機制,就將費用降至 1.24 美元。再採用 GPT‑6.1 Sol 的最佳化配置後,費用進一步降至 0.47 美元。
換句話說,即使維持使用模型 B,也能將成本降至約 1/29。1/76 這個標題數字背後,模型選擇之前的處理設計改善,發揮了重要作用。
節省成本的關鍵,是提供給 AI 的瀏覽紀錄
原有配置會快取固定指示等內容,但不包括逐步累積的網頁正文和螢幕截圖紀錄。快取是一種重複利用已處理輸入的機制。如果無法重複利用紀錄,每次呼叫 AI 時都得重新傳送過去的資訊,並支付相應費用。
此外,系統幾乎每個步驟都會刪除舊圖片,並縮短文字。由於紀錄經常改寫,即使導入快取也很難發揮效果。刪除太多資訊,也可能導致系統重新造訪已讀過的網頁。
因此,Asana 將紀錄保留上限從 12 萬字提高到 48 萬字,並將瀏覽紀錄納入快取。螢幕截圖則改為累積至 20 張後,只保留最新一張。這樣一來,不必每次都整理,而是集中整理,延長了能在不修改既有紀錄的情況下重複使用的時間。
保留更多資訊,成本也能降低
減少提供給 AI 的資訊,就能降低成本。這次的結果顯示,單靠這種想法,無法解釋代理系統的成本。有時保留資訊並加以重複利用、減少不必要的再次確認,反而能降低整體處理成本。
在 GPT‑6.1 Sol 的測試中,擴大紀錄保留上限後,重新調整快取和圖片管理方式,讓每次處理的預估模型成本從 1.97 美元降至 0.47 美元。最佳化後,89% 的輸入由快取提供,而這部分的費用僅為不使用快取時的 5%。
紀錄量也會影響任務能否完成。GPT‑6.1 Sol 在較小的保留上限下,18 次執行中有 3 次能產生答案;在較大的上限下,18 次全都能產生答案。驗證結果顯示,這 18 次都得到了正確答案。
改善方案的測試也運用了 AI
除了實際操作瀏覽器的 GPT‑6.1 Sol,調查與改善工作也使用了 Codex 的 GPT‑6 Astra。它檢查程式碼結構、找出紀錄管理上的問題,並重新整理實驗用程式碼,以平行方式驗證多種設定。
這並不代表過程中沒有人參與。StackAI 技術長 Frank Hidalgo 檢視提案,並選出要驗證的修改方案。實驗紀錄和輸出也由其他模型工作階段審查,並保存在 Asana 的開發平台 Command 中。變更經過工單和提取要求後,才部署至正式環境。
Hidalgo 表示,若由人工作業,估計需花 1 至 2 個月的調查工作,約一週就完成了。這段時間差是與他的估計相比,並非將同一項工作交由人類單獨完成的對照實驗結果。
評估是否導入時,應一併考量成本與完成率
這次的 0.47 美元是預估模型成本,不包括人事費用或系統營運費等總成本。此外,部分比較基準達到處理次數上限後仍未完成,因此 36.21 美元以上、22.5 分鐘以上都是下限。主要比較數值是各配置執行 3 次的平均值,並不代表所有網路工作都能達到相同的成本降幅。
在最佳化配置之間比較,模型 C 的成本為 0.66 美元、耗時 3.5 分鐘;GPT‑6.1 Sol 則為 0.47 美元、約 4 分鐘。在這項任務中,Sol 的成本較低,但模型 C 的執行時間較短,兩者在成本與速度上的排名並不相同。
Asana 已將這次的變更套用至 StackAI 的瀏覽器操作功能。未來,公司計畫將驗證功能整合至平台,讓客戶和內部團隊能比較不同設定的成本、執行時間及答案品質。

コメント