
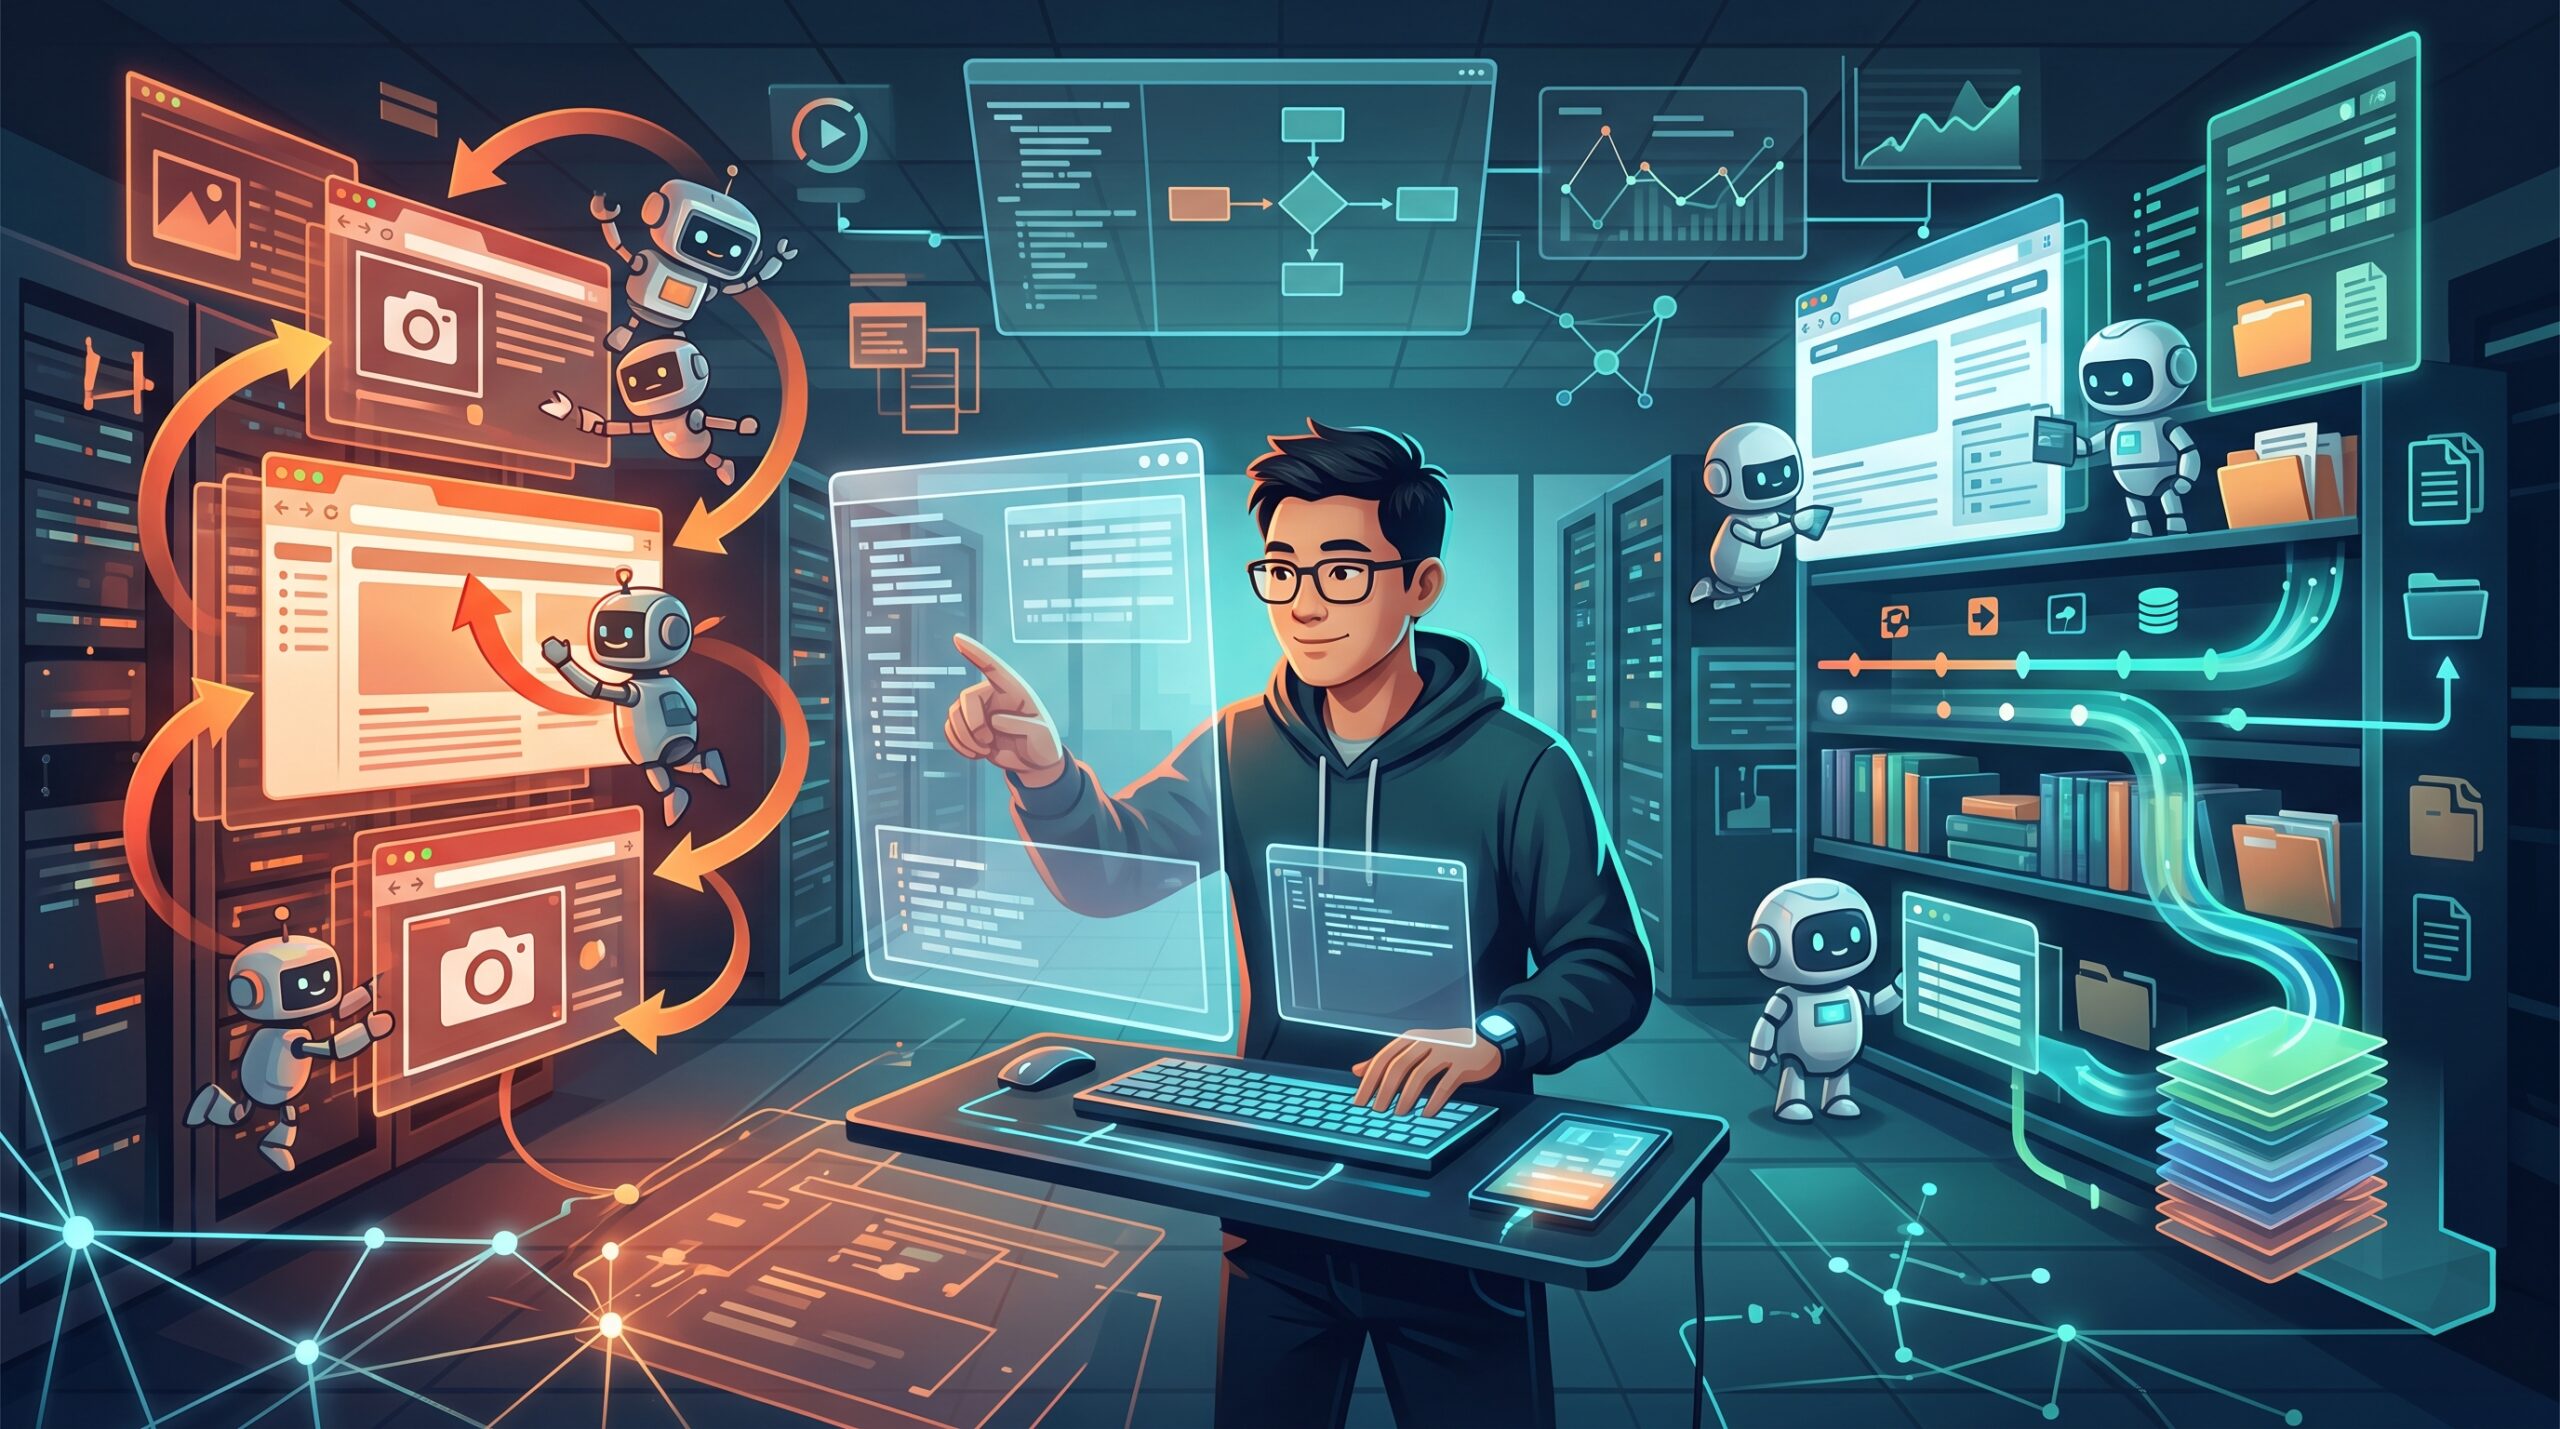
Asana teilte mit, dass das Unternehmen bei Tests der browsersteuernden KI von StackAI die geschätzten Modellkosten im Vergleich zur bisherigen Produktivkonfiguration auf ein Sechsundsiebzigstel senken und die Verarbeitung fünfmal so schnell machen konnte. In einer optimierten Konfiguration mit GPT‑6.1 Sol und verbessertem Management des Browserverlaufs dauerte eine Ausführung durchschnittlich etwa vier Minuten und kostete 0,47 Dollar.
Die Kosten sanken nicht allein durch einen Modellwechsel auf ein Sechsundsiebzigstel
Wichtig bei diesen Zahlen ist, dass sie nicht die Leistung eines einzelnen Modells abbilden, sondern das Ergebnis aus dem Zusammenspiel von Modell und Verarbeitungsablauf. Ein Browser-Agent ist eine KI, die Webseiten liest und Aufgaben wie das Sammeln von Informationen oder das Ausfüllen von Formularen erledigt. Asana bietet solche Automatisierungen über das übernommene Unternehmen StackAI an.
Bei den Tests wurden für 32 Bücher aus einem öffentlichen Demo-Katalog jeweils sechs Informationen gesammelt. Vier Modelle und mehrere Konfigurationen wurden insgesamt 144-mal getestet. Beim ursprünglich verwendeten Modell B lagen die geschätzten Modellkosten pro Ausführung bei mindestens 36,21 Dollar. Allein durch eine Überarbeitung des Verarbeitungsablaufs sanken sie auf 1,24 Dollar. In einer weiter optimierten Konfiguration mit GPT‑6.1 Sol lagen sie schließlich bei 0,47 Dollar.
Das bedeutet, dass sich die Kosten auch mit Modell B auf etwa ein Neunundzwanzigstel senken ließen. Hinter der Schlagzeile vom Sechsundsiebzigstel steht vor allem eine Verbesserung des Verarbeitungsdesigns, die bereits vor der Modellauswahl eine große Rolle spielte.
Der Schlüssel zur Einsparung war der an die KI übergebene Browserverlauf
In der bisherigen Konfiguration waren feste Anweisungen und ähnliche Eingaben zwar zwischengespeichert, die fortlaufend gesammelten Webseiteninhalte und Screenshots im Verlauf jedoch nicht. Ein Cache ist ein Mechanismus, mit dem bereits verarbeitete Eingaben wiederverwendet werden. Lässt sich der Verlauf nicht wiederverwenden, müssen bei jedem Aufruf der KI frühere Informationen erneut übermittelt werden – und verursachen entsprechende Kosten.
Zudem wurden in fast jedem Schritt alte Bilder gelöscht und Texte gekürzt. Weil der Verlauf dadurch ständig verändert wurde, ließ sich mit der bloßen Einführung eines Caches kaum etwas erreichen. Werden zu viele Informationen gelöscht, kann das außerdem dazu führen, dass bereits gelesene Seiten erneut aufgerufen werden.
Deshalb wurde die Grenze für den gespeicherten Verlauf von 120.000 auf 480.000 Zeichen erhöht und der Browserverlauf ebenfalls in den Cache aufgenommen. Screenshots werden nun bis zu einer Zahl von 20 gesammelt; anschließend bleibt nur der neueste erhalten. Statt den Verlauf jedes Mal zu bereinigen, wird dies gebündelt erledigt. So kann er länger unverändert wiederverwendet werden.
Auch das Beibehalten zusätzlicher Informationen kann Kosten senken
Weniger Informationen an die KI zu übergeben, senkt die Kosten. Die Ergebnisse zeigen jedoch, dass dieser Gedanke allein die Kosten von Agenten nicht erklären kann. Es kann insgesamt günstiger sein, Informationen zu speichern und wiederzuverwenden, statt unnötige Prüfungen zu wiederholen.
Bei GPT‑6.1 Sol sanken die geschätzten Modellkosten pro Ausführung von 1,97 auf 0,47 Dollar, nachdem Cache und Bildverwaltung bei erhöhter Grenze für den gespeicherten Verlauf überarbeitet worden waren. Nach der Optimierung stammten 89 Prozent der Eingaben aus dem Cache; für diesen Anteil fielen nur fünf Prozent der Kosten an, die ohne Cache entstanden wären.
Der Umfang des gespeicherten Verlaufs wirkte sich auch darauf aus, ob die Aufgabe abgeschlossen wurde. Mit GPT‑6.1 Sol konnten bei einer niedrigeren Speichergrenze nur drei von 18 Ausführungen eine Antwort erzeugen; bei einer höheren Grenze gelang dies bei allen 18. In den Tests waren alle 18 Antworten korrekt.
Auch beim Testen von Verbesserungsvorschlägen kam KI zum Einsatz
Für Untersuchung und Optimierung kam neben GPT‑6.1 Sol, das den Browser tatsächlich bediente, GPT‑6 Astra von Codex zum Einsatz. Das Modell untersuchte die Code-Struktur, ermittelte Probleme bei der Verlaufsverwaltung, baute den Code für Experimente um und testete mehrere Konfigurationen parallel.
Das bedeutet nicht, dass keine Menschen beteiligt waren. Frank Hidalgo, CTO von StackAI, prüfte die Vorschläge und wählte die zu testenden Änderungen aus. Die Versuchsprotokolle und Ausgaben wurden auch in separaten Modellsitzungen überprüft und in Asanas Entwicklungsplattform Command festgehalten. Die Änderungen gelangten über Tickets und Pull Requests in die Produktivumgebung.
Hidalgo zufolge dauerte die Untersuchung etwa eine Woche, obwohl sie nach seiner Einschätzung bei manueller Arbeit ein bis zwei Monate in Anspruch genommen hätte. Der Zeitvergleich beruht auf seiner Schätzung und nicht auf einem Kontrollversuch, bei dem dieselbe Arbeit ausschließlich von Menschen erledigt wurde.
Bei der Entscheidung über den Einsatz sollten Kosten und Abschlussquote gemeinsam betrachtet werden
Die 0,47 Dollar beziehen sich auf die geschätzten Modellkosten und nicht auf die Gesamtkosten einschließlich Personalkosten und Systembetrieb. Außerdem erreichten einige der Vergleichskonfigurationen die Obergrenze für die Zahl der Verarbeitungsschritte, bevor sie abgeschlossen waren. Die Werte von mindestens 36,21 Dollar und mindestens 22,5 Minuten sind daher Untergrenzen. Die wichtigsten Vergleichswerte sind Durchschnittswerte aus jeweils drei Ausführungen pro Konfiguration; die gleiche Einsparungsquote lässt sich nicht auf alle Arten von Webaufgaben übertragen.
Bei den optimierten Konfigurationen kostete Modell C 0,66 Dollar und benötigte 3,5 Minuten; GPT‑6.1 Sol kostete 0,47 Dollar und brauchte etwa vier Minuten. Bei dieser Aufgabe war Sol also günstiger, während Modell C schneller war – bei Kosten und Geschwindigkeit ergibt sich damit eine unterschiedliche Rangfolge.
Asana hat die Änderungen in die Browsersteuerungsfunktion von StackAI übernommen. Künftig soll die Evaluierungsfunktion der Plattform um solche Tests erweitert werden, damit Kunden und interne Teams Kosten, Laufzeit und Antwortqualität verschiedener Konfigurationen vergleichen können.

コメント