
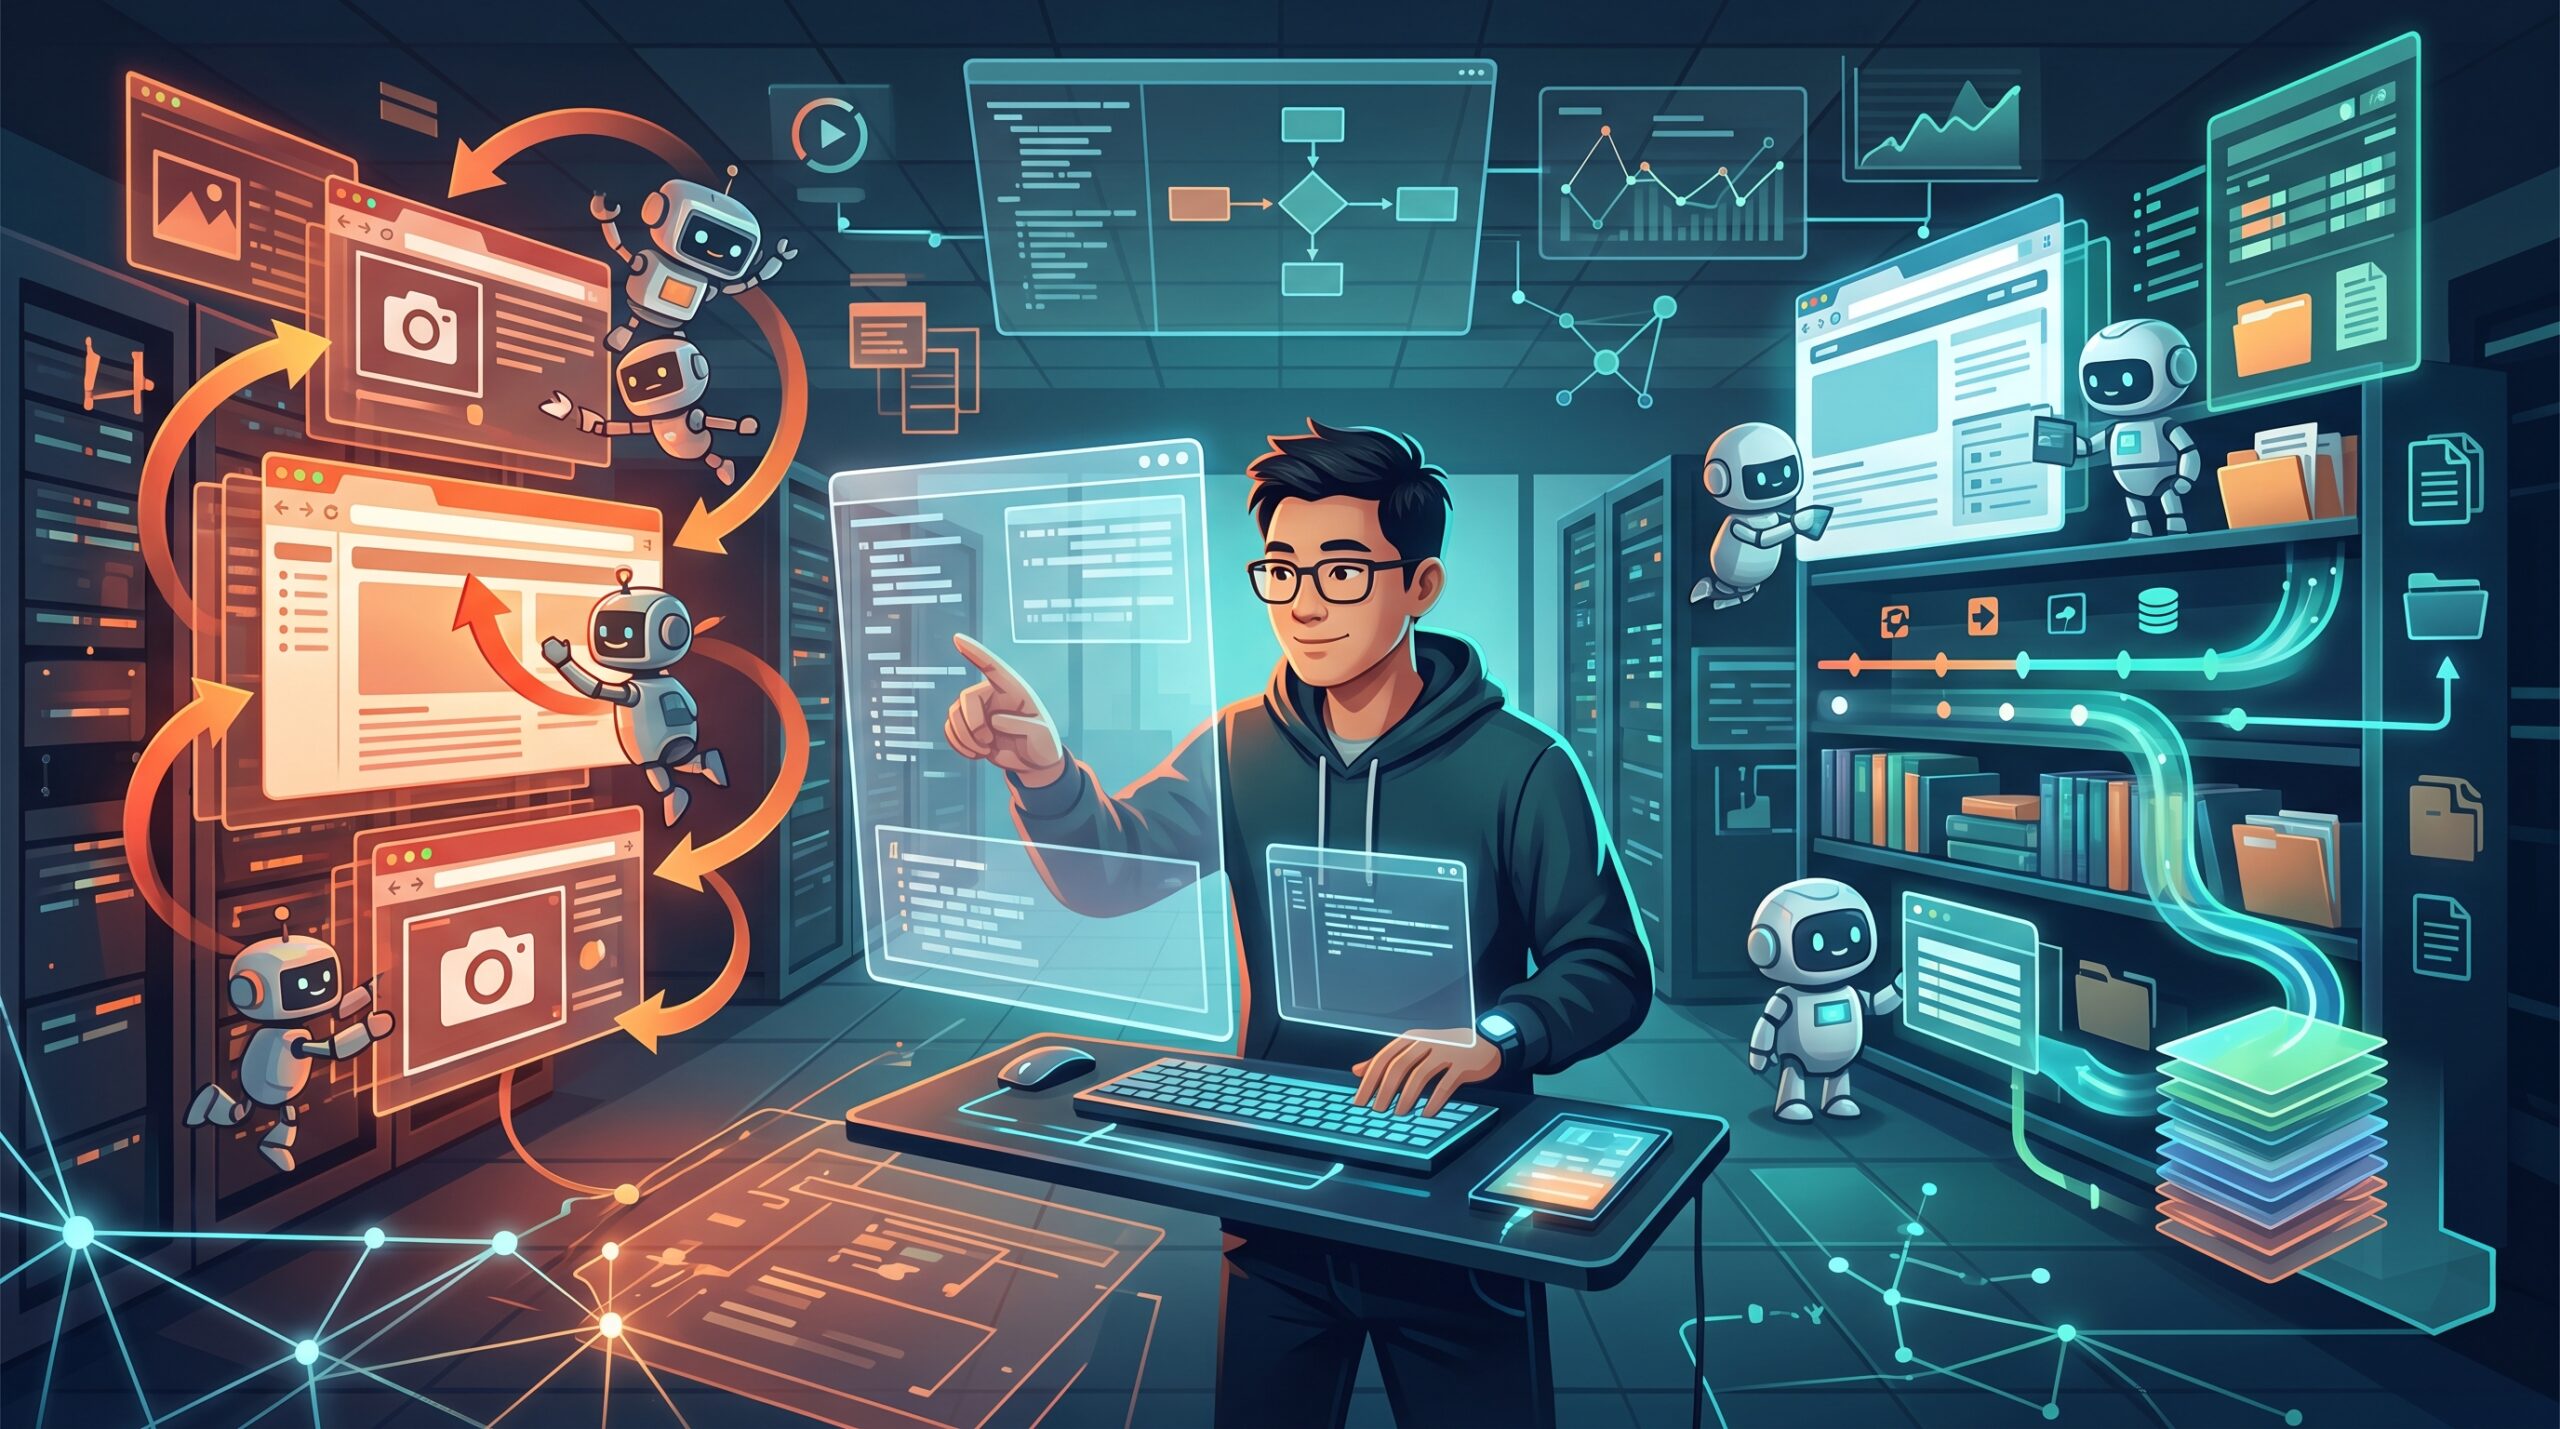
Asana mengumumkan bahwa dalam pengujian AI untuk mengotomatisasi operasi browser StackAI, mereka berhasil menurunkan estimasi biaya model menjadi 1/76 dibandingkan konfigurasi produksi sebelumnya, sekaligus membuat pemrosesan lima kali lebih cepat. Dengan konfigurasi GPT‑6.1 Sol yang dioptimalkan untuk mengelola riwayat penelusuran, rata-rata satu kali pemrosesan memakan biaya 0,47 dolar dan waktu sekitar 4 menit.
Penurunan biaya menjadi 1/76 bukan semata-mata karena mengganti model
Hal penting dari angka ini adalah bahwa yang dibandingkan bukan kinerja model secara terpisah, melainkan hasil dari kombinasi model dan cara pemrosesan. Agen browser adalah AI yang membaca halaman web dan menjalankan tugas seperti mengumpulkan informasi atau mengisi formulir. Melalui StackAI, perusahaan yang diakuisisinya, Asana menyediakan otomatisasi untuk tugas-tugas semacam ini.
Dalam pengujian, informasi dari enam kategori dikumpulkan untuk masing-masing dari 32 buku di katalog demo publik. Empat model dan sejumlah konfigurasi diuji sebanyak 144 kali. Dengan Model B yang digunakan pada awalnya, estimasi biaya model untuk satu kali pemrosesan mencapai setidaknya 36,21 dolar. Namun, hanya dengan meninjau ulang cara pemrosesan, biaya itu turun menjadi 1,24 dolar. Pada konfigurasi yang dioptimalkan dengan GPT‑6.1 Sol, biayanya turun lagi menjadi 0,47 dolar.
Artinya, biaya bisa ditekan hingga sekitar 1/29 meski tetap menggunakan Model B. Di balik angka 1/76 pada judul, perbaikan desain pemrosesan sebelum memilih model memainkan peran besar.
Kunci penghematan adalah riwayat penelusuran yang diberikan kepada AI
Dalam konfigurasi sebelumnya, instruksi tetap dan informasi sejenis memang di-cache, tetapi isi halaman dan riwayat tangkapan layar yang terus bertambah tidak. Cache adalah mekanisme untuk menggunakan kembali masukan yang sudah diproses. Jika riwayat tidak dapat digunakan kembali, setiap kali AI dipanggil, informasi sebelumnya harus dikirim ulang dan menimbulkan biaya tambahan.
Selain itu, gambar lama dihapus dan teks dipersingkat hampir pada setiap langkah. Karena riwayat sering berubah, menambahkan cache saja tidak banyak membantu. Menghapus terlalu banyak informasi juga dapat menyebabkan AI mengunjungi kembali halaman yang sudah dibaca.
Karena itu, batas penyimpanan riwayat ditingkatkan dari 120.000 menjadi 480.000 karakter, dan riwayat penelusuran juga dimasukkan ke dalam cache. Tangkapan layar dikumpulkan hingga 20 gambar, lalu hanya gambar terbaru yang dipertahankan. Dengan merapikan riwayat sekaligus, alih-alih melakukannya setiap kali, mereka memperpanjang waktu penggunaan riwayat sebelumnya tanpa mengubahnya.
Biaya bisa turun meski lebih banyak informasi disimpan
Mengurangi informasi yang diberikan kepada AI akan membuatnya lebih murah. Hasil ini menunjukkan bahwa cara berpikir tersebut saja tidak cukup untuk menjelaskan biaya agen. Dalam beberapa kasus, menyimpan dan menggunakan kembali informasi serta mengurangi pemeriksaan ulang yang tidak perlu justru dapat menekan biaya pemrosesan secara keseluruhan.
Pada GPT‑6.1 Sol, setelah batas penyimpanan riwayat diperluas, peninjauan ulang cache dan pengelolaan gambar menurunkan estimasi biaya model per pemrosesan dari 1,97 dolar menjadi 0,47 dolar. Setelah optimasi, 89% masukan dipasok dari cache, dan biaya untuk bagian tersebut hanya 5% dibandingkan jika cache tidak digunakan.
Jumlah riwayat juga memengaruhi penyelesaian tugas. Dengan GPT‑6.1 Sol, jawaban berhasil dihasilkan dalam 3 dari 18 eksekusi saat batas penyimpanan lebih kecil, tetapi dalam semua 18 eksekusi saat batasnya lebih besar. Seluruh 18 eksekusi dalam pengujian menghasilkan jawaban yang benar.
AI juga digunakan untuk menguji usulan perbaikan
Selain GPT‑6.1 Sol yang mengoperasikan browser, GPT‑6 Astra dari Codex digunakan untuk penelitian dan perbaikan. Model ini memeriksa struktur kode, mengidentifikasi masalah dalam pengelolaan riwayat, menyusun ulang kode untuk keperluan eksperimen, dan menguji berbagai konfigurasi secara paralel.
Bukan berarti manusia tidak terlibat. Frank Hidalgo, CTO StackAI, meninjau usulan dan memilih perubahan yang akan diuji. Catatan eksperimen dan keluarannya juga ditinjau dalam sesi model terpisah, lalu disimpan di Command, platform pengembangan Asana. Perubahan diterapkan ke lingkungan produksi melalui tiket dan pull request.
Hidalgo mengatakan bahwa penelitian yang menurut perkiraannya akan memakan waktu 1–2 bulan jika dilakukan secara manual selesai dalam sekitar satu minggu. Perbandingan durasi ini didasarkan pada perkiraannya, bukan hasil eksperimen terkontrol yang membandingkan pekerjaan serupa yang dilakukan manusia saja.
Pertimbangkan biaya dan tingkat penyelesaian secara bersamaan saat memutuskan penerapan
Angka 0,47 dolar kali ini adalah estimasi biaya model, bukan total biaya yang mencakup tenaga kerja atau biaya operasional sistem. Selain itu, sebagian konfigurasi pembanding belum selesai karena mencapai batas jumlah pemrosesan. Karena itu, nilai setidaknya 36,21 dolar dan lebih dari 22,5 menit merupakan batas bawah. Angka pembanding utama adalah rata-rata dari tiga kali pengujian untuk setiap konfigurasi, dan tingkat penghematan yang sama tidak dapat diterapkan pada semua jenis pekerjaan web.
Di antara konfigurasi yang sama-sama telah dioptimalkan, Model C memerlukan biaya 0,66 dolar dan waktu 3,5 menit, sedangkan GPT‑6.1 Sol memerlukan biaya 0,47 dolar dan waktu sekitar 4 menit. Dalam tugas ini, Sol lebih murah, tetapi Model C lebih cepat, sehingga urutan keduanya berbeda dalam hal biaya dan kecepatan.
Asana telah menerapkan perubahan ini pada fitur operasi browser StackAI. Ke depannya, perusahaan berencana mengintegrasikan pengujian ke dalam fitur evaluasi platform agar pelanggan dan tim internal dapat membandingkan biaya, waktu eksekusi, serta kualitas jawaban untuk setiap konfigurasi.

コメント